新品速递

每秒9600兆次传输!美光SOCAMM2内存模组细节曝光,AI芯片战争再升级

发布时间:2025-10-28 00:00:00 责任编辑:lina

【导读】美光科技近期宣布,其192GB SOCAMM2内存模组已正式向客户送样,旨在将低功耗内存在AI数据中心的应用推向新高度。这款新品在性能与能效上实现显著突破:传输速度高达9600MT/s,在相同紧凑尺寸下容量较前代提升50%,且在DRAM裸片级别能效提升超过20%,为大规模AI计算提供了强有力的硬件支持。
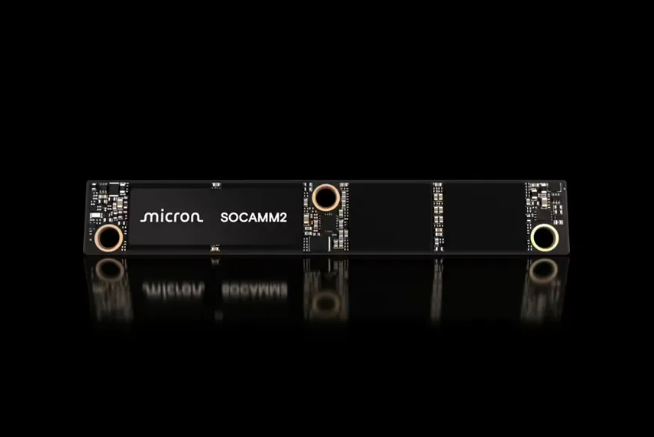

美光科技近期宣布,其192GB SOCAMM2内存模组已正式向客户送样,旨在将低功耗内存在AI数据中心的应用推向新高度。这款新品在性能与能效上实现显著突破:传输速度高达9600MT/s,在相同紧凑尺寸下容量较前代提升50%,且在DRAM裸片级别能效提升超过20%,为大规模AI计算提供了强有力的硬件支持。


每秒9600兆次传输!美光SOCAMM2内存模组细节曝光,AI芯片战争再升级


一、技术升级:性能跃升,延迟骤降


SOCAMM2基于美光先进的1γ(1-gamma)制程技术打造,实现了容量与能效的同步优化。其在AI工作负载中的表现尤为亮眼,可将实时推理任务中的首Token生成时间(TTFT)缩短80%以上,这意味着AI应用(如聊天机器人或图像生成)的初始响应速度得到大幅提升,用户体验更加流畅。


模块化设计增强了其可维护性,并为未来的容量升级预留了空间。在系统层面,例如在Vera Rubin NVL144机架系统中,SOCAMM2可支持构建超过40TB的CPU直连低功耗主内存,为庞大AI模型的高效运行奠定了基础。


二、AI数据中心:低功耗与高带宽的完美融合


SOCAMM2的成功离不开美光与英伟达长达五年的紧密合作,双方共同将原本主要用于移动设备的LPDDR5X内存技术引入了数据中心领域。此举使得SOCAMM2同时具备了超低功耗和高带宽两大优势。

与传统的RDIMM内存相比,SOCAMM2在提供更高带宽的同时,能耗降低了三分之二以上,物理尺寸也仅为后者的三分之一。这种高密度、低功耗的特性,不仅显著优化了数据中心的空间利用率和电力成本,也使其更易于融入先进的液冷散热系统,顺应了绿色数据中心的发展趋势。


三、市场竞争:新内存战局已然开启


SOCAMM2的推出,标志着在HBM(高带宽内存)之后,一个新的服务器内存战场正在形成。据透露,英伟达在2025年计划采购高达80万个SOCAMM单元。


目前,美光在竞争中似乎处于领先地位,已开始为英伟达生产SOCAMM模块。而三星和SK海力士也正积极布局,三星已开始开发SOCAMM2,SK海力士则在其AI内存解决方案中展示了SOCAMM技术。此外,中国存储企业江波龙也已推出自有SOCAMM2产品,显示出该技术领域的广泛关注和竞争态势。


四、未来展望:重塑AI数据中心内存架构


美光高级副总裁兼云存储业务部门总经理Raj Narasimhan表示,SOCAMM2旨在满足新一代大型AI系统的算力需求,为AI训练与推理系统树立新的能效标杆。


随着AI服务器需求的持续爆发,以及对数据中心能耗要求的日益苛刻,兼具高性能与低功耗特性的SOCAMM2,有望在未来几年成为高端AI平台的核心内存组件之一,驱动AI基础设施向着更高效、更绿色的方向演进。

https://www.52solution.com/kb


推荐阅读:

苹果豪掷千亿订单!三星独供1300万颗LPDDR5X芯片,iPhone 18内存全面升级

透视被动元件产业:日系霸守高端,中国“隐形冠军”崭露头角

PC市场要变天!英特尔Panther Lake处理器引爆AI换机潮

AI的“胃口”有多大?三星、SK海力士存储芯片涨价高达30%,HBM成幕后推手

DRAM缺货冲击波:板卡行业遭遇“最旺淡季”


为您推荐

亿铸科技发布通用存算一体三大定律 3D DRAM存算一体芯片实现规模化商用突破 业界新闻

亿铸科技发布通用存算一体三大定律 3D DRAM存算一体芯片实现规模化商用突破

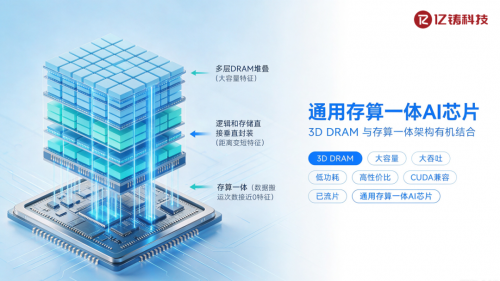
2026世界人工智能大会期间,国产算力技术迭代迎来关键突破。针对后摩尔时代AI算力普遍存在的高功耗、高延迟、高成本及通用性不足等行业难题,亿铸科技在「重构算力」产业链论坛上,正式发布通用存算一体三大行业定律,同步公开全数字3D DRAM通用存算一体AI芯片的完整技术架构、核心优势与商业化落地成果。企业凭借差异化的3D DRAM工艺与全数字架构路线,破解了传统算力架构及早期存算方案的诸多短板,凭借极致的能效与成本优势,为大模型推理、云端算力集群等核心场景提供了自主可控的国产算力解决方案,有效推动国内通用存算

电源管理 内存

异构内存架构升级,瑞苏盈科 IAE50 赋能边缘 AI 新品速递

异构内存架构升级,瑞苏盈科 IAE50 赋能边缘 AI

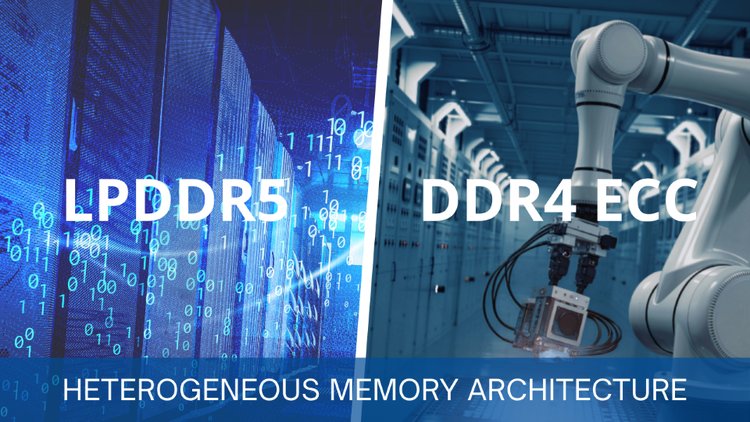
当下边缘嵌入式系统的性能瓶颈,早已不再局限于算力本身,内存带宽争用、功耗过高、实时性不稳定、系统可靠性不足等问题,成为制约机器视觉、边缘AI、工业自动化、高端测量设备升级的核心痛点。针对行业普遍存在的单内存架构资源冲突难题,瑞苏盈科(Enclustra)推出基于Agilex 5 E-Series SoC的Andromeda IAE50嵌入式SoM模块。产品创新采用DDR4 ECC+双通道LPDDR5异构分离式内存架构,将系统控制与高吞吐数据处理负载物理分区,兼顾系统安全可靠、极致带宽性能与超低功耗表现,为高实时、高带宽、高可靠的边缘嵌入式应用提供全新硬件解决方案。

电源管理 测试测量 内存 Enclustra

Altera 全面扩展 Agilex® FPGA 产品家族 DDR5 内存支持 选型指南

Altera 全面扩展 Agilex® FPGA 产品家族 DDR5 内存支持

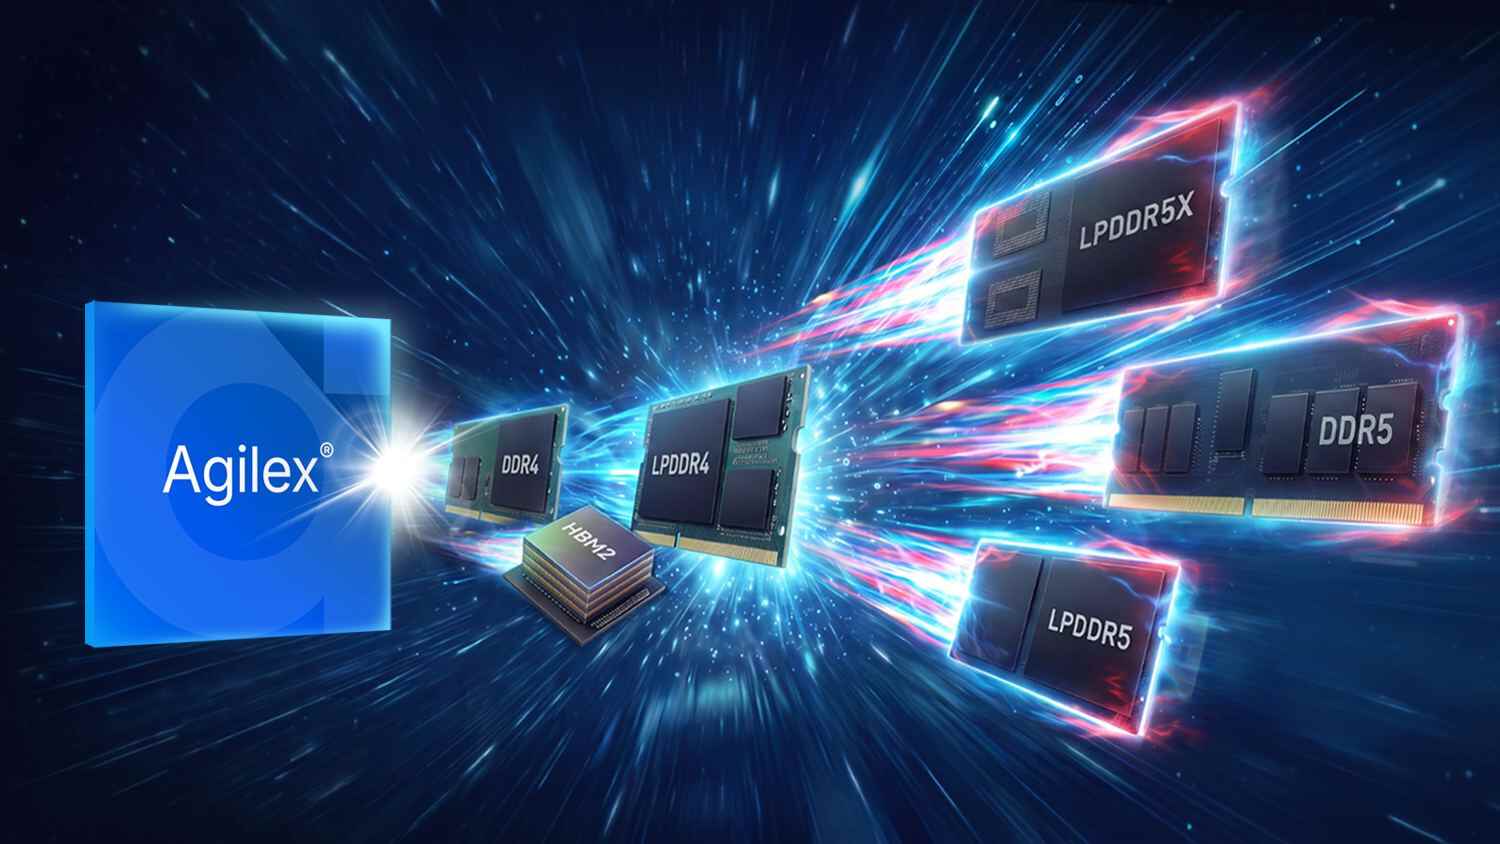
近日,全球最大专注于FPGA解决方案的提供商Altera宣布,随着Quartus® Prime专业版软件26.1.1版本的发布,其Agilex® FPGA全产品系列已全面扩展对DDR5内存的支持。本次更新为更多Agilex® FPGA产品新增了对DDR5、LPDDR5及LPDDR5X内存的兼容能力,可助力开发者构建更高性能的AI、网络和嵌入式系统,并在优化带宽、功耗、板卡空间及产品供货保障方面,提供更高的灵活性。

电源管理 互联技术 内存

Altera 全面扩展 Agilex® FPGA 产品家族 DDR5 内存支持 业界新闻

Altera 全面扩展 Agilex® FPGA 产品家族 DDR5 内存支持

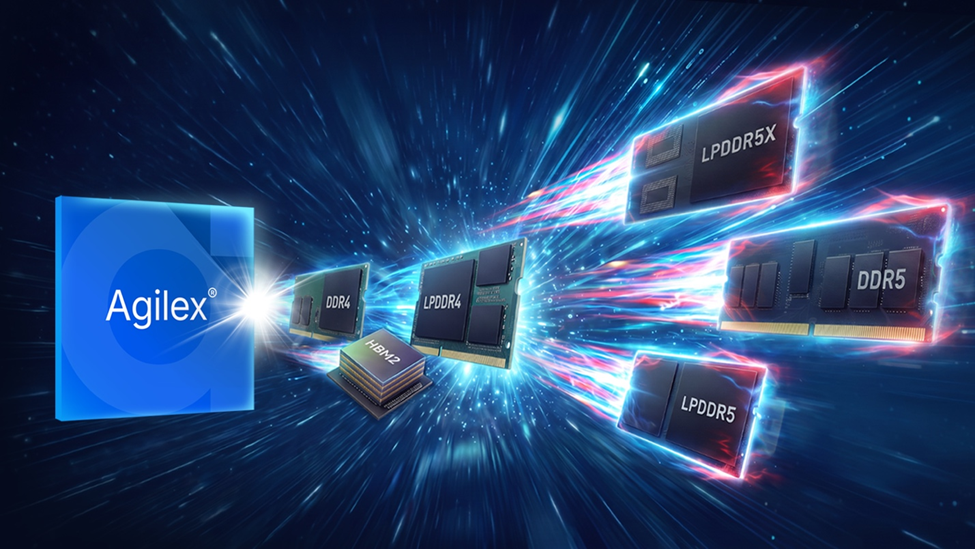
近日,全球最大专注于FPGA解决方案的提供商Altera宣布,随着Quartus® Prime专业版软件26.1.1版本的发布,其Agilex® FPGA全产品系列已全面扩展对DDR5内存的支持。本次更新为更多Agilex® FPGA产品新增了对DDR5、LPDDR5及LPDDR5X内存的兼容能力,可助力开发者构建更高性能的AI、网络和嵌入式系统,并在优化带宽、功耗、板卡空间及产品供货保障方面,提供更高的灵活性。

电源管理 互联技术 内存

告别内存溢出:利用专有压缩技术让大型模型跑通低功耗MCU 技术应用

告别内存溢出:利用专有压缩技术让大型模型跑通低功耗MCU

随着神经网络在解决复杂机器学习问题中展现出卓越能力,其日益增长的模型规模与计算复杂度也成为了落地应用的主要瓶颈。特别是在资源极其受限的嵌入式系统(如低功耗MCU)上,巨大的内存占用(ROM)和高昂的运算量(MACs/FLOPs)往往使得高性能模型难以部署。如何在严格保持模型精度的前提下,大幅压缩模型体积并降低推理成本,成为连接先进算法与边缘硬件的关键挑战。本文将深入探讨神经网络模型压缩的核心原理,同时介绍Reality AI Tools®如何让这一复杂的压缩过程变得自动化且对用户透明。

电源管理 内存

特别推荐

更多

行业动态

更多

技术应用

更多

选型替代

更多

产品信息

更多

热门搜索

更多

欢迎登录

没有账号,

账号注册

注册成功!

3S后自动为你跳转登陆