 业界新闻
20万签名力挺黄仁勋回归!英伟达Q3营收创新高,数据中心增长1.1倍
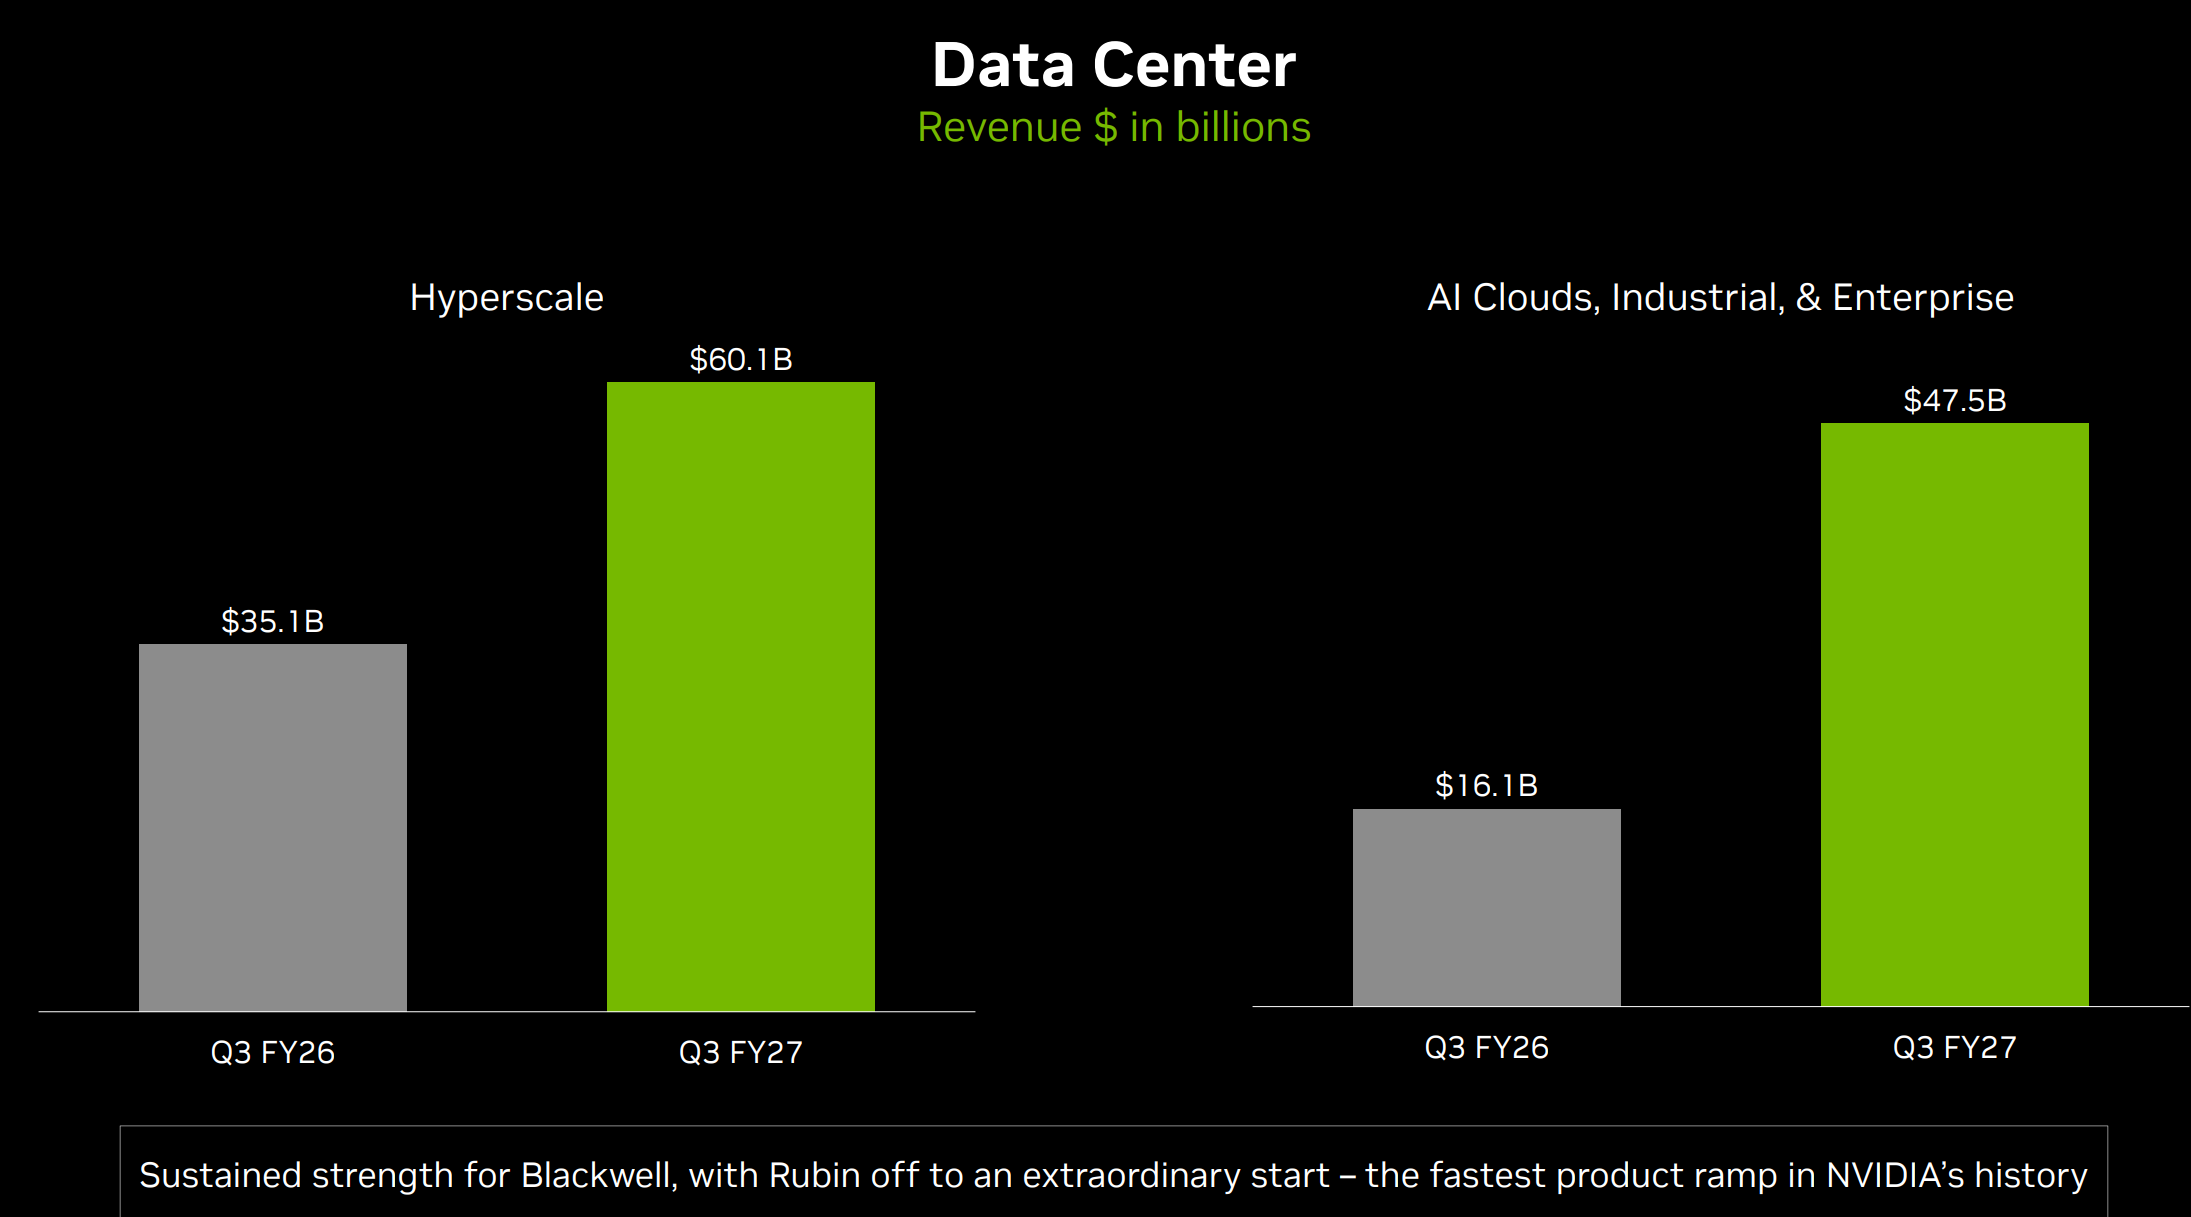
11月18日,英伟达发布2027 财年第三季度(截至 2026 年 7 月 26 日),本季度营收 1158亿美元,环比增长20%,同比增长103%,净利润653亿美元,同比增长105%。 其中,数据中心收入达到1076亿美元,同比增长110%。公司的增长主要来自于数据中心业务,体现出人工智能相关的计算需求,继续支撑着它的业绩表现。

新品速递
发布时间:2025-10-31 00:00:00 责任编辑:lina
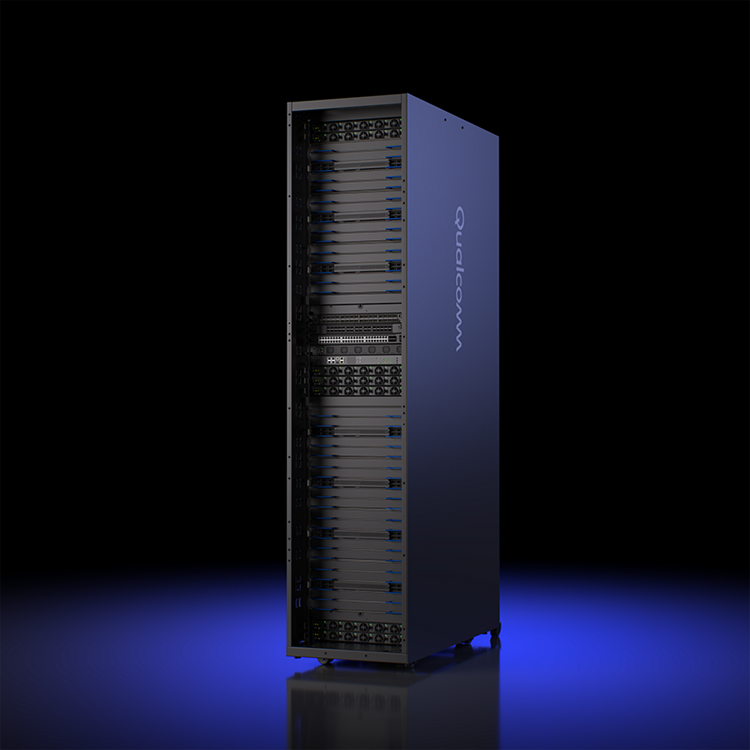
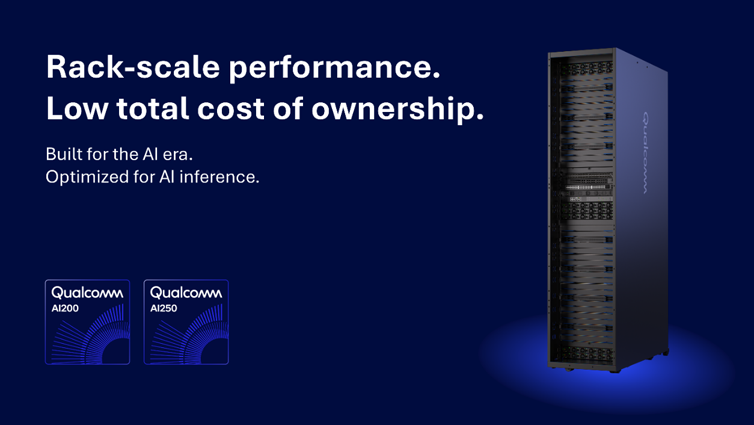
【导读】在生成式AI浪潮席卷全球的背景下,数据中心AI推理市场正迎来一位强有力的竞争者。2025年10月,高通技术公司正式宣布推出基于Qualcomm AI200与AI250芯片的加速卡及机架系统,标志着这家移动芯片巨头强势进军数据中心AI推理市场。新一代解决方案依托高通在NPU技术领域的深厚积累,专注于为大语言模型(LLM)与多模态模型(LMM)推理工作负载提供机架级性能与卓越的内存容量,以业界先进的总体拥有成本(TCO) 为客户带来突破性的价值主张。
在生成式AI浪潮席卷全球的背景下,数据中心AI推理市场正迎来一位强有力的竞争者。2025年10月,高通技术公司正式宣布推出基于Qualcomm AI200与AI250芯片的加速卡及机架系统,标志着这家移动芯片巨头强势进军数据中心AI推理市场。新一代解决方案依托高通在NPU技术领域的深厚积累,专注于为大语言模型(LLM)与多模态模型(LMM)推理工作负载提供机架级性能与卓越的内存容量,以业界先进的总体拥有成本(TCO) 为客户带来突破性的价值主张。
一、产品特性
●差异化产品配置:AI200解决方案专为机架级AI推理打造,每张加速卡支持768GB的LPDDR内存,实现高内存容量与低成本的最佳平衡。而AI250解决方案则首次采用基于近内存计算的创新内存架构,实现超过10倍的有效内存带宽提升并显著降低功耗。
●高效散热系统:两款机架解决方案均配备直接液冷技术,极大提升散热效率,单机架功耗高达160千瓦,为高密度计算提供可靠的热管理保障。
●灵活扩展架构:支持PCIe垂直扩展与乙太网络横向扩展,满足不同规模数据中心的部署需求。AI250还支持分離式AI推論,进一步提升硬件资源利用效率。
●安全可靠保障:具备机密运算功能,确保AI工作负载的安全性,为敏感数据处理提供硬件级保护。
●完整软件生态:提供超大规模等级的AI软件堆栈,覆盖从应用层到系统软件层的端到端架构,支持主流机器学习框架和推理引擎。
二、产品优势
●卓越成本效益:高通AI200与AI250解决方案以业界先进的总体拥有成本(TCO) 为核心优势,通过优化的硬件设计和高效的能源利用,为客户提供显著的长期投资回报。高通技术公司高管强调,这些解决方案能让客户"以前所未有的总體擁有成本部署生成式AI"。
●能效表现突出:凭借在移动芯片领域积累的低功耗技术优势,高通将能效管理专长成功迁移至数据中心场景。AI250通过近内存计算架构大幅降低功耗,为AI推理工作负载带来能效与性能的跨越性提升。
●部署灵活性高:解决方案支持从独立组件、服务器加速卡到完整机柜方案的多种交付形式,适配不同客户的硬件环境与业务需求。这种模块化设计使客户能够根据实际工作负载灵活扩展算力。
●简化模型部署:软件栈支持与主流AI框架的无缝兼容,提供一键式模型部署功能,开发者可通过高通的高效Transformers Library与AI Inference Suite,轻松集成并部署Hugging Face等平台的模型。
三、突破性技术亮点
1. 近内存计算架构的创新突破
●AI250解决方案引入的近内存计算架构代表了内存技术的重要进化。传统计算架构中,数据需要在处理器和内存之间频繁传输,导致延迟和能耗增加。而近内存计算通过将算力模块靠近内存布置,大幅缩短了数据搬运距离,实现了超过10倍的有效内存带宽提升。这种创新架构不仅显著提高了AI推理效率,同时大幅降低了功耗,为大规模AI部署提供了新的可能性。
2. 大容量内存优化设计
●AI200单卡配备768GB LPDDR内存,容量达到同类产品的约3倍。这一设计直接应对了生成式AI模型参数规模庞大的挑战,使得更大规模的模型能够在单卡内完成推理,减少了模型切分带来的复杂性和性能开销。选择LPDDR而非HBM内存,在保证性能的同时显著降低了构建成本,体现了高通在成本与性能间的精细平衡。
3. 端侧与云端协同优势
●高通将其在手机芯片领域深耕多年的能效优势成功迁移至数据中心场景。多年来在骁龙Snapdragon手机芯片上积累的低功耗技术,使高通深知如何在有限功耗下实现更强性能,这一能力直接转化为数据中心市场的竞争优势。随着AI从云端向边缘扩展,高通在"云边端协同"方面的整体布局,将为其带来独特的市场竞争优势。
四、同类竞品品牌型号对比
表格分析
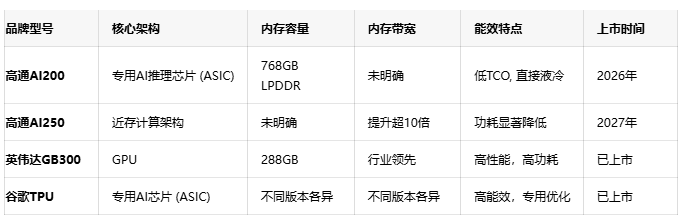
从竞争对比可以看出,高通AI200/AI250在内存容量和创新架构上形成了差异化竞争优势。AI200的768GB LPDDR内存容量达到英伟达GB300的2.67倍,为大模型推理提供了充足的记忆空间。
AI250采用的近内存计算架构是其最具突破性的技术创新,宣称可实现超过10倍的有效内存带宽提升。这一特性针对AI推理工作负载的内存访问模式进行了深度优化,有望在特定场景下实现性能的跨越式提升。
在能效表现方面,高通凭借其在移动芯片领域的技术积累,将低功耗设计作为核心竞争优势。结合直接液冷散热技术,整个解决方案在能源使用效率(PUE)上有望表现出色,这对于电费占运营成本大头的数据中心来说至关重要。
值得注意的是,高通AI芯片属于ASIC(专用集成电路) 类别,与英伟达的GPU通用计算架构形成鲜明对比。ASIC芯片虽然在通用性上有所限制,但在特定任务(如AI推理)上可以提供更高的算力密度和能效,这反映了高通对AI推理市场需求的精准把握。
五、应用领域
●大语言模型与多模态模型推理:AI200与AI250解决方案专为LLM与LMM推理工作负载优化,能够高效支持当前流行的生成式AI应用,包括智能对话、内容生成等场景。
●企业级生成式AI部署:凭借低TCO优势,这两款解决方案非常适合有大规模AI推理需求的企业,帮助它们以更低的总拥有成本部署生成式AI服务。
●云服务提供商基础设施:支持PCIe垂直扩展与乙太网络横向扩展的架构设计,使云服务商能够灵活配置算力资源,满足不同客户群体的多样化需求。
●AI初创公司算力建设:沙特支持的AI创业公司Humain已计划从2026年开始部署200兆瓦的高通新型AI机架,这表明高通的解决方案正获得新兴AI企业的认可。
●边缘计算与云端协同场景:高通在端侧AI的领先地位与云端AI芯片形成互补,为需要"云边端协同"的AI应用提供全栈式解决方案。
六、产品供货
根据高通公司的官方规划,Qualcomm AI200与AI250将分别于2026年和2027年正式上市。这一分阶段上市策略使高通能够持续保持市场关注度,并按年度迭代节奏推进产品路线图。
在市场准备方面,高通已获得首批客户认可。沙特AI创业公司Humain计划从2026年开始部署200兆瓦的高通新型AI机架。若按单机柜160千瓦计算,200兆瓦的部署规模相当于约1,250个机架。参考英伟达高端机架级AI系统价格(260万至300万美元之间),这一合作有望为高通带来超过30亿美元的收入。
结语
高通AI200与AI250的推出,不仅是公司业务多元化的战略举措,更是对全球AI芯片市场格局的一次重要冲击。随着AI商业应用的重心从训练向推理迁移,高通凭借其在能效、成本与特定场景优化上的差异化优势,有望在快速增长的数据中心AI推理市场中占据一席之地。
从长远来看,AI芯片市场很可能形成 "云边端协同、多强并存" 的格局。在这个格局中,英伟达仍将主导云端训练市场,而在边缘侧推理领域,以高通为代表的厂商有望崛起为重要力量。最终的竞争胜负,不仅取决于硬件算力,更取决于对特定场景的深度优化能力以及所构建的软件与应用生态成熟度。
随着AI200于2026年上市,AI产业将迎来更加多元化的算力选择,这场由高通掀起的AI推理芯片竞赛,值得业界持续关注。

推荐阅读:
直面SSD掉电风险!帝奥微DIO60843集成3Ω快速放电守护数据安全
专为便携设备优化:谷泰微GT4798以2μA静态电流诠释低功耗
为警用无人机注入硬核实力:华北工控EMB-3513实现算力与接口双重突破
为您推荐
业界新闻
11月18日,英伟达发布2027 财年第三季度(截至 2026 年 7 月 26 日),本季度营收 1158亿美元,环比增长20%,同比增长103%,净利润653亿美元,同比增长105%。 其中,数据中心收入达到1076亿美元,同比增长110%。公司的增长主要来自于数据中心业务,体现出人工智能相关的计算需求,继续支撑着它的业绩表现。
 业界新闻
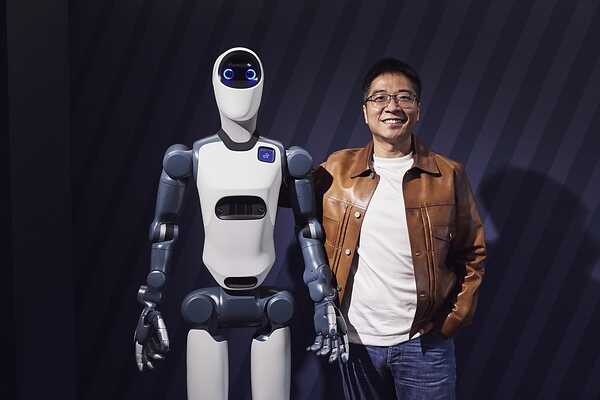
物理 AI 企业思灵机器人宣布完成 5 亿美元 F 轮融资,由软银领投,英伟达、日立等参投,投后估值 85 亿美元,累计融资达 20 亿美元。资金将用于产能扩张、海外市场布局与人形机器人应用开发;同步推出适配英伟达 GR00T 生态的 Agile ONE SN 科研人形平台,并联合奥迪、达索、英伟达开展工厂零件拣选项目,公司已落地 20000 套工业机器人方案,冲刺规模化商用。
 业界新闻
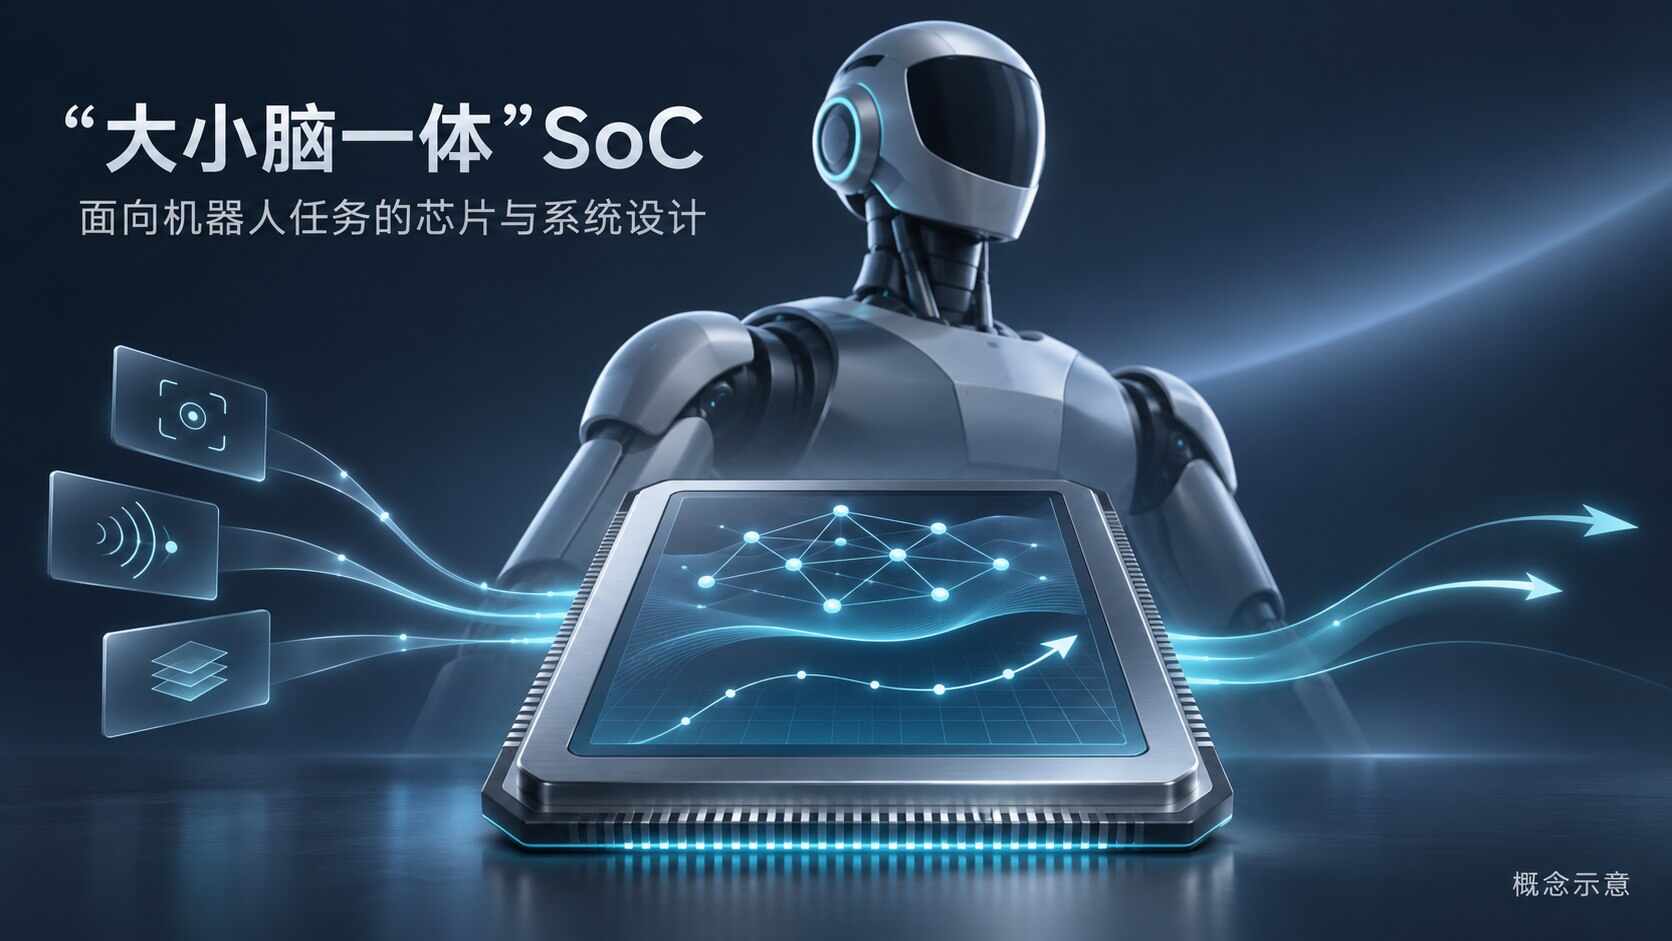
由优必选、沐曦股份联合发起的曦选创智完成 5 亿元天使轮融资,投后估值 40 亿元。公司聚焦自主可控具身智能端侧芯片,采用 “机器人真实任务牵引芯片定义” 路线,首颗自研主控 SoC 定位大小脑一体架构,对标 NVIDIA Thor,以通用 GPGPU 为核心、搭建类 CUDA 软件生态;本轮资金将投入芯片架构、工具链、团队建设与客户联合验证,计划 2027 年交付验证平台、2028 年推出正式 SoC 产品,补齐国产机器人端侧算力短板。
 解决方案
2026 年 11 月 5 日,Supermicro(美超微,SMCI)宣布携手 IBM、NVIDIA 推出全新 KV Cache 存储解决方案。整套方案搭载 AMD EPYC 9005(Turin)处理器的 Petascale 全闪存存储服务器、IBM Storage Scale、NVIDIA Dynamo 推理框架与 Spectrum-X 以太网,将 KV 缓存卸载至共享存储,突破 GPU 显存限制。基于 1200 亿参数大模型测试,13 万 token 输入下首个词元生成速度提升最高 56 倍,显著提升 GPU 利用率与推理吞吐量,适配 AI 智能体、RAG、多轮对话等长上下文业务。
 新品速递
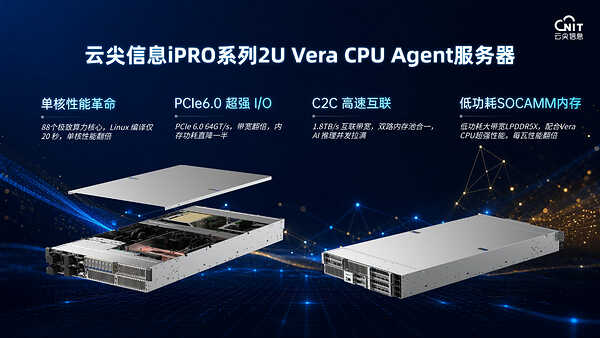
第四届链博会,云尖信息在 NVIDIA 展区发布 R8260 N8 AI Agent 服务器。这款 iPRO 系列 2U 机型搭载 NVIDIA Vera CPU,依托 PCIe 6.0、C2C 一致性互联,主打强单核、高带宽、低功耗,针对性解决 AI Agent 场景 CPU 拖累 GPU、KV Cache 受限等痛点,适配 AI 推理、企业级 Agent、HPC 等业务,兼顾性能与 TCO。