业界新闻

英伟达追加30万颗H20订单:2025年陆系AI服务器代工链全面升温

发布时间:2025-07-30 00:00:00 责任编辑:lina

【导读】近日,英伟达向台积电大幅追加30万颗H20芯片订单,专供中国大陆市场,凸显阿里巴巴、字节跳动、腾讯、百度等陆系云端服务提供商(CSP)AI投资持续升温。这一动作直接点燃AI服务器代工链需求,工业富联、英业达、神达等代工厂迎来订单高峰,业务增长显著。

近日,英伟达向台积电大幅追加30万颗H20芯片订单,专供中国大陆市场,凸显阿里巴巴、字节跳动、腾讯、百度等陆系云端服务提供商(CSP)AI投资持续升温。这一动作直接点燃AI服务器代工链需求,工业富联、英业达、神达等代工厂迎来订单高峰,业务增长显著。


英伟达追加30万颗H20订单:2025年陆系AI服务器代工链全面升温


据路透社报道,英伟达近日向台积电追加生产30万颗H20芯片的订单,目标明确指向中国大陆市场。此次追加源于陆系CSP(如阿里、字节、腾讯、百度)对AI算力的强劲需求——为应对自身AI模型研发及超大规模数据中心建设,这些企业在2025年4月美国政府升级AI芯片管制措施前已提前备货,但持续扩大的AI投资仍推动英伟达进一步增产。


受此带动,鸿海集团旗下工业富联(FII)等AI服务器代工厂迎来业务爆发。工业富联2025年第二季度云端运算业务营收同比增超50%,其中AI服务器营收增幅超60%,CSP服务器营收更同比暴增超150%,直接反映陆系客户拉货动能强劲。


英业达作为深耕大陆市场的代工厂,已打入百度、阿里、腾讯、字节跳动四大CSP的AI服务器供应链,当前出货以L10(机柜组装与测试)及L11(服务器整合与机架布建)为主。尽管此前美国禁令导致客户提前储备H20库存(可覆盖全年需求),但随着禁售令调整,英业达预计下半年出货将转向主机板(L6)等高单价产品,有望通过产品组合优化提升毛利率。


阿里云作为大陆AI基础设施(Iaas)龙头,2024年市占达23%,其近期推出的高性能AI编程模型进一步催动算力需求。业内认为,陆系CSP对H20的持续采购及AI服务器建置,将成为2025年服务器代工链增长的核心驱动力。


结语


英伟达30万颗H20芯片的追加订单,不仅是陆系CSP AI投资热潮的直接体现,更标志着2025年AI服务器代工链进入高景气周期。随着算力需求从模型训练向更多场景渗透,代工厂通过技术升级与产品组合优化,有望持续分享AI基础设施建设的红利。

https://www.52solution.com/kb


推荐阅读:

AI算力需求激增,AMD MI350涨价70%背后的市场信号

电视OLED面板技术升级:2025年LG显示驱动IC用量减半

从DDR4到HBM3:国内存储产业的技术升级与挑战

2025年Q3存储市场:DDR4领涨,工业需求成关键支撑

AI引擎驱动存储变革,2025 NAND Flash供不应求加剧



为您推荐

思灵机器人完成 5 亿美元 F 轮融资,投后估值 85 亿美元,加速物理 AI 人形机器人产业化 业界新闻

思灵机器人完成 5 亿美元 F 轮融资,投后估值 85 亿美元,加速物理 AI 人形机器人产业化

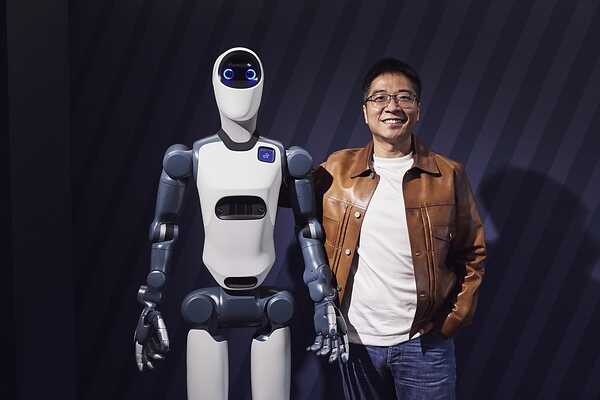
物理 AI 企业思灵机器人宣布完成 5 亿美元 F 轮融资,由软银领投,英伟达、日立等参投,投后估值 85 亿美元,累计融资达 20 亿美元。资金将用于产能扩张、海外市场布局与人形机器人应用开发;同步推出适配英伟达 GR00T 生态的 Agile ONE SN 科研人形平台,并联合奥迪、达索、英伟达开展工厂零件拣选项目,公司已落地 20000 套工业机器人方案,冲刺规模化商用。

Nvidia(英伟达)

曦选创智完成 5 亿天使轮融资(投后 40 亿),打造自主可控具身智能端侧算力平台 业界新闻

曦选创智完成 5 亿天使轮融资(投后 40 亿),打造自主可控具身智能端侧算力平台

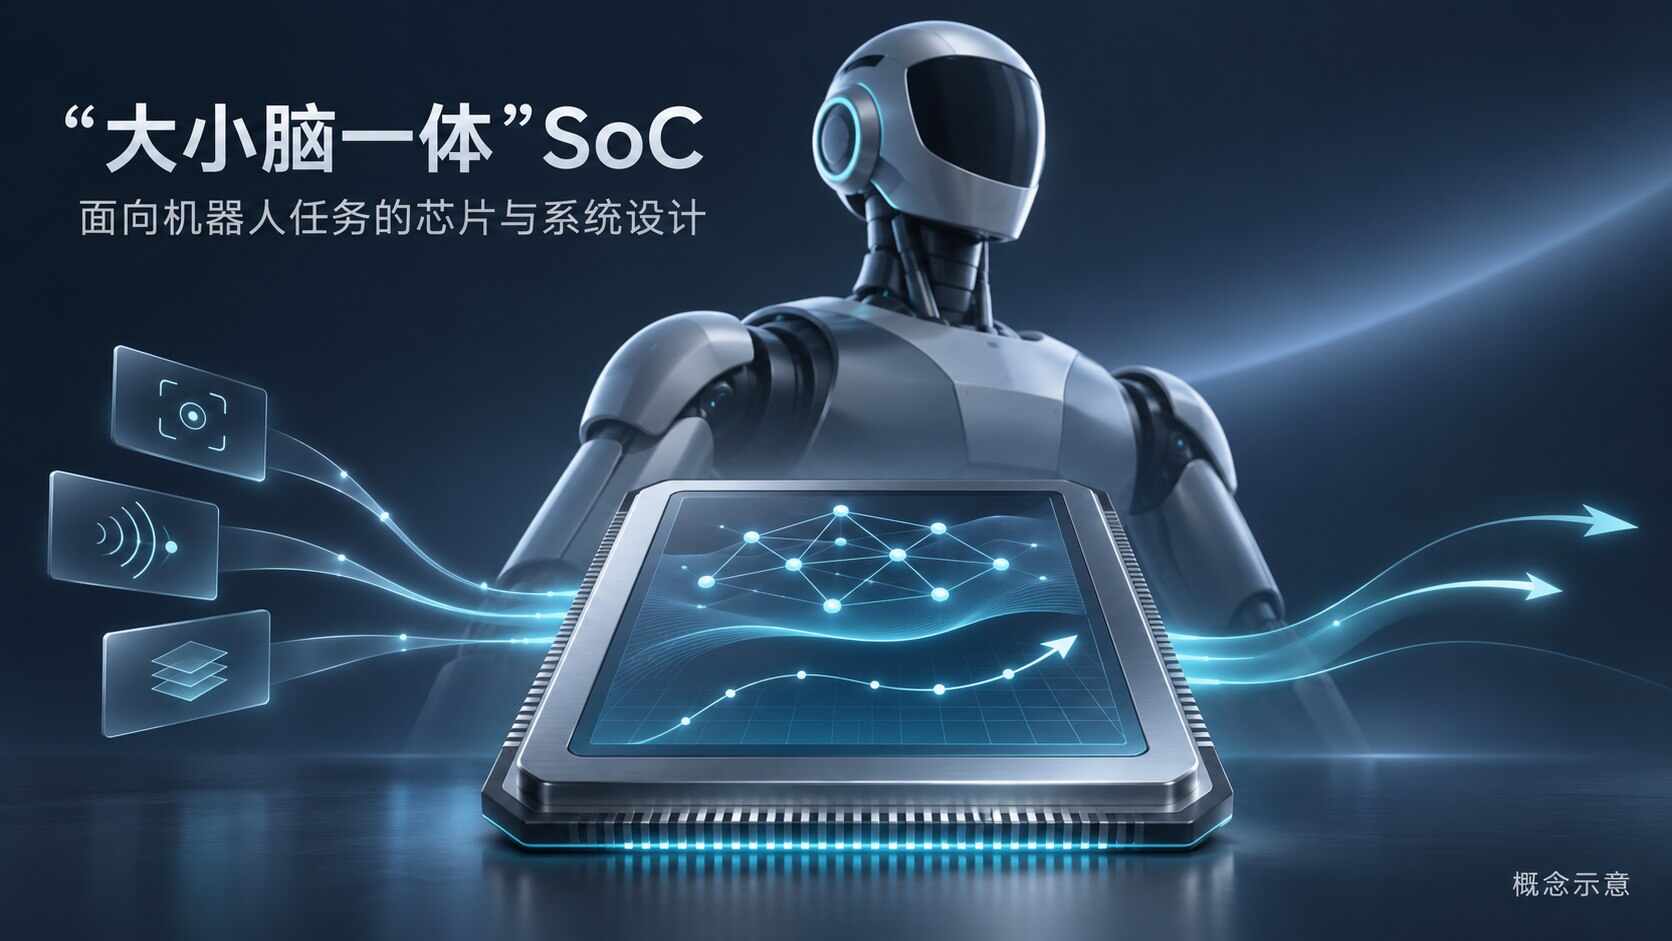
由优必选、沐曦股份联合发起的曦选创智完成 5 亿元天使轮融资,投后估值 40 亿元。公司聚焦自主可控具身智能端侧芯片,采用 “机器人真实任务牵引芯片定义” 路线,首颗自研主控 SoC 定位大小脑一体架构,对标 NVIDIA Thor,以通用 GPGPU 为核心、搭建类 CUDA 软件生态;本轮资金将投入芯片架构、工具链、团队建设与客户联合验证,计划 2027 年交付验证平台、2028 年推出正式 SoC 产品,补齐国产机器人端侧算力短板。

Nvidia(英伟达)

Supermicro 联合 IBM、NVIDIA 推出 KV Cache 存储方案 大幅优化长上下文 AI 推理 新品速递

Supermicro 联合 IBM、NVIDIA 推出 KV Cache 存储方案 大幅优化长上下文 AI 推理

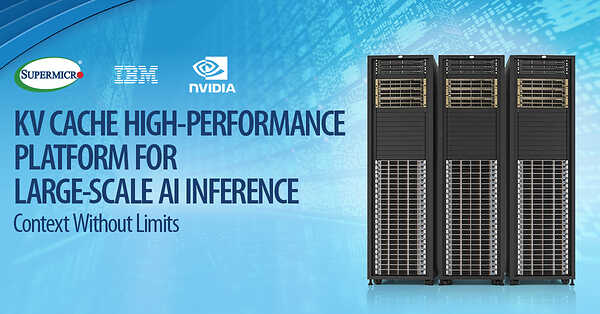
2026 年 11 月 5 日,Supermicro(美超微,SMCI)宣布携手 IBM、NVIDIA 推出全新 KV Cache 存储解决方案。整套方案搭载 AMD EPYC 9005(Turin)处理器的 Petascale 全闪存存储服务器、IBM Storage Scale、NVIDIA Dynamo 推理框架与 Spectrum-X 以太网,将 KV 缓存卸载至共享存储,突破 GPU 显存限制。基于 1200 亿参数大模型测试,13 万 token 输入下首个词元生成速度提升最高 56 倍,显著提升 GPU 利用率与推理吞吐量,适配 AI 智能体、RAG、多轮对话等长上下文业务。

互联技术 测试测量 存储器 Nvidia(英伟达)

链博会首发|云尖 R8260 N8 AI Agent 服务器:搭载 NVIDIA Vera CPU 新品速递

链博会首发|云尖 R8260 N8 AI Agent 服务器:搭载 NVIDIA Vera CPU

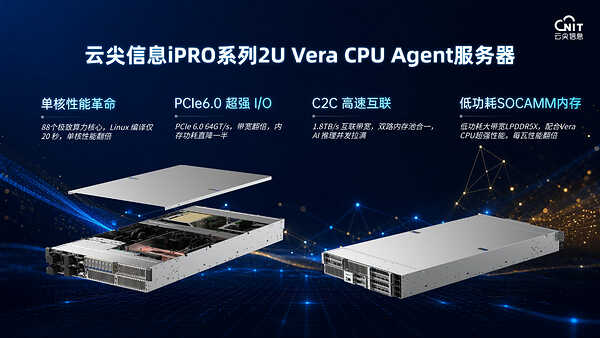
第四届链博会,云尖信息在 NVIDIA 展区发布 R8260 N8 AI Agent 服务器。这款 iPRO 系列 2U 机型搭载 NVIDIA Vera CPU,依托 PCIe 6.0、C2C 一致性互联,主打强单核、高带宽、低功耗,针对性解决 AI Agent 场景 CPU 拖累 GPU、KV Cache 受限等痛点,适配 AI 推理、企业级 Agent、HPC 等业务,兼顾性能与 TCO。

电源管理 互联技术 CPU Nvidia(英伟达)

Cadence 推出 Maestro 领域专用 AI 模型组合,赋能智能体芯片与系统 EDA 设计 新品速递

Cadence 推出 Maestro 领域专用 AI 模型组合,赋能智能体芯片与系统 EDA 设计

楷登电子(Cadence)正式推出 Maestro™领域专用 AI 模型组合,为半导体、系统设计流程中的 AI Super Agent 提供算力支撑。该方案垂直整合强化学习闭环,打通 Maestro 模型、AuraStack/ChipStack 等 Agent 套件与 Cadence EDA、SDA 工具链。实测对比通用大模型,设计成果质量最高提升 30%,Token 效率提升 5 倍;支持混合调用前沿大模型与领域专用模型,兼顾云端与客户本地私有化部署,NVIDIA、Socionext、Silicon Labs 已开展合作验证,首批 Maestro 模型将于 2026 年 Q4 面向早期客户开放。

Nvidia(英伟达)

特别推荐

更多

行业动态

更多

技术应用

更多

选型替代

更多

产品信息

更多

热门搜索

更多

欢迎登录

没有账号,

账号注册

注册成功!

3S后自动为你跳转登陆