业界新闻

三星急需提高3nm AI芯片代工良率,目前仅20%

发布时间:2024-09-14 00:00:00 责任编辑:lina

【导读】三星电子急需提高先进人工智能(AI)芯片的代工良率。英伟达表示,由于其芯片需求持续强劲,可能会将订单从台积电转移出去。

三星急需提高3nm AI芯片代工良率,目前仅20%


三星电子急需提高先进人工智能(AI)芯片的代工良率。英伟达表示,由于其芯片需求持续强劲,可能会将订单从台积电转移出去。


英伟达CEO黄仁勋近期表示,台积电的“敏捷性和响应我们需求的能力令人难以置信”,但“如果有必要,我们当然可以随时提供其他产品”。


黄仁勋对AI芯片需求的担忧不无道理,他说,客户对英伟达Blackwell芯片的需求“非常大”,英伟达的供应商正在尽最大努力跟上这一需求。同时,他指出,由于地缘政治紧张局势加剧等担忧,英伟达可能会在必要时更换供应商。然而,他警告说,这种变化可能会“导致产品质量下降”。


英伟达将其大部分先进AI芯片的物理生产外包给台积电,而不是三星等其他代工厂。


2023年,三星代工厂获得了英伟达的8nm芯片订单,例如用于汽车的Tegra和2020年的RTX-3000图形处理单元(GPU)。然而,它未能成功获得更先进的AI芯片的订单,例如H系列或Blackwell,这些芯片需要更先进的制造工艺。


正如黄仁勋所指出的,问题在于质量。三星的代工厂正在努力提高制造良率。但这一数字并没有像三星希望的那样快速提高。三星的代工厂苦苦挣扎,直到今年第一季度,3nm工艺的良率仍保持在个位数,导致其自有Exynos 2500芯片的工程样品供应延迟。分析师认为,三星在第二季度成功将3nm良率提高到近20%,但这仍然不足以实现量产,量产需要至少60%的良率。


在此背景下,三星似乎难以获得代工订单。据业内人士透露,该公司最近调整了其在京畿道平泽市最新晶圆厂P4的设备安装计划,优先生产先进DRAM内存,例如高带宽存储器(HBM)芯片。


该晶圆厂最初计划从安装NAND设备开始,然后是代工厂,最后是DRAM产品。然而,由于代工订单低迷,这一顺序已被改变。有传言称,鉴于对HBM和其他用于AI服务器的先进存储产品的稳定需求,三星可能决定将P4专门用于制造存储芯片。


另外,三星对其位于美国得克萨斯州泰勒市工厂的投资面临质疑。该公司最初计划从明年开始使用该工厂量产4nm芯片,但已将该计划推迟到2026年。据报道,虽然4nm工艺的良率稳定,但三星正在努力获得无晶圆厂公司的订单。


因此,也有猜测称,三星可能会将重点从4nm芯片转移到2nm芯片上,以确保未来获得更先进产品的订单。然而,报道显示,该公司在提高2nm工艺以及3nm工艺的制造良率方面也面临挑战。


一位半导体行业官员表示:“三星代工厂累计亏损的核心原因之一是良率低。该公司设法稳定4nm工艺的产量,但在更先进的工艺(如第二代3nm或 2nm工艺)中尚未做到这一点。”


三星没有披露其代工业务的单独收益,但市场观察人士估计,该公司今年上半年的营业亏损约为1.5万亿韩元(11.2亿美元)。


“三星在HBM业务上的成就仍未达到应有的水平,其代工部门仍在亏损中苦苦挣扎,”Eugene Investment & Securities分析师Lee Seung-woo表示,“因此,三星半导体业务今年第三季度的营业利润预计将下降至5.5万亿韩元。”


免责声明:本文为转载文章,转载此文目的在于传递更多信息,版权归原作者所有。本文所用视频、图片、文字如涉及作品版权问题,请联系小编进行处理。


推荐阅读:

2nm良率遭遇重大挫折,三星从泰勒晶圆厂撤出人员

江波龙:SLC NAND Flash累计出货量已超5000万颗

NAND市场两极分化:消费级SSD价格下滑,企业级SSD涨价

PSA马来西亚PCB新工厂开始运营,产能将翻一番

英飞凌成功研发出全球首款12英寸GaN晶圆


为您推荐

思灵机器人完成 5 亿美元 F 轮融资,投后估值 85 亿美元,加速物理 AI 人形机器人产业化 业界新闻

思灵机器人完成 5 亿美元 F 轮融资,投后估值 85 亿美元,加速物理 AI 人形机器人产业化

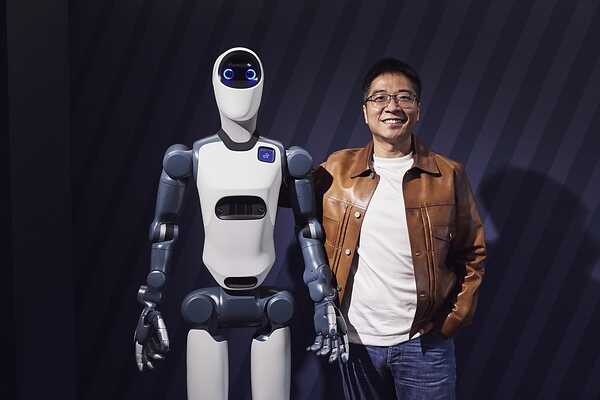
物理 AI 企业思灵机器人宣布完成 5 亿美元 F 轮融资,由软银领投,英伟达、日立等参投,投后估值 85 亿美元,累计融资达 20 亿美元。资金将用于产能扩张、海外市场布局与人形机器人应用开发;同步推出适配英伟达 GR00T 生态的 Agile ONE SN 科研人形平台,并联合奥迪、达索、英伟达开展工厂零件拣选项目,公司已落地 20000 套工业机器人方案,冲刺规模化商用。

Nvidia(英伟达)

曦选创智完成 5 亿天使轮融资(投后 40 亿),打造自主可控具身智能端侧算力平台 业界新闻

曦选创智完成 5 亿天使轮融资(投后 40 亿),打造自主可控具身智能端侧算力平台

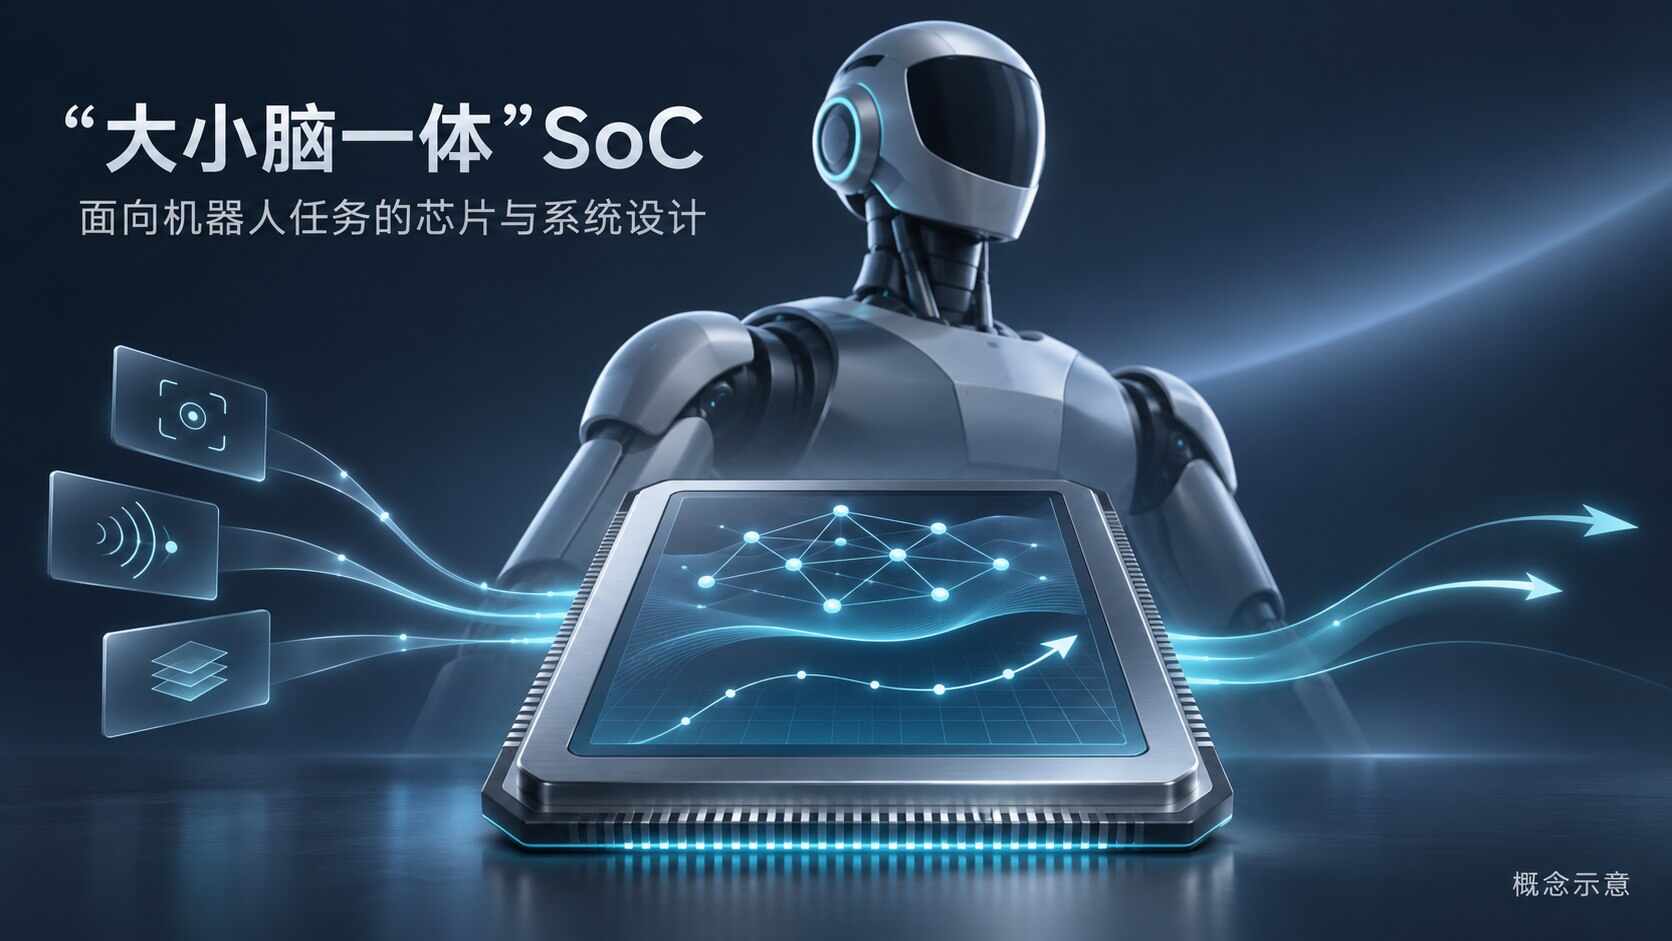
由优必选、沐曦股份联合发起的曦选创智完成 5 亿元天使轮融资,投后估值 40 亿元。公司聚焦自主可控具身智能端侧芯片,采用 “机器人真实任务牵引芯片定义” 路线,首颗自研主控 SoC 定位大小脑一体架构,对标 NVIDIA Thor,以通用 GPGPU 为核心、搭建类 CUDA 软件生态;本轮资金将投入芯片架构、工具链、团队建设与客户联合验证,计划 2027 年交付验证平台、2028 年推出正式 SoC 产品,补齐国产机器人端侧算力短板。

Nvidia(英伟达)

Supermicro 联合 IBM、NVIDIA 推出 KV Cache 存储方案 大幅优化长上下文 AI 推理 新品速递

Supermicro 联合 IBM、NVIDIA 推出 KV Cache 存储方案 大幅优化长上下文 AI 推理

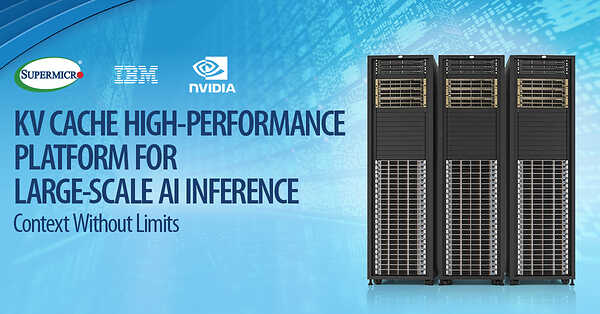
2026 年 11 月 5 日,Supermicro(美超微,SMCI)宣布携手 IBM、NVIDIA 推出全新 KV Cache 存储解决方案。整套方案搭载 AMD EPYC 9005(Turin)处理器的 Petascale 全闪存存储服务器、IBM Storage Scale、NVIDIA Dynamo 推理框架与 Spectrum-X 以太网,将 KV 缓存卸载至共享存储,突破 GPU 显存限制。基于 1200 亿参数大模型测试,13 万 token 输入下首个词元生成速度提升最高 56 倍,显著提升 GPU 利用率与推理吞吐量,适配 AI 智能体、RAG、多轮对话等长上下文业务。

互联技术 测试测量 存储器 Nvidia(英伟达)

链博会首发|云尖 R8260 N8 AI Agent 服务器:搭载 NVIDIA Vera CPU 新品速递

链博会首发|云尖 R8260 N8 AI Agent 服务器:搭载 NVIDIA Vera CPU

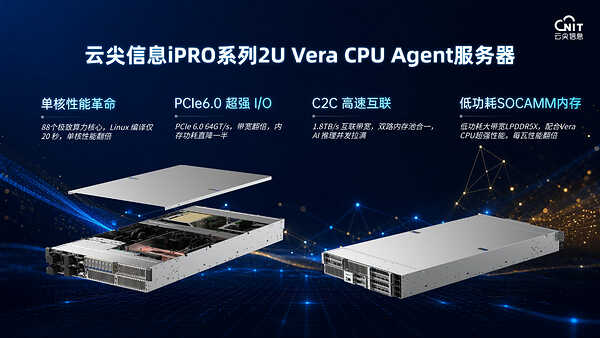
第四届链博会,云尖信息在 NVIDIA 展区发布 R8260 N8 AI Agent 服务器。这款 iPRO 系列 2U 机型搭载 NVIDIA Vera CPU,依托 PCIe 6.0、C2C 一致性互联,主打强单核、高带宽、低功耗,针对性解决 AI Agent 场景 CPU 拖累 GPU、KV Cache 受限等痛点,适配 AI 推理、企业级 Agent、HPC 等业务,兼顾性能与 TCO。

电源管理 互联技术 CPU Nvidia(英伟达)

Cadence 推出 Maestro 领域专用 AI 模型组合,赋能智能体芯片与系统 EDA 设计 新品速递

Cadence 推出 Maestro 领域专用 AI 模型组合,赋能智能体芯片与系统 EDA 设计

楷登电子(Cadence)正式推出 Maestro™领域专用 AI 模型组合,为半导体、系统设计流程中的 AI Super Agent 提供算力支撑。该方案垂直整合强化学习闭环,打通 Maestro 模型、AuraStack/ChipStack 等 Agent 套件与 Cadence EDA、SDA 工具链。实测对比通用大模型,设计成果质量最高提升 30%,Token 效率提升 5 倍;支持混合调用前沿大模型与领域专用模型,兼顾云端与客户本地私有化部署,NVIDIA、Socionext、Silicon Labs 已开展合作验证,首批 Maestro 模型将于 2026 年 Q4 面向早期客户开放。

Nvidia(英伟达)

特别推荐

更多

行业动态

更多

技术应用

更多

选型替代

更多

产品信息

更多

热门搜索

更多

欢迎登录

没有账号,

账号注册

注册成功!

3S后自动为你跳转登陆