【导读】4月17日——行业领先的AI网络全栈式互联产品及解决方案提供商奇异摩尔今日宣布,已成功构建800G AI超级网卡(SNIC)平台架构,除了800Gb/s的高带宽,亚微秒级的超低时延,其关键技术还涵盖面向AI网络的增强型RoCE v2机制,包括包喷洒、多路径传输、高效重传、先进的可编程拥塞控制等。基于该自研平台架构设计的AI SNIC ASIC,已于近期完成回片,并顺利通过核心RDMA架构的硅验证,单通道吞吐量稳定在400Gbps,关键时延约1微秒。在当前国产高性能网卡公开产品与产业叙事仍多集中于100/200G RDMA ASIC引擎阶段的背景下,奇异摩尔正以单通道400G RDMA ASIC引擎这一实质性突破,为国产AI超级网卡快速迈向800G ASIC揭开序幕。
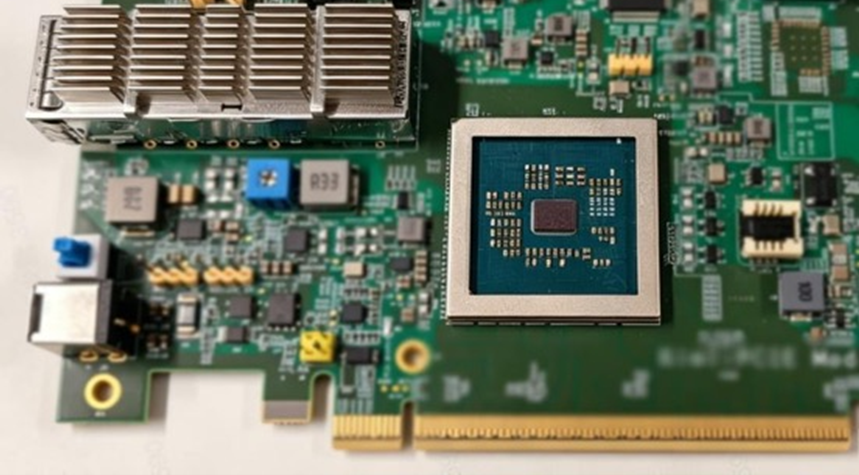
【图1】800G AI SNIC平台架构设计的ASIC已顺利通过RDMA架构的硅验证,单通道吞吐量稳定在400Gbps
为什么是基于以太网的RDMA AI原生网卡
在AI网络兴起之前,行业对智能网卡(SmartNIC)的主流划分,并非围绕AI训练与推理场景,而是依据芯片架构与卸载能力深度进行区分。核心关注点在于其能够为CPU分担多少基础设施工作,包括虚拟机间网络交换、存储、加解密、安全与遥测、压缩与解压缩等硬件卸载功能,典型产品如数据处理单元(DPU)网卡,并非针对大模型集群通信进行专项定制优化。
进入大模型时代,随着AI训练从千卡向万卡规模扩展、推理从单机部署走向大规模分布式服务,Scale-out网络正在成为决定GPU利用率、集合通信效率和单位Token成本的关键基础设施。无论是All-Reduce、Reduce-Scatter,还是All-to-All等典型集合通信,都要求网络具备更高带宽密度、更低时延、更低尾时延,以及更快的拥塞响应能力。在此背景下,基于以太网的高性能RDMA路线愈发清晰:它既继承了以太网生态开放、部署成熟、成本可控的优势,又通过面向AI网络的RoCE/RDMA专项优化,逐步具备支撑大规模AI集群的能力。
这一技术趋势在国内头部云服务提供商(CSP)的技术需求规范,以及国外超以太网联盟(UEC)的诞生中体现得尤为明显。其核心就是交付一套面向AI与HPC场景的开放、高性能以太网架构,重点解决传统以太网在大规模训练环境下面临的多路径传输、快速拥塞响应、尾时延控制、易配置与可扩展性等问题。换句话说,以太网不再只是“通用网络”的代表,而是在AI时代被重新定义为承载大规模集群互联的主航道之一。
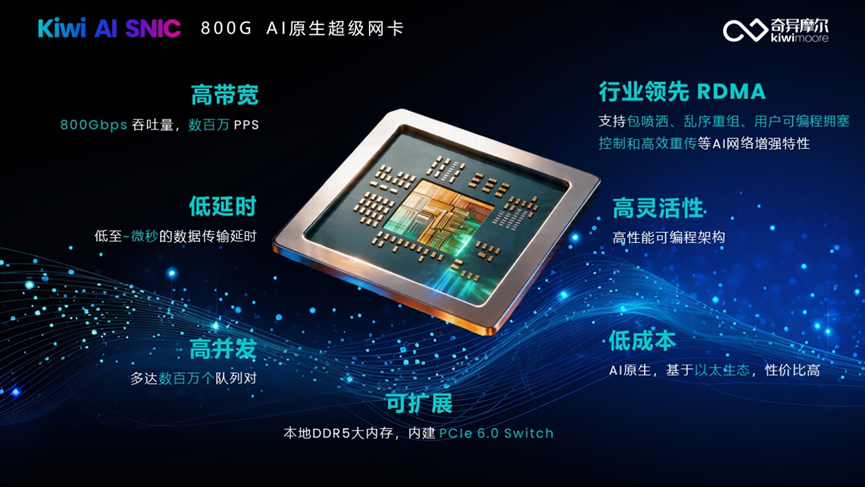
【图2】800G AI SNIC及功能描述
“奇异摩尔AI超级网卡技术路线,与头部云服务提供商(CSP)的需求完全一致,与UEC的规范也高度趋同。我们已构建的800G平台架构能力,能有效支持最高800Gb/s RDMA吞吐,数百万级消息处理能力与数百万级队列(QP),大大增强了RoCE v2协议栈,增加了包喷洒、乱序重组、高效重传,高级可编程拥塞控制等AI网络急需的增强特性。以太网的技术路线确保了产品的开放互操作性与生态兼容性,为进入头部云服务供应商以及未来平滑融入超以太网生态、实现跨厂商协同奠定了基础。”奇异摩尔网络技术VP叶栋表示。
叶栋拥有超过20年的网络互联系统架构设计经验,在AI网络协议、RDMA、虚拟化、软件协议栈等方面拥有丰富的专业知识。其在英特尔(中国)工作多年,曾任英特尔网络互联产品事业部技术总监,负责英特尔以太网、智能网卡,P4可编程交换芯片、英特尔/Google IPU相关系统架构产品的本地化研发和部署。启动和主导了多家大型云服务提供商大规模部署的技术方案的底座。
针对网络密集型大规模并行计算对高带宽、低延迟数据传输的严苛需求,NVIDIA不仅推出基于IB网络的超级网卡(SNIC),也推出了面向以太网的SNIC,旨在为AI工厂与云数据中心提供强大的网络支撑。NVIDIA对AI超级网卡的定义十分清晰:这是一类“专为网络密集型、海量分布式AI计算工作负载打造的新型网络加速器”。其价值远不止于完成数据包的传输,更在于让多GPU、多节点环境下的通信真正成为释放算力的加速引擎。
对标NVIDIA ConnectX-8/9的领先性,800G AI网卡从“接口”走向“中枢”
NVIDIA公开表示,ConnectX-8是业界首个把PCIe Gen6级交换能力与超高速网络处理能力集成到单一器件中的超级网卡(SNIC)。它不仅服务于AI、HPC和超大规模云数据中心场景,还通过集成48 lanes的PCIe Gen6 Switch,把原本需要独立PCIe Switch和独立NIC共同完成的任务,整合到一个高集成度器件中,这是一项绝无仅有的创新技术路径。
传统1机8卡PCIe GPU服务器普遍采用以CPU为根节点、PCIe Switch向下连接GPU的树形拓扑。这种架构在通用计算时代较为成熟,但在大模型训练场景下,其结构性性能瓶颈日益突出:GPU间通信往往需要经过PCIe Switch,跨Socket路径还可能受到主机链路约束,导致时延升高、带宽利用率下降,难以满足All-Reduce、Reduce-Scatter、All-to-All等高频集合通信对低时延和高吞吐的要求。因此ConnectX-8将PCIe Gen6交换能力与高速网络能力整合到单一器件中,可替代传统离散PCIe Switch,既优化GPU到GPU、GPU到NIC的数据路径,也降低系统复杂度、功耗和总体拥有成本。
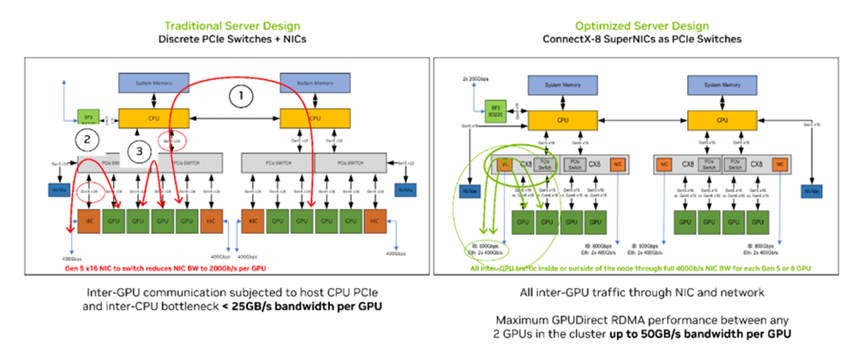
在端口形态上,ConnectX-8也已经明确迈入800G时代。NVIDIA官方显示,ConnectX-8以太网版本具备2×400GbE的产品形态,其不仅拥有800G级总带宽能力,也具备更灵活的双端口组网方式,更适合未来大规模AI集群对冗余、分流、弹性扩展和复杂拓扑部署的需求。从出货形态来说,ConnectX-8已将高速网络能力与PCIe Gen6 Switch能力整合至单一器件之中,并以一体化集成设计形态面向平台出货。
奇异摩尔创造里程碑:国产AI SNIC从“可用”迈向“高性能”
正是在这样的全球技术演进背景下,奇异摩尔基于自研800G AI SNIC ASIC架构构建的单通道400G引擎完成了核心RDMA ASIC流片验证,才显得意义格外突出。与FPGA方案更适合早期验证、快速迭代不同,ASIC路线决定了一款产品是否真正具备面向大规模AI训推集群的性能上限、功耗效率、板卡集成度和量产一致性。奇异摩尔率先在国产阵营中实现单通道400G RDMA ASIC引擎,吞吐量稳定在400Gbps,不仅填补了国内高带宽超级网卡芯片的空白,更充分证明了其已掌握2×400G乃至更高速率产品的核心设计能力,为下一代800G网卡奠定了坚实技术基础。
奇异摩尔最新800G SNIC全面对标英伟达ConnectX-8/9的架构方向,采用与国际先进方案相一致的“高速网络处理+PCIe Switch能力”一体化设计思路,在产品形态上支持2×400G端口以太网总带宽,在架构层面同时提供AI服务器内部互连优化与节点间高速通信能力。这意味着,该企业在800G产品布局上不只是带宽规格升级,更是对未来AI高性能集群互连形态的提前卡位:通过集成PCIe Switch能力,重构GPU到GPU、GPU到NIC的数据路径,提升集合通信效率、降低系统复杂度,并增强对整机平台和集群方案的定义能力。
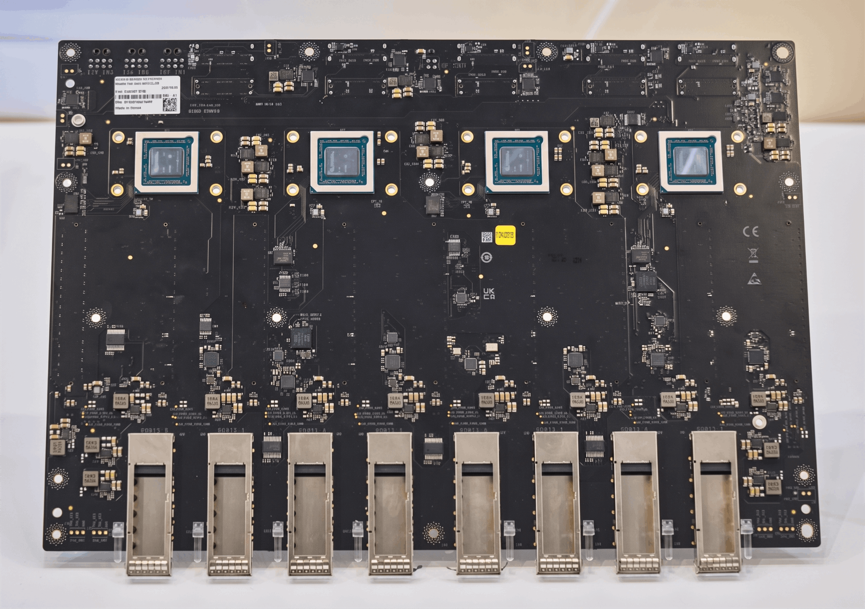
奇异摩尔网络技术VP叶栋补充道,奇异摩尔最新800G超级网卡计划于年内量产,有望成为国产800G AI超级网络芯片、系统集成方案以及平台级架构能力上的重大突破,进一步增强中国厂商在未来AI高性能集群基础设施中的产品定义权、方案协同权和产业话语权。
国产化窗口已开,市场潜力加速释放
从产业空间与政策环境来看,奇异摩尔所切入的并非小众赛道,而是一个正在快速扩容的核心基础设施市场。公开研究显示,仅ConnectX-7级别的高性能AI网卡市场规模已超过百亿元,并仍在持续增长。这意味着,以ConnectX-7/ ConnectX-8为代表的高性能AI网卡赛道,背后对应的是一个数百亿元级、且仍在不断放大的市场机遇。
与此同时,国家对自主可控智算底座、高速互连及国产化集群的战略需求正持续加强。国家发展改革委等部门已明确提出,要加快部署智能无损网络、400G/800G等先进技术,建设高速泛在、安全可靠的全国一体化算力网,并强化自主创新技术供给能力。
奇异摩尔是一家深度聚焦AI互联多年的全栈式解决方案提供商,以网络+芯粒技术为底层特色,除面向Scale Out场景的AI网卡芯片,公司还提供面向Scale Up超节点的G2G IO互联芯粒,并已在业内实现落地应用。这一不同于其他芯片厂商的技术基因构筑了差异化的竞争壁垒,也赋予了其在下一代高性能集群互联中更强的灵活性、更广阔的发展空间以及更深的技术纵深。

 行业活动