 行业报告
硅基工业压力传感器,如何走出“缺芯少器”困局
传感器被称为工业的“眼睛”和“触觉”,是智能制造、流程工业等领域不可替代的基础元件。其中,硅基压力传感器凭借硅材料成熟的集成电路工艺、优异的材料机械特性和片上集成能力,成为工业测控主流感知技术路线用压力传感器。

业界新闻
发布时间:2025-08-25 00:00:00 责任编辑:zoe
【导读】近日,中国AI公司DeepSeek通过微信平台发布信息,其最新推出的DeepSeek-V3.1大型语言模型中,首次引入了专为国产芯片设计的UE8M0 FP8 scale技术架构。这一举措被业界视为“中国下一代AI芯片即将落地”的明确信号——该技术并非通用架构,而是深度适配“即将发布的国产AI芯片”的硬件逻辑设计。尽管DeepSeek未直接点名供应商,但结合各厂商的技术储备与市场布局,华为(海思)、寒武纪、摩尔线程、海光信息、沐曦集成电路等五家企业,被认为是“下一代AI芯片”的核心潜在供应商。
一、UE8M0 FP8:下一代AI芯片的“效率密码”
要理解“下一代AI芯片”的核心优势,首先需要拆解UE8M0 FP8技术的底层逻辑。
FP8(8位浮点格式)是当前AI芯片的“效率革命”方向——通过降低数据精度(从传统的16位/32位降至8位),可大幅减少存储器占用与带宽消耗,从而加速AI训练与推理过程。而DeepSeek-V3.1采用的UE8M0,则是FP8的“定制化变种”:
U(无符号) :适用于非负场景(如图像识别中的像素值、自然语言处理中的词向量权重),避免了符号位对计算资源的浪费;
E8M0:指数位占8位、尾数位占0位(传统FP8为“E5M2”或“E4M3”),通过“动态尾数分配”或“预设尾数为1”的方式,实现“精度损失最小化”与“计算效率最大化”——据DeepSeek测试,该格式可将存储器使用降低75% ,同时保持AI模型的推理精度(如GPT-4级模型的准确率下降不超过2%)。
这种“定制化FP8”技术,正是下一代AI芯片的“核心竞争力”:它既解决了传统AI芯片“算力高但效率低”的痛点(如英伟达H100的FP8算力虽高,但针对中国场景的适配性不足),又通过“硬件-模型协同设计”,实现了“算力密度”与“能效比”的双重提升。
二、谁能接棒?五大厂商的“技术储备”与“适配能力”
结合各厂商的现有产品与技术布局,以下五家企业具备成为“下一代AI芯片供应商”的核心优势:
1. 华为(海思):生态闭环的“全能选手”
华为海思作为国内芯片生态的“龙头”,其昇腾系列AI芯片(如昇腾910、昇腾710)已形成“芯片-框架-应用”的完整生态(搭配MindSpore框架)。尽管海思未公开下一代芯片的细节,但从其“持续优化FP8支持”的路线看,昇腾系列极有可能搭载UE8M0 FP8技术——此前,昇腾910已支持FP16/FP32混合精度训练,若升级至FP8,算力密度有望提升50% 以上(参考寒武纪思元590的测试数据)。此外,华为的“芯片+终端+云”生态(如Mate 60系列手机、华为云),也为下一代AI芯片的落地提供了“场景保障”。
2. 寒武纪:FP8技术的“先行实践者”
寒武纪作为“AI芯片第一股”,其思元590芯片(2024年发布)已率先支持FP8精度,成为国内首个实现“FP8训练+推理”的AI芯片。测试数据显示,思元590的FP8算力密度较前代思元370提升40% ,同时显存占用降低35% ——这与DeepSeek-V3.1的“UE8M0 FP8”技术目标高度契合。此外,寒武纪的“芯片+框架”生态(思元芯片搭配自研的Cambricon Neuware框架),已实现“FP8精度”与“AI模型”的深度协同,若下一代芯片升级至UE8M0,有望进一步缩小与英伟达H100的算力差距。
3. 摩尔线程:国产GPU的“FP8原生支持者”
摩尔线程作为“国产GPU龙头”,其MTT S80芯片(2023年发布)是国内首个支持原生FP8的GPU产品。该芯片采用“FP8+FP16”混合精度架构,在保持AI推理精度的同时,将计算效率提升30% 。对于下一代AI芯片而言,“原生FP8支持”是关键优势——无需通过软件转换(如英伟达的TensorRT),即可直接运行FP8模型,大幅降低延迟。结合摩尔线程与国内AI公司(如字节跳动、百度)的合作布局,其极有可能成为“下一代AI芯片”的“GPU核心供应商”。
4. 海光信息:通用计算的“FP8优化者”
海光信息作为“x86架构通用芯片龙头”,其海光三号(Hygon C86 3000) 芯片已通过“FP8精度优化”,将AI训练中的显存占用降低30% ,运算效率提升20% 。尽管海光的核心业务是通用CPU,但随着AI与通用计算的融合(如服务器端AI推理),其“FP8优化技术”可直接迁移至下一代AI芯片——尤其是针对“云服务”场景(如阿里云、腾讯云的AI算力平台),海光的“通用+AI”混合架构,有望成为差异化优势。
5. 沐曦集成电路:初创公司的“AI芯片潜力股”
沐曦集成电路作为“专注于AI芯片的初创企业”,其曦思系列芯片(2024年发布)已支持“FP8+INT8”混合精度训练,目标市场覆盖“AI训练”与“智能驾驶”。尽管沐曦的市场份额较小,但凭借“轻量级架构”与“快速迭代”的优势,其极有可能成为“下一代AI芯片”的“细分场景供应商”(如边缘AI设备、智能终端)。
三、从“模型适配”到“生态闭环”:国产AI的“硬软协同”新进展
DeepSeek-V3.1的另一重意义,在于它是国内首个成功采用FP8精度完成训练的大型语言模型。这意味着,国产AI芯片不仅在“硬件算力”上取得突破,更在“模型适配”上形成了“硬软协同”的生态闭环。
以华为为例,其“昇腾芯片+MindSpore框架+ModelArts平台”的生态,已实现“FP8精度”从“芯片”到“模型”的全链路支持——开发者可通过MindSpore框架,直接将模型转换为FP8格式,运行在昇腾芯片上,无需额外优化;寒武纪的“思元芯片+Cambricon Neuware框架”,则针对FP8精度优化了“矩阵乘法”(GEMM)运算,将AI训练速度提升35% 。这种“硬软协同”,正是下一代AI芯片的“核心竞争力”——它不仅能提升算力,更能降低开发者的使用成本,加速AI技术的落地。
四、市场反应:“AI芯片概念”成资本焦点
DeepSeek的信息发布后,资本市场迅速做出反应:寒武纪(688256.SH) 与海光信息(688041.SH) 的股价在次日上涨20% ,中芯国际(00981.HK) 股价上涨10.1% (中芯国际是上述厂商的主要晶圆代工合作伙伴)。这一现象说明,市场对“下一代AI芯片”的预期已从“技术概念”转向“商业落地”——投资者认为,具备“FP8技术储备”与“生态协同能力”的厂商,将成为“AI时代”的核心受益者。
结语:下一代AI芯片,开启中国AI的“自主可控”新阶段
DeepSeek-V3.1的“UE8M0 FP8”技术,本质上是“中国下一代AI芯片”的“技术预告”。它不仅标志着国产AI芯片在“算力效率”上的突破,更意味着中国AI产业已从“跟随模仿”转向“自主创新”——通过“硬软协同”的生态闭环,国产AI芯片有望打破英伟达(Nvidia)的“算力垄断”,成为全球AI市场的“核心玩家”。
对于华为、寒武纪等厂商而言,“下一代AI芯片”是一次“弯道超车”的机会——它们可通过“FP8精度”与“生态协同”,在“AI训练”“云服务”“边缘设备”等场景,与英伟达的H100/H20芯片展开竞争。而对于中国AI产业而言,下一代AI芯片的落地,将为“大模型训练”“智能驾驶”“医疗AI”等领域提供“自主可控”的算力支撑,加速中国从“AI大国”向“AI强国”的转型。
推荐阅读:
千伏级绝缘破局者:TDK InsuGate B78541A25重构功率模块安全边界
革新三电平架构!瑞萨RAA489300系列突破USB-C电源密度极限
革新HDMI传输瓶颈:Diodes混合式ReDriver破解高速信号衰减难题
毫米空间的微米革命:多维AMR4020VD如何破解精密运动控制的安装困局
Bourns PEC0x系列破壁:4mm全球最小编码器登陆TWS耳机,50万次寿命重塑人机交互
为您推荐
行业报告
传感器被称为工业的“眼睛”和“触觉”,是智能制造、流程工业等领域不可替代的基础元件。其中,硅基压力传感器凭借硅材料成熟的集成电路工艺、优异的材料机械特性和片上集成能力,成为工业测控主流感知技术路线用压力传感器。
 业界新闻
面对云计算与 AI 算力快速增长的市场需求,英特尔与微软达成多年长期合作协议,扩大双方在 Azure 基础设施领域的协作。微软成为首家采用英特尔代工 EMIB 嵌入式多芯片互连桥先进封装技术用于 Azure 自研芯片的企业。协议锁定包括 Diamond Rapids 下一代至强服务器 CPU 的多年产能供应,同时双方将围绕 CXL 计算快速链接、Intel QAT 加速、TDX 机密计算开展联合优化,实现虚拟机性能、数据库备份速度、数据安全能力提升,打造面向 AI 高负载的云基础设施底座。
 业界新闻
AI 服务器功耗持续攀升,800 VDC 高压直流架构成为数据中心提升能效、降低损耗的重要技术路线。英飞凌与麦格米特达成合作,麦格米特将在三相 AI 电源平台采用英飞凌 CoolSiC™ MOSFET G2 碳化硅器件,覆盖 PSU、IBC、SST 关键单元。依托碳化硅器件低损耗、优秀散热能力,系统效率超越 80 PLUS® Ruby 认证要求,助力 AI 数据中心实现更高功率密度与运行可靠性,双方还将持续深化下一代电力基础设施联合创新。
 新品速递
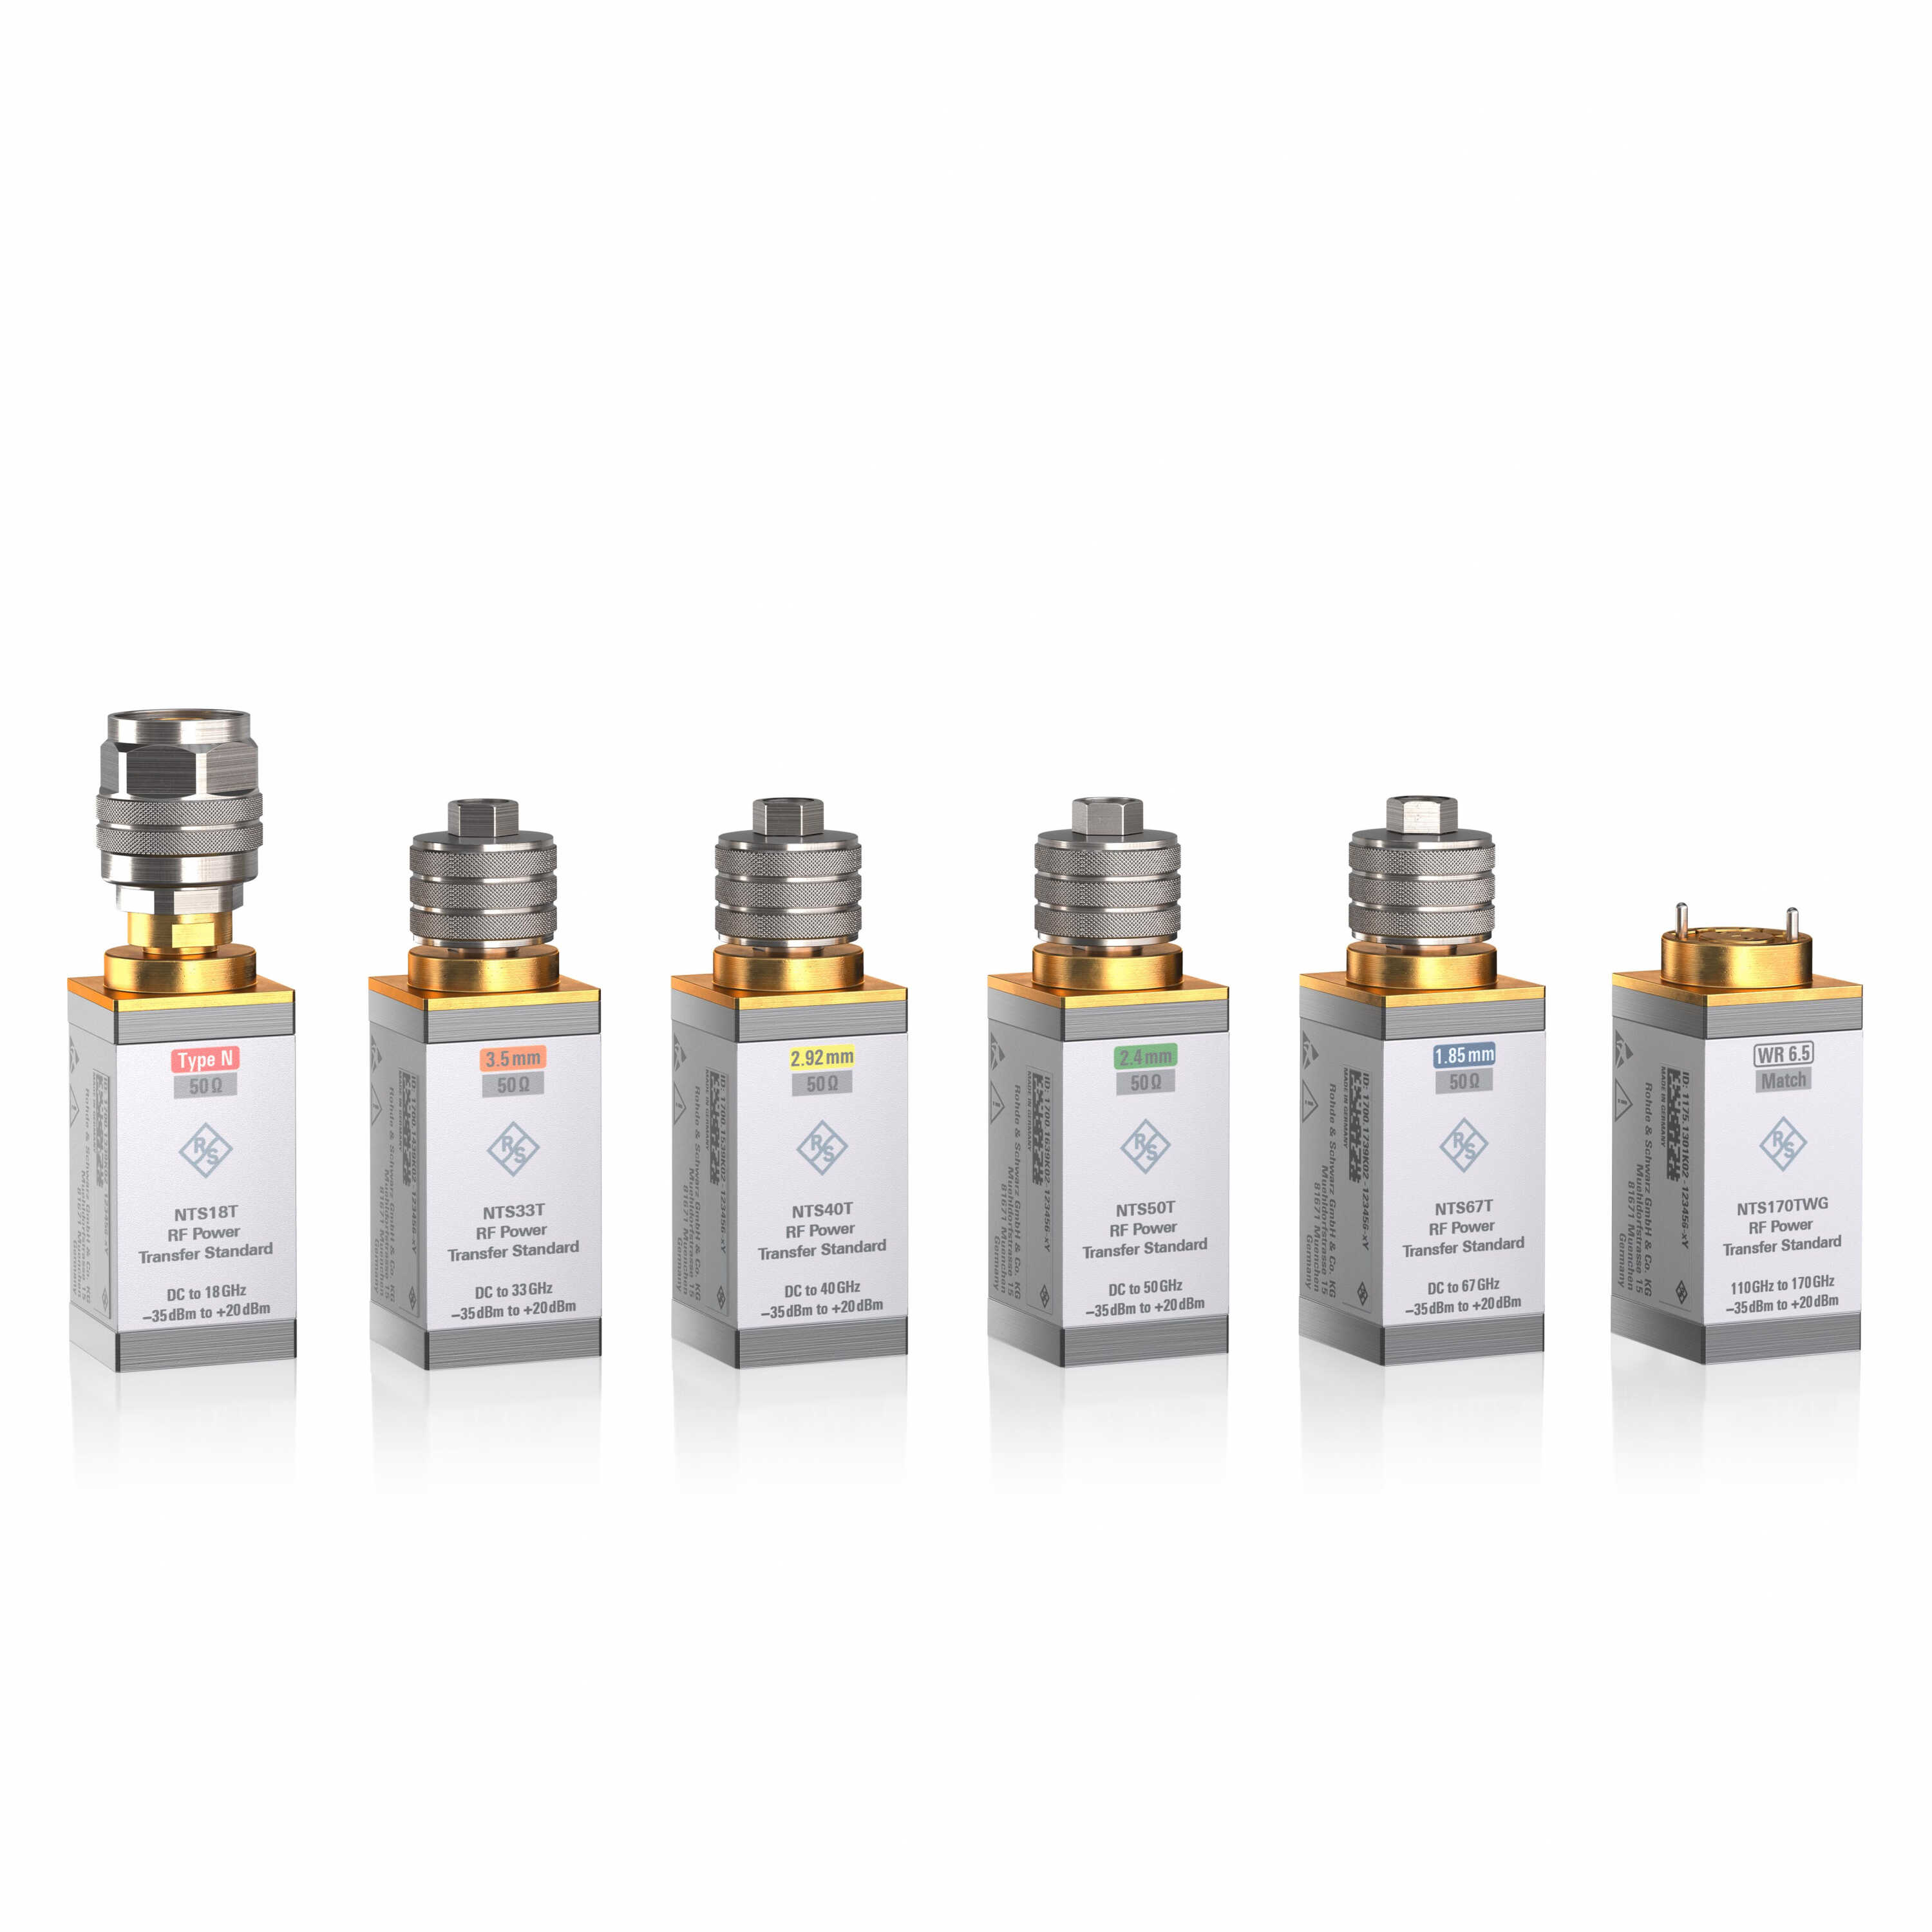
传统热敏电阻座射频功率标准已经停产,高频 D 波段等场景缺少可用溯源参考器件,给计量机构与工业校准带来难题。罗德与施瓦茨全新 R&S NTS 热电式射频功率传递标准器,用来替代逐步淘汰的热敏电阻座标准。产品分为同轴与波导型号,最高可覆盖 170GHz,依托成熟热电芯片实现计量级射频‑直流替代测量,可直接兼容现有微量热计系统,帮助计量实验室搭建完整射频功率可溯源校准体系,适配国家计量院、第三方校准实验室及高端工业测量场景。
 业界新闻
6G FR3 频段是下一代无线接入网与卫星通信的重点研究方向。罗德与施瓦茨联合和硕在台北 6G 峰会上公开完成 FR3 相控阵 MIMO 技术验证,依托 R&S FSWX 信号与频谱分析仪、SMW200A 矢量信号发生器,完成 13GHz、15GHz 双极化双流传输测试。实验室环境下速率可达 1.7Gbps,室内 40 米实测取得 1.4Gbps 峰值速率,验证了 FR3 频段大带宽、高阶调制、多流链路的落地潜力,为后续 6G 标准化与相控阵产品开发提供实测参考。