【导读】业界传来重要消息,英伟达已正式批准三星电子的第五代高带宽内存(HBM3E)用于其最新一代GB300人工智能加速器。这一突破标志着三星在经历多次技术验证失利后,终于重返英伟达核心供应链体系,打破了此前由美光和SK海力士主导的“双寡头垄断”格局。
10月10日,业界传来重要消息,英伟达已正式批准三星电子的第五代高带宽内存(HBM3E)用于其最新一代GB300人工智能加速器。这一突破标志着三星在经历多次技术验证失利后,终于重返英伟达核心供应链体系,打破了此前由美光和SK海力士主导的“双寡头垄断”格局。
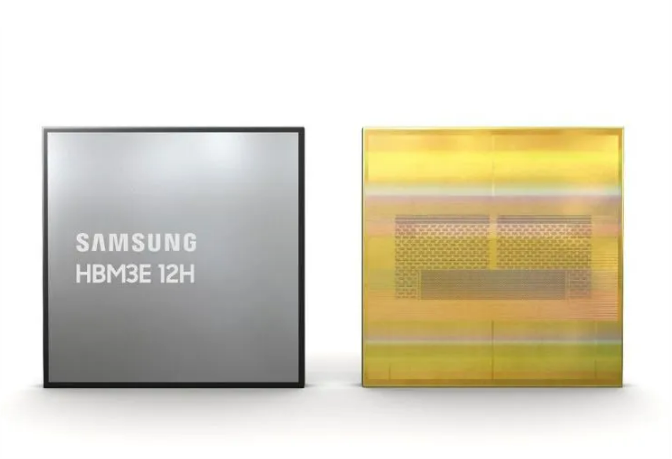
英伟达CEO黄仁勋已向三星电子会长李在镕发出正式信函,确认三星的12层堆叠HBM3E模块已通过资格测试。双方目前正就供应数量、价格及交付时间表进行最后协商。
01 破冰之旅:三星的19个月回归路
三星电子重返英伟达供应链的道路可谓一波三折。此次合作突破,距离三星首次传出有望进入英伟达供应链已过去一年七个月。
回顾此次合作进程,时间线显示,2024年3月的英伟达GTC大会期间,黄仁勋曾对三星HBM技术给予关键认可——在其展示的HBM3E样品上签下“Jensen Approved”(黄仁勋认可)。
然而,在后续推进中,三星HBM3E产品在英伟达严格的质量测试中屡次出现问题,导致合作进程一度停滞。
转折点出现在2025年,有消息称,李在镕紧急下令三星内部启动“强硬式改革”,聚焦HBM技术稳定性与可靠性提升,要求团队务必达到业界顶尖标准。
自2025年8月底起,李在镕将大部分时间投入美国商务活动,期间与黄仁勋进行了面对面会谈,这种被称为 “李式销售”的高强度客户对接策略,对合作达成起到了关键作用。
02 HBM格局:三足鼎立的市场现状
三星此次突破,正值全球HBM市场竞争白热化的关键时期。目前全球HBM市场呈现鲜明梯队格局,SK海力士以62%的绝对优势位居第一,美光以21%位列第二,三星电子则以17%暂居第三。
SK海力士的领先地位得益于其与英伟达建立的深度共生关系。它不仅成为英伟达旗舰AI GPU的HBM3和HBM3E独家供应商,而且仅英伟达一个客户就为其贡献了总收入的27%。
美光则采取了差异化策略,完全跳过HBM3代,直接专注于HBM3E。该公司已向客户交付HBM4样品,并实现了11Gbps的业界领先速度。
在此背景下,三星重返英伟达供应链具有里程碑意义。HBM3E是当前AI芯片的关键组成部分,其总线速度超过1TB/s,成为英伟达、AMD和英特尔最新AI芯片的必备元件。
03 GB300芯片:AI加速器的核心动力
英伟达GB300系列是AI加速器市场的重要产品,它们正被广泛应用于全球各大云服务提供商。
微软Azure最近发布的NDv6 GB300 VM系列就是其中的典型代表,它被称作首个超级计算规模的生产级NVIDIA GB300 NVL72系统集群。
该集群具有超过4600个Blackwell Ultra GPU,通过NVIDIA Quantum-X800 InfiniBand网络平台连接。
每个GB300 NVL72机架集成72个NVIDIA Blackwell Ultra GPU和36个NVIDIA Grace CPU,可提供37TB快速内存和1.44 exaflops的FP4 Tensor Core性能。
GB300的性能表现卓越,在MLPerf Inference v5.1基准测试中,使用NVFP4的NVIDIA GB300 NVL72系统创造了新纪录,在6710亿参数的DeepSeek-R1推理模型上,每个GPU的吞吐量比NVIDIA Hopper架构高出5倍。
04 HBM4竞赛:未来的技术制高点
尽管三星在HBM3E上取得了突破,但全球AI硬件行业已开始向第六代HBM4技术过渡。因此,三星此次为GB300供应的HBM3E产品数量预计不会过多。
HBM4技术已成为三星、SK海力士和美光三巨头竞争的新焦点。三星已在HBM4技术领域取得显著进展——今年7月,公司采用1c纳米工艺完成了HBM4的开发,并向主要客户发送了样品。
三星开发的HBM4通过提高单元集成密度,与上一代产品相比能效提高了40%,数据处理速度达到11Gbps。
这一性能表现有望帮助三星在高端市场建立竞争优势。
为扩大产能,三星已重启平泽第五工厂(P5)的建设。同时,该公司计划最早在2026年上半年实现HBM4的量产,并向英伟达下一代AI GPU Rubin等产品供应芯片。
SK海力士则已完成HBM4开发并准备量产。该公司计划到2027年再购置约20台EUV光刻机,以提升下一代DRAM和HBM4的制造竞争力。
05 AI工厂:黄仁勋的远见与布局
黄仁勋近期在谈及AI未来发展方向时,提出了 “AI工厂” 的概念,这超越了单一的芯片竞争。
他指出,我们正在经历需求的深度和广度的指数级成长,会使得总计算需求呈现爆炸性成长。
在英伟达的产品规划上,从Blackwell系列到明年要推出的Rubin和Rubin CPX,以及将推出的Vera Rubin产品,正是英伟达一步步转型为AI基础设施全套供应商的体现。
黄仁勋认为,未来数据中心的瓶颈是电力和土地,在AI时代,智慧能被以Token方式量化、定价,成为像水和电一样可以被生产与消费的商品。
面对Meta、谷歌和亚马逊等数据中心巨头自己研发的客制化ASIC芯片,黄仁勋表示,竞争对手头一开始就搞错战场,这场战争的核心从来都不是关于哪块芯片比较便宜,而是在于哪座AI工厂更赚钱。
随着AI浪潮持续涌动,HBM市场已成为全球半导体竞争的焦点。Counterpoint Research预测,三星电子明年在HBM市场的份额将突破30%。
这一预测得益于三星近期通过英伟达HBM3E认证,以及其HBM4技术即将量产带来的竞争优势。
全球HBM市场的“三国杀”不仅关乎企业营收,更将重塑高端半导体产业链格局。对三星而言,此次通过GB300认证不是终点,而是一个新的起点,为其在AI时代争夺HBM霸权保留了入场券。
推荐阅读:
2025年OLED面板收入承压,机构看好2026年强势反弹
全志科技第三季度净利预增超300%,AI驱动扫地机器人与汽车电子增长
摩根士丹利:存储市场迎上行周期,DDR4合约价有望大幅攀升
全球半导体市场持续回暖:8月销售额达649亿美元,同比增长21.7%
氮化镓市场迎爆发期:2030年规模冲35.1亿美元,汽车与数据中心成双引擎

 业界新闻