【导读】近日,摩尔线程正式发布并开源面向GPU底层算子生成的专用代码大模型MusaCoder。这是业内首个基于国产GPU算力底座完成全链路训练与验证的开源代码大模型,其完整后训练流程均在基于MTT S5000构建的夸娥智算集群上完成。在KernelBench严格评测中,MusaCoder-27B-RL以Overall Pass@8 93.2%、Avg.@8 88.60%的成绩,超越Claude Opus 4.7、GLM-5.1、DeepSeek-V4 Pro、Kimi K2.6等主流SOTA代码模型,展现出在GPU原生Kernel生成任务上的领先性能。
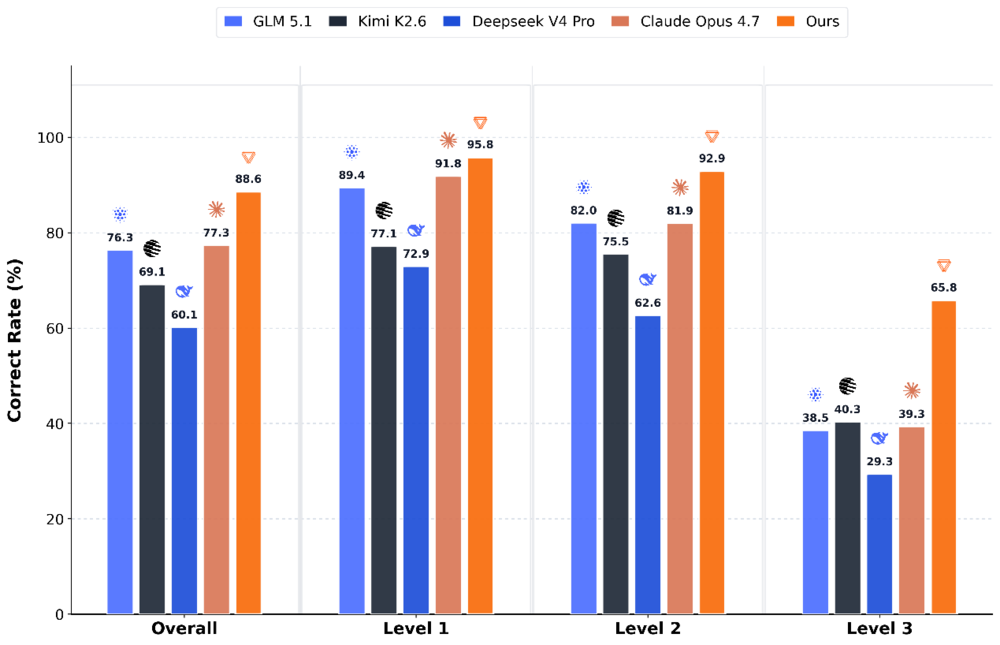
KernelBench准确率(Avg.@8)对比
MusaCoder模型权重已开源:https://huggingface.co/MooreThreads/MusaCoder-27B
MusaCoder论文地址:http://arxiv.org/abs/2606.04847
MusaCoder:专为GPU设计的高性能算子生成模型
MusaCoder是摩尔线程面向GPU底层算子生成任务设计的专用代码大模型,包含9B和27B两个参数规模。该模型重点支持从PyTorch标准算子自动生成高性能CUDA/MUSA原生Kernel代码,旨在降低开发者手写底层GPU算子的门槛,提升GPU高性能计算场景下的代码生成、验证和优化效率。
传统代码大模型虽然具备较强的通用编程能力,但在GPU Kernel生成任务中仍面临显著挑战:一方面,GPU Kernel 对并行计算、线程组织、内存访问、索引映射和硬件执行特性要求极高;另一方面,生成代码不仅要语法正确,还必须能够通过编译、数值正确性验证、反作弊检测,并在真实执行中获得性能收益。
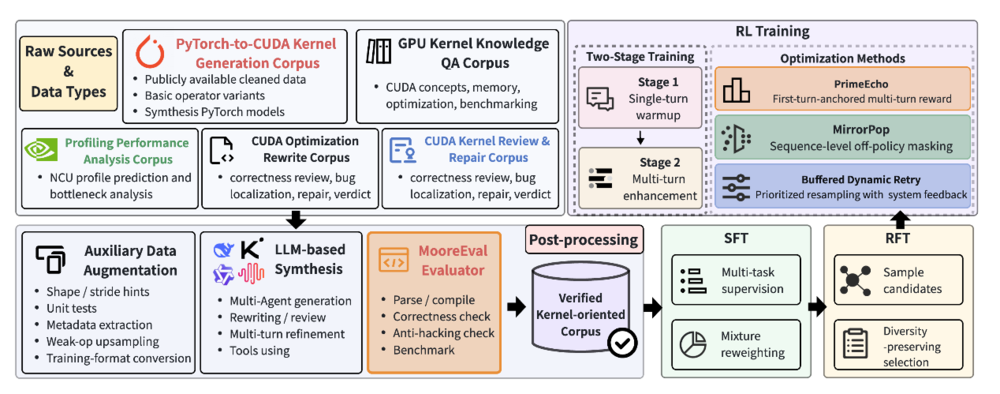
MusaCoder训练总流程
针对上述难点,MusaCoder构建了一套面向GPU原生算子(CUDA/MUSA)生成的大模型全栈后训练方法论。该流程覆盖数据构建、执行验证、强化学习优化等关键环节,使模型能够从基础代码能力逐步进化为具备底层算子生成与修复能力的专用模型。
在数据构建阶段,MusaCoder 通过结构化推理过程和显式 Shape 信息注入,增强模型对张量形状、内存布局和索引关系的理解,解决从通用代码能力迁移到 GPU Kernel 生成任务时的冷启动问题。
在评测与训练环境方面,摩尔线程构建了 MooreEval 分布式执行验证系统。MooreEval 能够对模型生成的代码进行自动编译、执行、正确性验证、性能测试和反作弊检测,并将结果转化为稳定的训练反馈信号。这使得模型不仅能学习“写出能运行的代码”,还能够进一步学习“写出正确、合法且更高效的原生 GPU Kernel”。
在强化学习阶段,MusaCoder针对GPU Kernel生成任务中的多轮修复、训练稳定性和长尾困难样本等问题,引入了PrimeEcho、MirrorPop和BDR等机制,用于提升模型在多轮调试场景下的修复能力和训练稳定性。通过这些方法,MusaCoder打通了从基础代码微调到执行反馈强化学习的完整优化闭环。
核心成果:正确率与真实加速能力双提升
在MooreEval执行式验证协议下,MusaCoder-27B-RL在KernelBench评测中取得了显著领先表现。
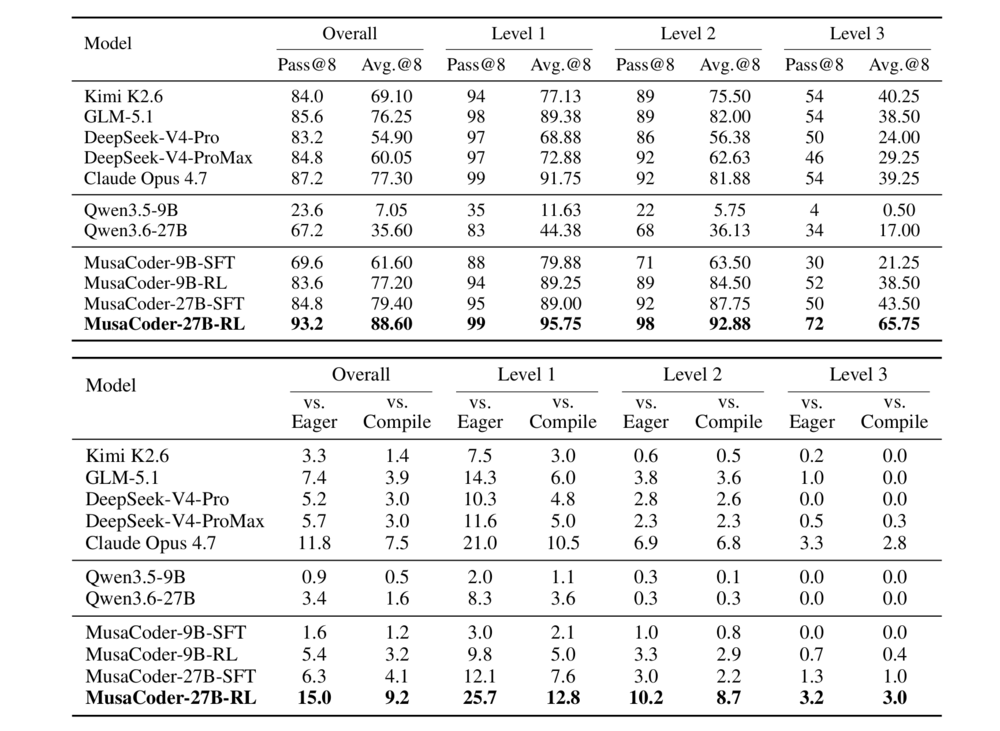
表1:KernelBench评估结果对比。Pass@8表示8个采样代码中至少有一个通过验证,而Avg.@8则衡量8个样本的平均正确率。
高准确率超越SOTA:从正确率来看,MusaCoder-27B-RL的Overall Pass@8达到93.2%,Avg.@8达到88.60%,均超过Claude Opus 4.7的87.2%和77.30%。在更具挑战性的Level 3任务上,MusaCoder-27B-RL的优势更加明显。Level 3任务通常涉及复杂shape推导、索引映射和多算子组合,对模型的底层代码理解能力和调试能力提出了更高要求。在该难度级别上,MusaCoder-27B-RL的Pass@8和Avg.@8分别领先Claude Opus 4.7的18个百分点和26.5个百分点。
真实加速能力突出:在MooreEval标准下,只有同时通过正确性验证、合法性检查,并且相比PyTorch baseline获得有效加速的候选实现,才会被计入 Faster Rate。MusaCoder-27B-RL的Overall Faster Rate达到15.0%(vs. PyTorch Eager)和9.2%(vs. torch.compile),分别高于Claude Opus 4.7的 11.8%和7.5%。
这表明MusaCoder不仅能够更稳定地生成正确的GPU Kernel,也更有能力生成具备实际性能收益的原生算子代码。
国产GPU完成全流程后训练,验证夸娥智算集群能力
MusaCoder模型的SFT(监督微调)、RFT(拒绝采样微调)、RL(强化学习)、异步rollout、在线编译执行验证及reward计算等全栈训练与验证流程,均依托摩尔线程旗舰级AI训推一体智算卡MTT S5000所构建的夸娥智算集群完成。
这一成果,充分验证了国产GPU不仅能够支撑大模型推理和常规微调任务,更能够稳定承载代码大模型后训练全周期算力需求。尤其是在GPU Kernel生成这一类任务中,训练系统需要频繁进行代码生成、编译、执行、验证和反馈计算,对硬件、编译栈、运行时、调度系统和评测基础设施都提出了更高要求。
MusaCoder的成功实践,将一次模型训练验证沉淀为可复用的工程范式:不仅为AI Coding、AI Infra等基础设施的自主可控提供了实践范例,也展现了摩尔线程在AI软件栈、训练平台、评测系统和开源模型生态方面的完整工程支撑能力。
共建开放生态,推动国产AI创新与应用
MusaCoder的正式开源,旨在为MUSA生态提供面向PyTorch到原生算子生成的基础模型能力,帮助开发者更高效地完成GPU Kernel 的生成、验证、修复和优化,降低底层算子开发门槛。
同时,MusaCoder也为高校、科研机构和开源社区提供了一个基于国产全功能GPU的代码生成研究平台,推动异构计算编程、AI编译优化和自动化Kernel生成等方向的开放研究与技术交流。
未来,摩尔线程将持续增强MusaCoder在复杂任务上的生成与修复能力,并进一步探索与IDE插件、自动调试工具、profiling工具等开发者工具链的结合,逐步形成从PyTorch参考实现到MUSA原生Kernel的自动生成、验证、修复和优化闭环,持续推动国产GPU生态建设与AI基础设施创新。

 行业活动