业界新闻

传OpenAI今年将交由台积电试产自有芯片 降低英伟达依赖度

发布时间:2025-02-11 00:00:00 责任编辑:lina

【导读】OpenAI 正在推动开发第一代内部人工智能 (AI) 芯片来减少对英伟达 (Nvidia)(NVDA-US) 芯片供应的依赖。


OpenAI 正在推动开发第一代内部人工智能 (AI) 芯片来减少对英伟达 (Nvidia)(NVDA-US) 芯片供应的依赖。


消息人士透露,ChatGPT 制造商将在未来几个月内完成其首款内部芯片的设计,并计划将其送往台积电 (TSM-US) 进行生产。将第一个设计送入芯片工厂的过程称为“试产”(taping out)。


OpenAI 和台积电拒绝置评。


最新消息显示,OpenAI 预计将实现其雄心勃勃的目标,即在 2026 年在台积电实现量产。传统计每次“流片”会耗费上千万美元,且需 6 个 月左右时间才能生产出最后芯片,OpenAI 为此可能要支付高额费用。没有人能保证芯片在第一次试产时就能正常运作,如果发生故障,公司将需要重新诊断问题并重复试产步骤。


消息人士指出,在 OpenAI 内部,这款专注于训练的芯片被视为加强 OpenAI 与其他芯片供应商谈判筹码的策略工具。在完成首代芯片后,OpenAI 的工程师计划在每次更新时开发出更广泛、更先进的处理器。


如果试产顺利,它将使 ChatGPT 制造商能够大规模生产第一款内部 AI 芯片,并可能在今年稍后测试英伟达芯片的替代品。OpenAI 计划今年将其设计提交给台积电,这代表该新创公司在其设计上取得快速进展,而其他芯片设计人员可能需要数年时间才能完成这一过程。


微软 (MSFT-US)、Meta (META-US) 等大型科技公司虽经多年努力,但仍难以生产出令人满意的芯片。最近,中国人工智能新创公司 DeepSeek 引发的市场暴跌也引发人们的疑问:未来开发强大模型所需的芯片是否会减少。


该芯片由何理查 (Richard Ho, 音译) 领导的 OpenAI 内部团队与博通 (AVGO-US) 合作设计,该团队的规模在过去几个月中扩大一倍达到 40 人。何理查一年多前从 Alphabet (GOOGL-US) 旗下的谷歌跳槽加入 OpenAI;他在谷歌协助领导这家搜寻巨头的客制化 AI 芯片专案。


与谷歌或亚马逊 (AMZN-US) 等科技巨头的大规模团队相比,何的团队规模较小。根据了解芯片设计预算的业内消息人士透露,一个雄心勃勃的大型项目的新芯片设计,单一版本的芯片成本可能高达 5 亿美元。建置必要的软体和周边设备的成本可能会翻倍。


OpenAI、Google 和 Meta 等生成式 AI 模型制造商已经证明,资料中心中串联在一起的芯片数量越来越多,使得模型变得更加智能,因此,对芯片的需求永无止境。


Meta 表示明年将在 AI 基础设施上投入 600 亿美元,微软则表示将在 2025 年投入 800 亿美元。OpenAI 本身正在参与美国总统川普上个月宣布的 5000 亿美元星际之门基础设施计划。


但成本上升和对单一供应商的依赖,已促使微软、Meta 以及现在的 OpenAI 等主要客户探索英伟达芯片的内部或外部替代品。


消息人士指出,OpenAI 的内部 AI 芯片虽然能够训练和运行 AI 模型,但最初将以有限的规模部署,主要用于执行 AI 模型。该芯片在公司的基础设施中将发挥有限的作用。


为了实现与谷歌或亚马逊的 AI 芯片计划一样全面的努力,OpenAI 必须雇用数百名工程师。


台积电正在利用其先进的 3 纳米制程技术生产 OpenAI 的 AI 芯片。消息人士表示,该芯片采用常用的脉动阵列架构和高频宽存储器 (HBM) 以及广泛的网路功能。英伟达芯片也采相同方式生产。


免责声明:本文为转载文章,转载此文目的在于传递更多信息,版权归原作者所有。本文所用视频、图片、文字如涉及作品版权问题,请联系小编进行处理。

我爱方案网


推荐阅读:

GPU加速出货,中国台湾对墨出口激增479%

智能手机需求疲软 三星显示预计第一季度盈利放缓

供应持续过剩,预计上半年DRAM价格将下降10%

三星 Exynos 2600 开发顺利,2nm芯片试生产良率约为30%

“面板双虎”公布1月营收:友达年增17.4%、群创年增13.1%


为您推荐

思灵机器人完成 5 亿美元 F 轮融资,投后估值 85 亿美元,加速物理 AI 人形机器人产业化 业界新闻

思灵机器人完成 5 亿美元 F 轮融资,投后估值 85 亿美元,加速物理 AI 人形机器人产业化

物理 AI 企业思灵机器人宣布完成 5 亿美元 F 轮融资,由软银领投,英伟达、日立等参投,投后估值 85 亿美元,累计融资达 20 亿美元。资金将用于产能扩张、海外市场布局与人形机器人应用开发;同步推出适配英伟达 GR00T 生态的 Agile ONE SN 科研人形平台,并联合奥迪、达索、英伟达开展工厂零件拣选项目,公司已落地 20000 套工业机器人方案,冲刺规模化商用。

Nvidia(英伟达)

曦选创智完成 5 亿天使轮融资(投后 40 亿),打造自主可控具身智能端侧算力平台 业界新闻

曦选创智完成 5 亿天使轮融资(投后 40 亿),打造自主可控具身智能端侧算力平台

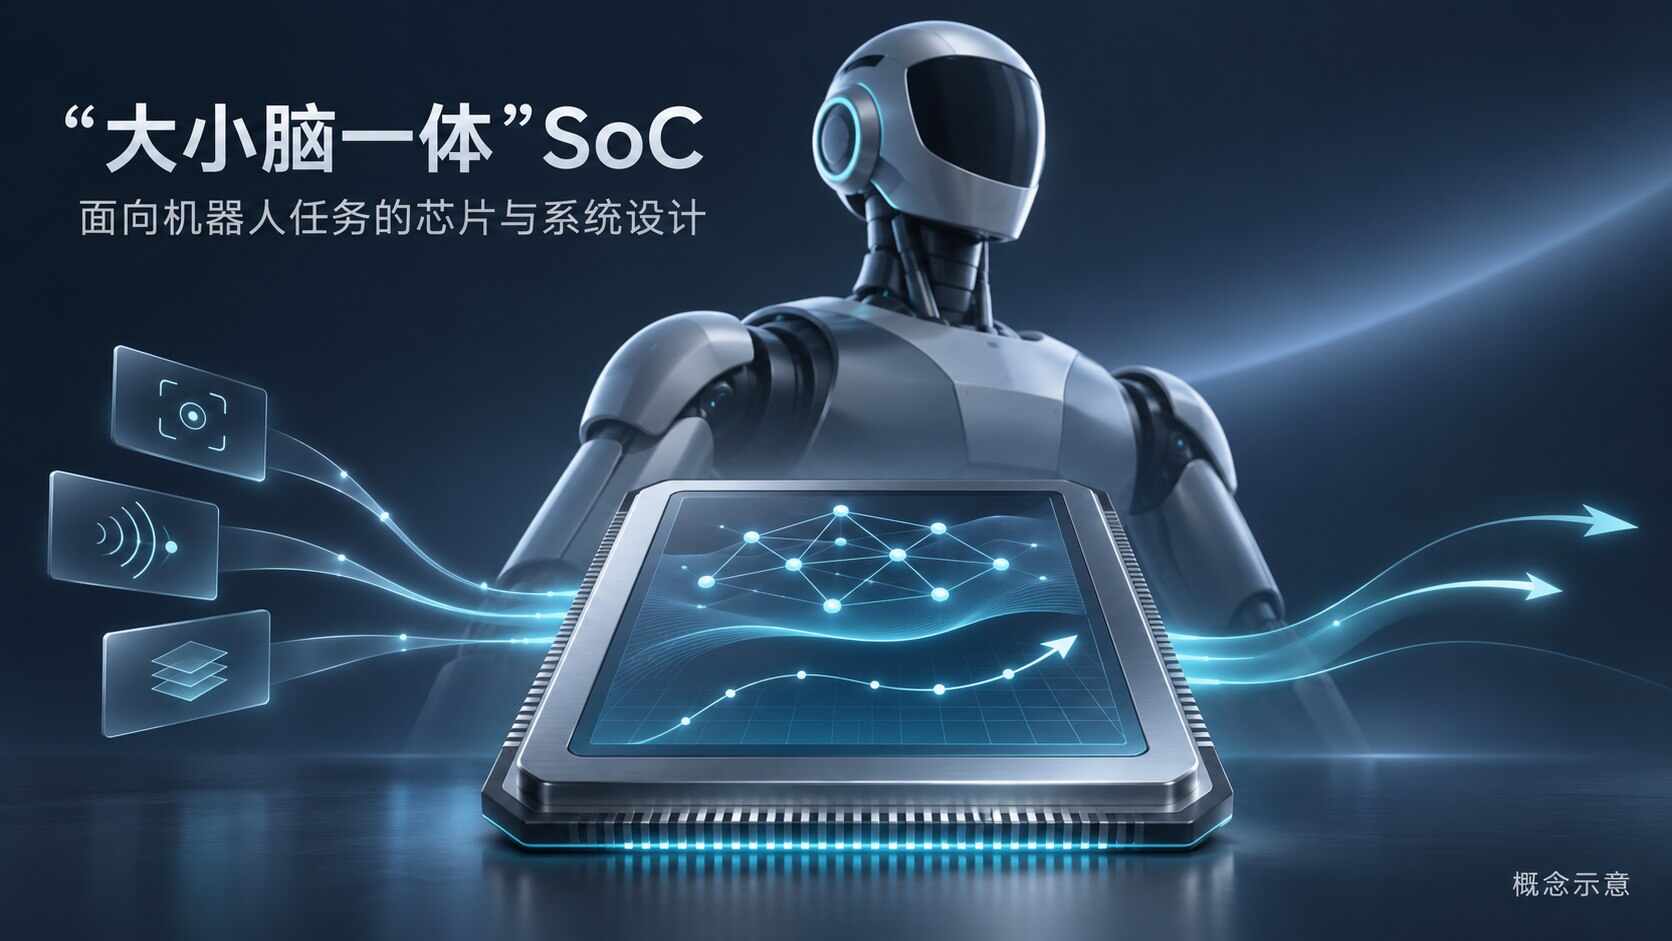
由优必选、沐曦股份联合发起的曦选创智完成 5 亿元天使轮融资,投后估值 40 亿元。公司聚焦自主可控具身智能端侧芯片,采用 “机器人真实任务牵引芯片定义” 路线,首颗自研主控 SoC 定位大小脑一体架构,对标 NVIDIA Thor,以通用 GPGPU 为核心、搭建类 CUDA 软件生态;本轮资金将投入芯片架构、工具链、团队建设与客户联合验证,计划 2027 年交付验证平台、2028 年推出正式 SoC 产品,补齐国产机器人端侧算力短板。

Nvidia(英伟达)

Supermicro 联合 IBM、NVIDIA 推出 KV Cache 存储方案 大幅优化长上下文 AI 推理 新品速递

Supermicro 联合 IBM、NVIDIA 推出 KV Cache 存储方案 大幅优化长上下文 AI 推理

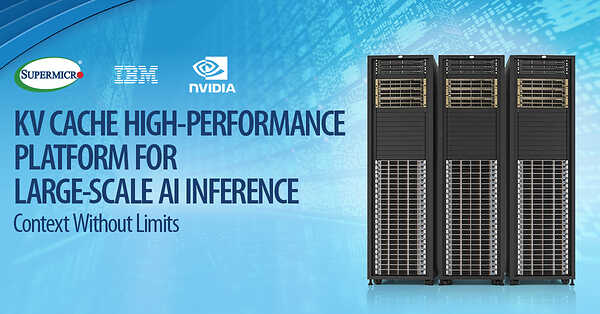
2026 年 11 月 5 日,Supermicro(美超微,SMCI)宣布携手 IBM、NVIDIA 推出全新 KV Cache 存储解决方案。整套方案搭载 AMD EPYC 9005(Turin)处理器的 Petascale 全闪存存储服务器、IBM Storage Scale、NVIDIA Dynamo 推理框架与 Spectrum-X 以太网,将 KV 缓存卸载至共享存储,突破 GPU 显存限制。基于 1200 亿参数大模型测试,13 万 token 输入下首个词元生成速度提升最高 56 倍,显著提升 GPU 利用率与推理吞吐量,适配 AI 智能体、RAG、多轮对话等长上下文业务。

互联技术 测试测量 存储器 Nvidia(英伟达)

链博会首发|云尖 R8260 N8 AI Agent 服务器:搭载 NVIDIA Vera CPU 新品速递

链博会首发|云尖 R8260 N8 AI Agent 服务器:搭载 NVIDIA Vera CPU

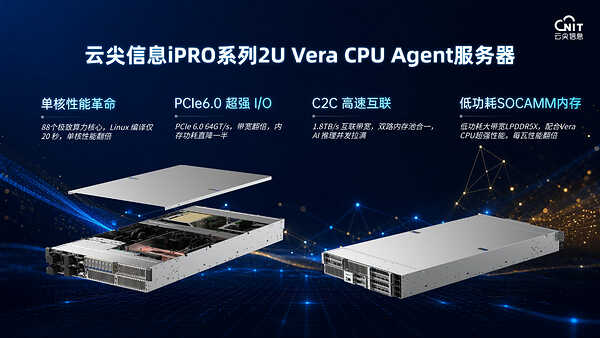
第四届链博会,云尖信息在 NVIDIA 展区发布 R8260 N8 AI Agent 服务器。这款 iPRO 系列 2U 机型搭载 NVIDIA Vera CPU,依托 PCIe 6.0、C2C 一致性互联,主打强单核、高带宽、低功耗,针对性解决 AI Agent 场景 CPU 拖累 GPU、KV Cache 受限等痛点,适配 AI 推理、企业级 Agent、HPC 等业务,兼顾性能与 TCO。

电源管理 互联技术 CPU Nvidia(英伟达)

Cadence 推出 Maestro 领域专用 AI 模型组合,赋能智能体芯片与系统 EDA 设计 新品速递

Cadence 推出 Maestro 领域专用 AI 模型组合,赋能智能体芯片与系统 EDA 设计

楷登电子(Cadence)正式推出 Maestro™领域专用 AI 模型组合,为半导体、系统设计流程中的 AI Super Agent 提供算力支撑。该方案垂直整合强化学习闭环,打通 Maestro 模型、AuraStack/ChipStack 等 Agent 套件与 Cadence EDA、SDA 工具链。实测对比通用大模型,设计成果质量最高提升 30%,Token 效率提升 5 倍;支持混合调用前沿大模型与领域专用模型,兼顾云端与客户本地私有化部署,NVIDIA、Socionext、Silicon Labs 已开展合作验证,首批 Maestro 模型将于 2026 年 Q4 面向早期客户开放。

Nvidia(英伟达)

特别推荐

更多

行业动态

更多

技术应用

更多

选型替代

更多

产品信息

更多

热门搜索

更多

欢迎登录

没有账号,

账号注册

注册成功!

3S后自动为你跳转登陆