 业界新闻
从卖 GPU 到卖 AI 工厂,物理 AI 赛道升温,量化派锚定跨场景物理基础模型
英伟达的GTC大会,把重心从“卖GPU”推向“卖AI工厂”,标志着全球AI产业正式从数字交互阶段全面向实体场景渗透。资本端同样在重定价:FieldAI在没有一台自研机器人的情况下将估值推至百亿美元量级。行业不缺本体,缺的是让本体在真实场景里开箱即用的能力层。

选型指南
发布时间:2026-03-18 00:00:00 责任编辑:lily
【导读】在数据中心推理需求呈爆发式增长的背景下,NVIDIA 于 GTC 2026 大会上正式推出了开源软件 NVIDIA Dynamo 1.0,旨在为大规模分布式推理构建生产级的基础架构。作为专为“AI 工厂”打造的分布式“操作系统”,Dynamo 1.0 通过与 NVIDIA Blackwell GPU 平台的深度协同,不仅将推理性能最高提升了 7 倍,更通过智能的资源编排与流量控制技术,有效解决了显存限制与资源浪费难题。
加利福尼亚州圣何塞 —— GTC —— 太平洋时间 2026 年 3 月 16 日 —— NVIDIA 今日宣布,用于大规模生成式和智能体推理的开源软件 NVIDIA Dynamo 1.0 现已在全球范围内被广泛采用。Dynamo 1.0 与 NVIDIA Blackwell 平台相结合,助力云提供商、AI 创新者和全球企业能够以无与伦比的规模、效率和速度提供高性能的 AI 推理服务。
随着代理式 AI 系统在各行各业的应用,数据中心内的推理扩展已成为一项复杂的资源编排挑战,不同规模、不同模态的请求以及性能目标会以不可预测的突发形式出现。
正如计算机的操作系统协调硬件和应用程序一样,Dynamo 1.0 作为 AI 工厂的分布式“操作系统”,在集群中无缝地协调 GPU 和显存、内存等存储资源,以驱动复杂的 AI 工作负载。在最近的行业基准测试中,Dynamo 将 NVIDIA Blackwell GPU 的推理性能至高提升 7 倍,并通过免费的开源软件降低了 Token 成本,为数百万 GPU 带来了增加收益的机会。
NVIDIA 创始人兼首席执行官黄仁勋表示:“推理是智能的引擎,驱动了每一次查询、每一个智能体以及每一个应用。通过 NVIDIA Dynamo,我们创建了首个面向 AI 工厂的‘操作系统’。整个生态系统中的快速采用表明新一波代理式 AI 浪潮已经到来,NVIDIA 正在全球范围内推动其发展。”
Dynamo 1.0 通过引入更智能的“流量控制”以及在 GPU 和低成本存储之间移动数据的能力,将推理工作分配到多个 GPU 上,从而减少了资源浪费并缓解了显存限制。针对代理式 AI 和长提示,它可以将请求路由到已在稍早步骤获得最相关“短期记忆”的 GPU,然后在无需使用时卸载该显存。
NVIDIA 推理平台发展势头强劲
通过将 NVIDIA Dynamo 和 NVIDIA TensorRT™ LLM 库优化集成到 LangChain、llm-d、LMCache、SGLang、vLLM 等各大供应商的热门框架中,NVIDIA 正在加速开源生态系统的发展。核心的 Dynamo 构建模块,例如用于实现更智能 KV 存储管理的 KVBM、用于实现快速 GPU 到 GPU 数据移动的 NVIDIA NIXL 以及用于简化扩展的 NVIDIA Grove,也可作为独立模块使用。NVIDIA 还将 TensorRT LLM CUDA® 内核贡献给 FlashInfer 项目,以便将其原生集成到开源框架中。
NVIDIA 推理平台在整个 AI 生态系统中得到支持,包括:
云服务提供商:亚马逊云科技 (AWS) 、微软 Azure、谷歌云、OCI
NVIDIA 云合作伙伴:阿里云、CoreWeave、Crusoe、DigitalOcean、Gcore、GMI Cloud、Lightning AI、Nebius、Nscale、Together AI、Vultr
AI 原生公司:Cursor、Hebbia、Perplexity
推理端点提供商:Baseten、Deep Infra、Fireworks
全球企业:阿斯利康、贝莱德、字节跳动、Coupang、Instacart、美团、PayPal、Pinterest、Shopee、软银集团
CoreWeave 产品和工程执行副总裁 Chen Goldberg 表示:“随着 AI 从实验性试点转向持续的大规模生产,底层基础设施必须像其支持的模型一样具备动态性。采用 NVIDIA Dynamo 使我们能够为部署复杂的 AI 智能体提供更无缝、更具弹性的环境。这一底座具有稳定性和高性能编排能力,助力业界具有挑战性的智能体工作负载实现全球部署。”
Nebius 首席技术官 Danila Shtan 表示:“大规模交付可靠的 AI 推理不仅需要强大的 GPU,还需要将性能转化为实际客户价值的软件。从 Dynamo 到 TensorRT LLM,我们高度重视 NVIDIA 的软件堆栈,其带来了深度优化、可预测的性能以及更快的部署速度,帮助我们为客户提供更简单、更高性能的 AI 生产路径。”
Pinterest 首席技术官 Matt Madrigal 表示:“为数亿用户提供直观的多模态 AI 体验,需要全球规模的实时智能。作为开源领域的重要实践者,我们致力于构建可扩展的 AI 技术。通过 NVIDIA Dynamo 对部署进行优化,我们得以基于高性能 AI 基础设施持续拓展,为用户提供无缝、个性化体验。”
Together AI 联合创始人兼首席执行官 Vipul Ved Prakash 表示:“AI 原生企业需要能够可靠、高效地随其应用规模而扩展的推理能力。NVIDIA Dynamo 1.0 与 Together AI 的前沿推理研究相结合,助力我们构建高性能堆栈,为大规模生产工作负载提供加速且经济高效的推理。”
NVIDIA Dynamo 1.0 的问世及其生态系统的快速扩张,确立了其作为新一代 AI 推理基础设施核心标准的地位。通过将 TensorRT LLM 优化原生集成至 LangChain、vLLM 等主流开源框架,并联合全球云服务提供商及 AI 创新企业共同部署,Dynamo 成功打破了算力扩展的瓶颈,显著降低了 Token 成本并提升了服务收益。
Dynamo 1.0 现已面向全球开发者推出。如需了解详情并开始使用,请点击博客并访问 Dynamo 页面。
为您推荐
业界新闻
英伟达的GTC大会,把重心从“卖GPU”推向“卖AI工厂”,标志着全球AI产业正式从数字交互阶段全面向实体场景渗透。资本端同样在重定价:FieldAI在没有一台自研机器人的情况下将估值推至百亿美元量级。行业不缺本体,缺的是让本体在真实场景里开箱即用的能力层。
 业界新闻
2026年——当AI工作负载从试点走向规模化生产,从代理式AI延伸到物理AI,算力基础设施的“天花板”正以前所未有的速度被逼近。今天,亚马逊云科技与NVIDIA宣布大幅扩展战略合作,计划于2027-2028年间在全球基础设施中新增部署200万个NVIDIA GPU,并将合作从GPU延伸至Vera CPU、NVHBM定制内存、Spectrum-X网络、Nemotron开放模型乃至机器人物理AI平台。
 市场分析
AI算力市场的竞争早已不限于芯片本身,服务器集群的交付速度、液冷方案和本地化服务能力正成为客户选择供应商的关键考量。8月25日,纳斯达克上市的SuperX AI Technology宣布,其日本子公司与当地客户Woodman签署了约3880万美元的采购订单,为其横滨AI基础设施项目提供基于NVIDIA B300 GPU的服务器集群,计划11月中旬交付。这是SuperX在日本市场的首笔商业合作,也是公司继RTX Pro 6000产品线布局后,在新一代高密度GPU算力平台上的又一次项目落地。
 选型指南
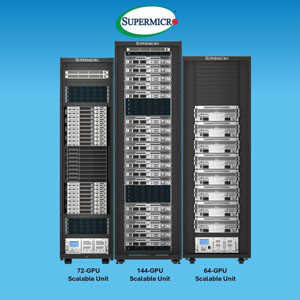
Supermicro(超微) 近日宣布其基于 NVIDIA Blackwell架构 的产品线实现重大扩展,正式推出并开始批量供货全新的 4U及2-OU(OCP)液冷式NVIDIA HGX B300系统。这不仅是硬件的迭代,更是其 “数据中心建构组件解决方案” 理念的深化实践,旨在为超大规模数据中心和AI工厂提供前所未有的 GPU计算密度 与 能源效率,直接回应了市场对更高性能、更低总拥有成本的迫切需求。
 技术应用
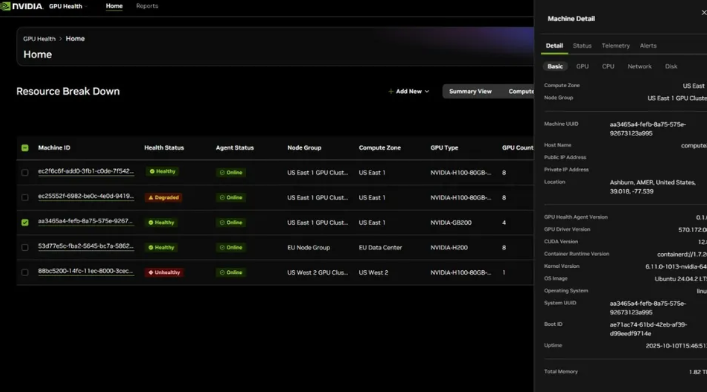
英伟达推出的可追踪GPU物理位置的车队监控软件备受关注。该软件聚焦AIGPU集群管理,通过NGC平台整合数据,实现GPU状态全方位可视化,能监控核心性能指标,其位置检测功能为反走私提供了新路径。但软件“选择加入”的模式及仅具备观察性、无强制干预能力的特点,使其威慑力受限,也引发了行业对工具功能与效用平衡的探讨,为运营商提供了管理参考。