【导读】AMD(超威,纳斯达克股票代码:AMD)宣布推出 AMD Alveo™ UL3524 加速卡,这是一款面向超低时延电子交易应用设计的新款金融科技( fintech )加速卡。Alveo UL3524 已由领先的交易公司进行了部署,并且支持多种解决方案合作伙伴产品,能够为自营交易商、做市商、对冲基金、经纪商和交易所提供一流的 FPGA 平台,以纳秒( ns )速度进行电子交易。
AMD(超威,纳斯达克股票代码:AMD)今日宣布推出 AMD Alveo™ UL3524 加速卡,这是一款面向超低时延电子交易应用设计的新款金融科技( fintech )加速卡。Alveo UL3524 已由领先的交易公司进行了部署,并且支持多种解决方案合作伙伴产品,能够为自营交易商、做市商、对冲基金、经纪商和交易所提供一流的 FPGA 平台,以纳秒( ns )速度进行电子交易。
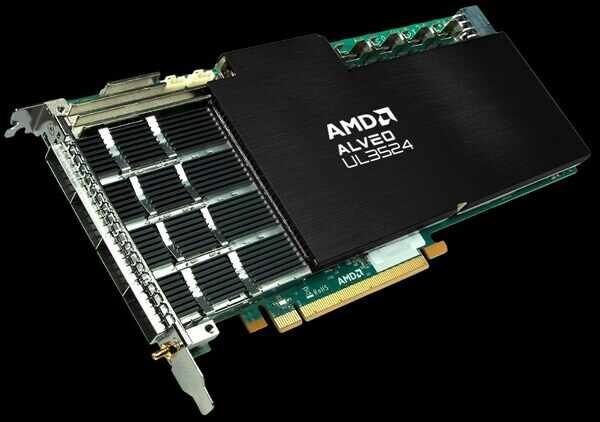
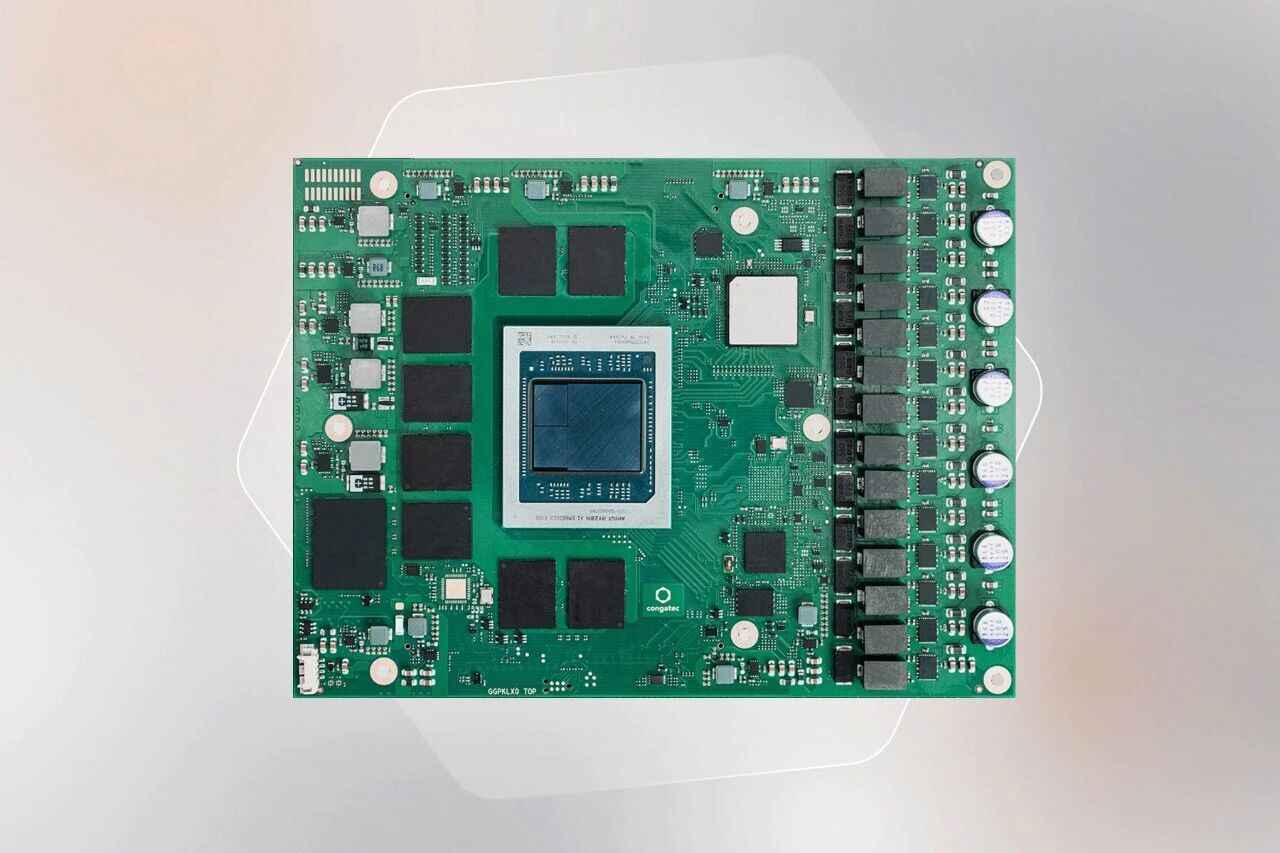
AMD Alveo UL3524 加速卡
较之上一代 FPGA 技术,Alveo UL3524 带来了 7 倍的时延提升[1],从而达到小于 3 纳秒的 FPGA 收发器时延[2],加速交易执行。其由定制的 16nm Virtex™ UltraScale™+ FPGA 提供支持,采用新颖的收发器架构,其具备硬化且经过优化的网络连接核,以实现突破性能。通过在量产平台上将硬件灵活性与超低时延网络相结合,Alveo UL3524 能够比传统 FPGA 替代方案更快实现设计收敛与部署。
AMD 产品营销总监 Hamid Salehi 表示:"在超低时延交易中,1 纳秒即可决定交易的盈亏。Alveo UL3524 加速卡由 AMD 超低时延 FPGA 收发器提供支持,专为给我们身处金融市场的金融科技客户带来可观的竞争优势而打造。"
硬件灵活性以及人工智能赋能的交易策略
Alveo UL3254 采用 64 个超低时延收发器、78 万个 FPGA 架构查找表( LUT )以及 1,680 个数字信号处理( DSP )计算片,旨在加速硬件中的定制交易算法,令交易商能够根据不断演进的策略和市场条件定制其设计。该产品为采用 Vivado™ 设计套件的传统 FPGA 流程所支持,配套提供一套参考设计和性能基准,使 FPGA 设计人员能够快速探索关键指标并根据规范开发定制交易策略,并得到 AMD 领域专家的全球支持。
为了简化人工智能( AI )在算法交易市场中日益普遍的采用,AMD 为开发人员提供了开源且受到社区支持的FINN 开发框架。通过使用 PyTorch 和神经网络量化技术,FINN 项目令开发人员能够在缩小 AI 模型尺寸的同时保持准确性、编译到硬件 IP 以及将网络模型集成到算法的数据路径中,带来低时延性能。作为一项开源计划,该解决方案为开发人员赋予了灵活性与可及性可,可随项目演进获取最新技术进展。
实现不断壮大的超低时延金融科技解决方案生态系统
Alveo UL3524 及专属打造的 FPGA 技术使战略合作伙伴能够为金融科技市场构建定制解决方案和基础设施。目前可供使用的合作伙伴解决方案包括来自 Alpha Data、Exegy 和 Hypertec 的产品。
为 Alveo UL3524 加速卡提供支持的 AMD Virtex™ UltraScale+ VU2P FPGA 使 Alpha Data 的超低时延设备成为可能。
Alpha Data 总经理 David Miller 表示:"AMD 的新款 Virtex UltraScale+ FPGA 为超低时延交易和网络带来了跨越式改进。我们开发的 ADA-R9100 机架式设备使客户能够轻松地充分发挥全新 AMD FPGA 器件的全部潜力。"
Exegy 作为端到端前台交易解决方案提供商,正在利用其 nxFramework 为 Alveo UL3524 卡提供支持。nxFramework 是一种软件与硬件开发环境,专为在金融行业内创建和维护超低时延 FPGA 应用定制而成。
Exegy FPGA 解决方案总监 Olivier Cousin 表示:"通过结合 AMD 开创性的超低时延 FPGA 技术与 Exegy 在资本市场的专长,我们得以提供一款综合全面的解决方案,应对构建未来交易基础设施所需面临的日益增多的优化问题。"
针对 Alveo UL3524,Hypertec 借助定制冷却系统优化了其 ORION HF X410R-G6 高频服务器,使之部署在 1U 服务器尺寸规格中。
Hypertec 产品营销总监 David Lim 表示:"Hypertec 工程师专门设计了 HF X410R-G6,以充分施展 Alveo UL3524 平台的功能和速度,使我们的解决方案能够满足低时延任务极其严苛的需求。"
AMD Alveo UL3524 加速卡目前已投入量产,并向全球金融服务客户供货。
相关资源
关于AMD
在超过五十年的历史中,AMD(超威半导体)引领了高性能运算、图形,以及可视化技术方面的创新。全球数十亿计的人们、领先的 500 强公司,以及尖端科学研究所都依靠 AMD 技术来改善他们的生活、工作以及娱乐。AMD 员工致力于打造领先的高性能和自适应产品,努力拓宽技术的极限。成就今日,启迪未来。
|
AMD、AMD Arrow 标识、Alveo、Virtex、Vivado 及其组合为超威半导体公司的商标。其它名称仅供参考之用,可能是其各自所有者的商标。
|
|
[1] 截至 2023 年 8 月 16 日,AMD 性能实验室使用 Vivado™ Design Suite 2023.1,对运行在 Vivado Lab(硬件管理器) 2023.1 上的 Alveo UL3524 加速卡进行了测试。基于 GTF 时延基准设计,经过配置,可在内部近端回送模式下启用 GTF 收发器。GTF TX 和 RX 时钟在大约 644MHz 的相同频率下工作,相移为 180 度。GTF 时延基准设计通过锁存单个空闲运行计数器的值来测量硬件中的时延。时延即为 TX 数据在 GTF 收发器处锁存的时间与其在路由回 FPGA 架构之前在 GTF 接收器处锁存的时间之间的差值。时延测量不包括协议开销、协议帧、可编程逻辑 (PL) 时延、TX PL 接口设置时间、RX PL 接口时钟输出、包飞行时间和其它时延来源。基准测试运行了 1,000 次,每次测试 250 帧。引用的测量结果基于 GTF 收发器"RAW 模式",其中收发器的物理介质连接子层 (PMA) 将数据"按原样"传递到 FPGA 架构。时延测量结果在此配置的所有测试运行中保持一致。系统制造商可能会修改配置,因此产生不同的结果。ALV-10
|
|
[2] 基于 Virtex UltraScale+ GTY 收发器与超低时延 GTF 收发器的仿真比较。
|
稿源:美通社
免责声明:本文为转载文章,转载此文目的在于传递更多信息,版权归原作者所有。本文所用视频、图片、文字如涉及作品版权问题,请联系小编进行处理。
推荐阅读:
Microchip推出业界首款支持I3C的低引脚数MCU系列产品
Molex莫仕推出MX60系列非接触式连接解决方案
瑞萨电子推出全新16位RL78G24 MCU,为电机控制和电源控制系统提供卓越性能
Diodes推出具备电源正常指示且符合汽车规格的 300mA 输出 LDO
Bourns 推出全新高能量二电极 GDT 系列 具备极高额定电流,适用于交流电力线应用


 业界新闻