【导读】BiCS FLASH是铠侠自主研发的3D NAND闪存技术品牌,也是目前全球主流存储芯片的核心技术路线之一。BiCS的含义可以理解成Bit Cost Scaling,即位成本缩放,核心理念是通过三维垂直堆叠存储单元,在降低每比特存储成本的同时,突破传统2D NAND的物理微缩极限。
在芯片有限的面积内平地起高楼,让铠侠BiCS FLASH创造了许多可能性。如今,第八代BiCS FLASH在行业内广受好评,第九代与第十代BiCS FLASH在今年内蓄势待发。现在不妨让我们花一点时间,了解第八代BiCS FLASH,第九代与第十代BiCS FLASH一些有意思的细节,看看BiCS FLASH是如何演进的。
广受好评的第八代BiCS FLASH
铠侠第八代BiCS FLASH是2024年量产的里程碑产品,能过做到218层堆叠,并且凭借着优秀的横向缩放技术,其位密度达到18.3Gb/mm²,在行业同一代产品中属于佼佼者。不仅如此,第八代BiCS FLASH率先做到了3.6Gbps的接口速度,也是同一时期行业领先水平,也进而帮助UFS 4.1、高性能企业级和数据中心级SSD获得更好的性能和功耗表现,在业内广受好评。
而第八代BiCS FLASH真正的突破不局限于层数堆叠和密度提升,引入的CMOS直接键合到阵列架构(CMOS Directly Bonded to Array, CBA)让第八代BiCS FLASH产生了质变,并进一步影响后续第九代和第十代BiCS FLASH快速进化。
传统3D NAND将存储单元阵列与外围CMOS控制电路制造在同一片晶圆上。由于制造3D NAND和外围CMOS控制电路所需要的最佳温度并不相同,因此统一制造时,只能相互包容,寻找其中的温度平衡点,从而导致工艺相互制约。CBA架构的优势是将3D NAND将存储单元阵列与外围CMOS控制电路制造完全分离,存储阵列与 CMOS 电路分别在各自最优化的晶圆上完成工艺,再通过高精度晶圆键合技术贴合,从而实现各司其职、协同优化,从而换来更好的收益。
因此第八代BiCS FLASH相对第六代BiCS FLASH芯片面积缩小15%以上,CMOS电路独立采用更先进制程,信号传输速度提升30%,写入性能提升20%,读延迟降低10%,写入能耗降低30%,从而帮助第八代BiCS FLASH获得如此优秀的表现。
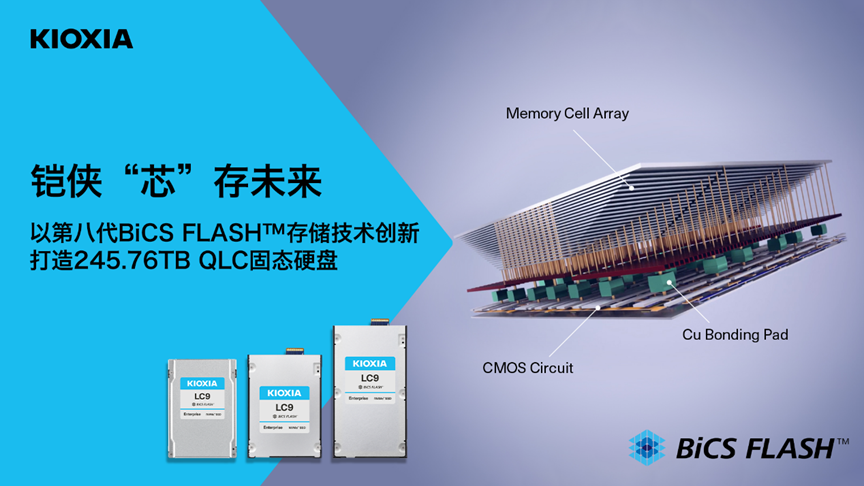
不仅如此,QLC技术作为第八代BiCS FLASH其中一个重要分支,也实现了大规模成熟量产,从而做到单Die 2Tb,配合32Die封装堆叠,造就了256TB级别的企业级SSD产品,为时下热门的AI算力提供海量的KV Cache,仅单盘容量就获得过去数块SSD才能实现的效果。
目前第八代BiCS FLASH不仅广泛应用于友商的产品中,同时也在铠侠自由品牌的产品广泛普及,包括高达245.76TB容量的铠侠LC9系列,用于端侧的BG7系列,用于数据中心和企业级的CD9P系列,以及已经在高端手机中投入使用的铠侠UFS 4.1产品。
双轨并行,加速发展
随着行业快速发展,特别是AI对存储需求出现井喷,单一的芯片设计很难满足成本、制造周期、供货等复杂环境需求。因此铠侠同时推出了第九代与第十代 BiCS FLASH,两者并非相互升级替代关系,而是双轨并行,解决不同的行业需求。
简单的说第九代BiCS FLASH侧重成熟产能优化,第十代BiCS FLASH追求密度与性能的极限突破。
第九代的核心任务是将CBA架构的产能和成本优势最大化,它延续成熟的存储单元技术,整合最新CMOS工艺,通过CBA技术配合成熟产线,实现高性能。这与行业著名的“Tick-Tock”策略有点类似,通过现有产线和技术的再优化,结合CBA技术,以及最新的CMOS逻辑单元,就能在短期内获得更好的收益。
相对第六代BiCS FLASH,第九代BiCS FLASH写入性能提高 61%、读取性能提高 12%,功耗改善约 30%。接口方面升级至Toggle DDR 6.0,为主流企业级SSD、智能手机UFS及边缘计算提供稳定、可大规模供货的解决方案。
第十代BiCS FLASH则是探索存储前沿技术的全新产品,可以将其看成铠侠面向AI时代存储的重要产品线。第十代BiCS FLASH堆叠层数来到332层,总层数增加52%,位密度相对第八代BiCS FLASH提升59%。
第十代BiCS FLASH具备Toggle DDR 6.0接口 和独立命令地址协议(SCA),NAND I/O速度从3.6Gbps提升至4.8Gbps,增幅33%。并且引入PI-LTT低功耗技术,数据输入功耗降显著降低。更重要的是,第十代BiCS FLASH TLC能够做到更大容量的产品,为AI数据中心对低延迟、高带宽、超大容量的极致需求提供物理层支撑。
向未来布局
可以看到,第九代与第十代BiCS FLASH并非简单的代际替换,而是精准匹配不同场景需求的互补策略。第九代BiCS FLASH面向移动终端、客户端 SSD 等对产能、可靠性和成本敏感的市场,让高端存储技术更具普及性;第十代BiCS FLASH则专攻 AI 训练、科学计算及超大规模数据中心,以更高密度和带宽满足存储级内存与海量数据摄取的需求,从而推进高性能企业级SSD,UFS 5.0等产品升级。
铠侠正积极将BiCS FLASH技术与AI基础设施存储方案融合,推出符合NVIDIA Storage-Next架构产品,加速产业生态发展。不仅如此,更具前瞻性的XL-FLASH产品也再度提升了性能,铠侠近期发布的GP系列SSD拥有超高IOPS,进而成为HBM之外另一种高效扩展成的可选项。
可以这么说,第八代BiCS FLASH通过CBA架构解决了存储密度与外围电路性能相互制约的行业痛点,第九代和第十代BiCS FLASH不仅延续了CBA架构优势,也满足了更为复杂的市场环境需求。同时,这也少不了行业内合作伙伴的共同努力,铠侠也将持续推进BiCS FLASH技术升级,与行业伙伴一起,探寻更多存储与AI的可能性。

 新品速递