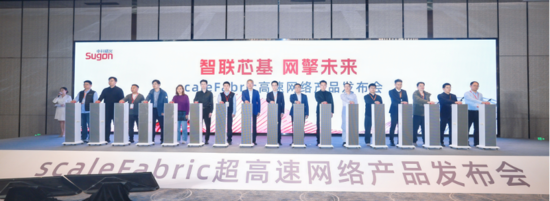
【导读】3月12日,中科曙光正式发布了首款全栈自研的400G无损高速网络——scaleFabric,标志着中国在国产高端原生RDMA(远程直接内存访问)技术领域取得重大突破。面对AI大模型训练对万卡级算力集群日益增长的需求,以及长期以来高端网络产业链被海外厂商垄断的局面,scaleFabric凭借从底层SerDes IP、核心芯片到上层管理软件100%的自主研发能力,成功填补了国内数据中心高速网络领域的空白。这款产品以比肩甚至部分超越国际顶尖同类产品的性能,为构建安全、可控、高效的超大规模智算集群铺就了一条高带宽、低时延、真无损的“算力大动脉”。
高端智算互联待破局
随着AI大模型训练与高通量推理计算需求持续扩大,万卡级乃至更大规模的算力集群正成为主流形态。研究表明,在大规模分布式训练中,网络通信耗时占比已达到30-50%,网络性能直接影响算力系统的整体效率。
在大规模智算集群领域,RDMA(远程直接内存访问)网络已成为算力中心的基本需求,凭借零丢包、高带宽、低延迟等特征,可极大提升通信效率。其中,InfiniBand凭借低时延与原生无损传输能力,在全球顶级超算与AI集群中被广泛采用。根据TOP500榜单,目前全球约60%的高性能计算系统采用InfiniBand网络架构。
长期以来,从高速SerDes IP、核心芯片到IB网卡、IB交换机等设备,InfiniBand相关产业链基本被海外厂商垄断。随着AI算力需求快速增长及数据中心网络持续演进,自主高性能RDMA网络正成为产业关注焦点。中国工程院院士邬贺铨表示,高速网络作为算力基础设施的核心关键技术,其自主可控性直接关系到国家算力基础设施的安全与发展质量。在大模型训练和智算集群规模化部署背景下,网络需要同时具备超低延迟、超高带宽与无损传输能力,而RDMA高速网络正是智算集群的“算力大动脉”。
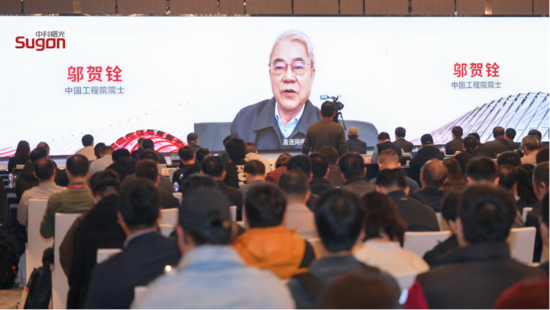
中国工程院院士邬贺铨 视频致辞
国产原生RDMA问世
scaleFabric是国内首款原生无损RDMA高速网络,面向超大规模智算集群设计,从核心关键IP、交换芯片、网卡到交换机、驱动与管理软件均实现自主研发,构建起从硬件到软件的完整技术体系。
此次发布的scaleFabric400系列网络产品技术规格全面对标英伟达NDR,部分指标实现赶超。性能方面,scaleFabric400网卡基于PCIe5.0接口,端口带宽达400Gbps,端到端通信时延低至0.9微秒;scaleFabric400交换机单端口带宽达800Gbps,整机交换容量可达双向64Tbps,交换时延约260纳秒,支持800G×40或400G×80端口扩展。这一性能组合,可充分满足万卡级AI训练集群对高带宽、低时延网络的极致需求。
稳定性与扩展能力上,产品采用基于信用的无损流控机制,从根源规避拥塞丢包风险,链路故障恢复时间小于1毫秒,已支撑近万卡集群持续稳定运行验证超10个月。与英伟达NDR相比,交换机端口密度提升25%,网卡最大QP数支持提升100%,单子网互连规模是传统IB的2.33倍,可轻松支持最大11.4万卡集群部署,同时网络总成本可降低30%。
在大规模AI训练系统中,网络互联能力已成为影响算力利用率的关键变量。scaleFabric的发布,标志着国产智算网络在高端RDMA领域实现重大突破。
万卡集群率先验证
在实际应用层面,scaleFabric目前已部署于国家超算互联网郑州核心节点,支撑三套万卡级scaleX智算集群上线运行,总规模达3万卡。中科曙光高级副总裁李斌表示,随着产品在超大规模智算集群中的落地应用,国产原生RDMA技术路线正逐步走向成熟,围绕其形成的高性能网络产业生态也正在加速形成。
运行数据显示,该网络系统在大规模集群环境中保持稳定运行,可支持跨POD组网及大规模并行训练任务,为国产原生无损RDMA网络在高端智算基础设施中的应用提供了实践验证。
依托在高性能计算、存储与网络领域的长期技术积累,中科曙光已逐步形成“算—存—网”协同发展的完整算力底座能力,为大规模AI基础设施提供系统级支撑。随着政府工作报告提出持续推进“人工智能+”,算力基础设施正进入新一轮升级周期。国产原生RDMA网络的落地,意味着我国在智算互联这一关键环节开始形成自主技术路径,补齐了我国智算基础设施中的关键一环。
通过实现端到端的完全自研并大幅降低网络总成本,中科曙光补齐了“算—存—网”协同发展的关键一环,打破了国外技术垄断,为应对未来“人工智能+”战略下的算力升级需求提供了坚实的底层支撑,加速推动了高性能网络产业生态的成熟与国产化进程。

 新品速递