【导读】NVIDIA于推出四款推理平台。这些平台针对各种快速兴起的生成式AI应用进行了优化,能够帮助开发人员快速构建用于提供新服务和洞察的AI驱动的专业应用。
谷歌云、D-ID、Cohere将新平台用于各种生成式AI服务,包括聊天机器人、文本生成图像内容、AI视频等。
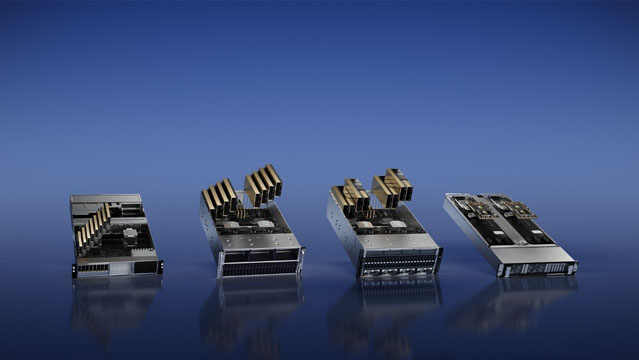
加利福尼亚州圣克拉拉 - GTC - 太平洋时间2023年3月21日 – NVIDIA于今日推出四款推理平台。这些平台针对各种快速兴起的生成式AI应用进行了优化,能够帮助开发人员快速构建用于提供新服务和洞察的AI驱动的专业应用。
这些平台将NVIDIA的全栈推理软件与最新的NVIDIA Ada、Hopper和Grace Hopper处理器相结合,包括今天推出的NVIDIA L4 Tensor Core GPU和NVIDIA H100 NVL GPU。各平台针对AI视频、图像生成、大型语言模型部署、推荐系统推理等需求激增的工作负载进行了优化。
NVIDIA创始人兼首席执行官黄仁勋表示:“生成式AI的兴起需要更加强大的推理计算平台。生成式AI应用的数量是无限的,它唯一的限制就是人类的想象力。为开发人员提供最强大、灵活的推理计算平台将加快新服务的创造速度,这些新服务将以前所未有的方式改善我们的生活。”
加速生成式AI的各种推理工作负载集
每个平台都包含一个为特定生成式AI推理工作负载而优化的NVIDIA GPU和专用的软件:
适用于AI视频的NVIDIA L4可提供比CPU高出120倍的AI视频性能,同时能效提高了99%。这款适用于几乎所有工作负载的通用GPU提供更加强大的视频解码和转码能力、视频流式传输、增强现实、生成式AI视频等。
适用于图像生成的NVIDIA L40针对图形以及AI支持的2D、视频和3D图像生成进行了优化。L40平台是NVIDIA Omniverse™(一个用于在数据中心构建和运行元宇宙应用的平台)的引擎,与上一代产品相比,其Stable Diffusion推理性能提高了7倍,Omniverse性能提高了12倍。
适用于大型语言模型部署的NVIDIA H100 NVL是规模化部署像ChatGPT这样的大型语言模型(LLMs)的理想平台。这款新的H100 NVL拥有94GB内存和Transformer引擎加速,在数据中心规模,与上一代A100相比,GPT-3上的推理性能提高了多达12倍。
适用于推荐模型的NVIDIA Grace Hopper是图形推荐模型、矢量数据库和图神经网络的理想平台。通过NVLink-C2C以900 GB/s 的速度连接CPU和GPU,Grace Hopper的数据传输和查询速度比PCIe 5.0快了7倍。
这些平台的软件层采用NVIDIA AI Enterprise软件套件,包括用于高性能深度学习推理的软件开发套件NVIDIA TensorRT™,以及帮助实现模型部署标准化的开源推理服务软件NVIDIA Triton Inference Server™。
早期采用者与支持
谷歌云是NVIDIA推理平台的重要云合作伙伴和早期客户。该公司正在将L4平台整合到其机器学习平台Vertex AI中,并且是第一家提供L4实例的云服务提供商,其G2虚拟机的私人预览版已于今天推出。
NVIDIA和谷歌今天分别宣布了首批在谷歌云上使用L4的两家机构——Descript和WOMBO,前者使用生成式AI帮助创作者制作视频和播客,后者提供“Dream”这一AI驱动的文本-数字艺术转换应用程序。
另一个早期采用者快手提供了一个短视频应用程序,利用GPU对传入的实时流媒体视频进行解码、捕捉关键帧并优化音视频。然后,它使用一个基于Transformer的大型模型理解多模态内容,从而提高全球数亿用户的点击率。
快手高级副总裁于越表示:“快手推荐系统所服务的社区每天的用户人数超过3.6亿,他们每天贡献3000万条UGC视频。在相同的总体拥有成本下,相较于CPU,NVIDIA GPU将系统的端到端吞吐量提高了11倍,将延迟降低了20%。”
领先的生成式AI技术平台D-ID,通过使用NVIDIA L40 GPU从文本中生成逼真的数字人,支持任何内容来生成人脸,不仅帮助专业人士改进视频内容,同时减少了大规模视频制作的成本和麻烦。
D-ID研发副总裁Or Gorodissky表示:“L40的性能十分惊人。有了它,我们将推理速度提高了一倍。D-ID十分高兴能够将这个新硬件作为我们产品的一部分,以前所未有的性能和分辨率实现AI人的实时流传输,并降低我们的计算成本。”
领先的AI制作工作室Seyhan Lee使用生成式AI为电影、广播和娱乐行业开发沉浸式体验和迷人的创意内容。
Seyhan Lee联合创始人Pinar Demirdag表示:“L40 GPU为我们的生成式AI应用带来了惊人的性能提升。凭借L40的推理能力和内存容量,我们可以部署非常先进的模型,并以惊人的速度和精度向客户提供创新的服务。”
语言AI领域的先锋Cohere所运行的平台使得开发人员能够在保护数据隐私和安全的情况下,构建自然语言模型。
Cohere首席执行官Aidan Gomez表示:“凭借NVIDIA的全新高性能H100推理平台,我们可以使用先进的生成式模型为客户提供更加优质、高效的服务,推动对话式AI、多语言企业搜索、信息提取等各种NLP应用的发展。”
供应情况
NVIDIA L4 GPU私人预览版现已通过谷歌云平台以及30多家计算机制造商所组成的全球网络提供。
NVIDIA L40 GPU现已通过全球领先的系统提供商提供,并且合作伙伴平台的数量将在今年持续增加。
Grace Hopper超级芯片已开始样品供货,预计下半年将全面投产。H100 NVL GPU也将于下半年面市。
NVIDIA AI Enterprise现在通过各大云市场以及数十家系统提供商和合作伙伴提供。NVIDIA AI Enterprise为客户提供NVIDIA 企业级支持、定期安全审查以及NVIDIA Triton Inference Server™、TensorRT™和50多个预训练模型与框架的API稳定性。
NVIDIA LaunchPad上免费提供的动手实验室可以试用用于生成式AI的NVIDIA推理平台。样品实验室的内容包括训练和部署一个客服聊天机器人、部署一个端到端AI工作负载、在H100上调整和部署一个语言模型以及使用NVIDIA Triton部署一个欺诈检测模型。
关于 NVIDIA自1993年成立以来,NVIDIA (NASDAQ: NVDA) 一直是加速计算领域的先驱。NVIDIA 1999年发明的GPU驱动了PC游戏市场的增长,并重新定义了现代计算机图形,开启了现代AI时代,推动了元宇宙的创建。NVIDIA现在是一家全栈计算公司,其数据中心规模的产品正在重塑整个行业。
免责声明:本文为转载文章,转载此文目的在于传递更多信息,版权归原作者所有。本文所用视频、图片、文字如涉及作品版权问题,请联系小编进行处理。
推荐阅读:
Microchip推出全新MPLAB SiC电源模拟器,助力客户在设计阶段测试SiC电源解决方案
三星公布应用于移动及汽车设备的厘米级超宽带解决方案
大联大友尚集团推出基于ST产品的超声波氧气浓度传感器模块方案
Qorvo发布TOLL 封装的高功率 5.4mΩ 750V SiC FETs
Transphorm和伟诠电子合作发布集成式GaN SiP

 业界新闻