选型指南

Supermicro多节点、多GPU的平台为视频直播、云端游戏和社交网络应用提供高效能和弹性

发布时间:2021-03-01 00:00:00 责任编辑:lina

【导读】Super Micro Computer, Inc. 为企业级运算、储存、网络解决方案和绿色运算技术等领域的全球领导者,今日发布与市面上其他现有产品截然不同创新的全新多节点 GPU 解决方案的详细资料。此多节点系统采用共享的电源与散热,可省下多达 10% 的总体拥有成本 (TCO)。
 
Supermicro多节点、多GPU的平台为视频直播、云端游戏和社交网络应用提供高效能和弹性

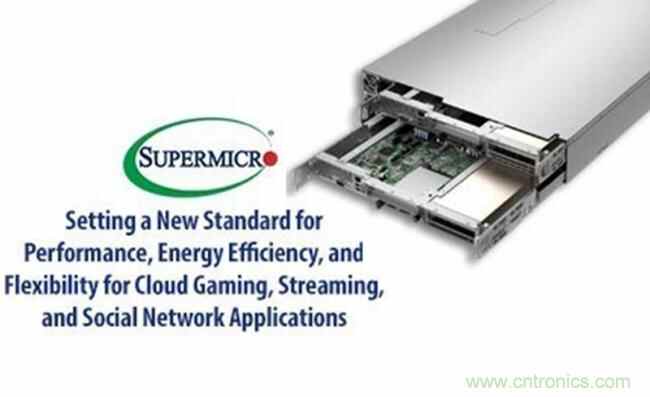
2021年2月27日,Super Micro Computer, Inc. (Nasdaq:SMCI) 为企业级运算、储存、网络解决方案和绿色运算技术等领域的全球领导者,今日发布与市面上其他现有产品截然不同创新的全新多节点 GPU 解决方案的详细资料。此多节点系统采用共享的电源与散热,可省下多达 10% 的总体拥有成本 (TCO)。全新 2U 2 节点高效能和节能的系统设计,每节点可搭载最多 64 个核心和 128 个 PCIe 4.0 通道,可有三个双宽的 PCIe 4.0 GPU 或六个单宽的 PCIe GPU 全速运作。
 
Supermicro 执行长暨总裁 Charles Liang 表示:“我们的全新 2U 2 节点多 GPU 服务器是适用于视频直播、高阶云端游戏和无数社交网络应用的理想平台。凭借我们的先进服务器 Building BlockSolutions® 设计和高效能架构,能使客户的部署成为最节能的系统。Supermicro 可提供领先市场的系统弹性和成本节约效益,带给客户源源不绝的效能。来自世界各地的客户已向我们表达对此独特平台有高度的市场兴趣。”
 
搭载 AMD EPYC 7002 系列和新一代处理器,每节点具有 64 个核心和 128 个 PCIe 4.0 通道,具备热效率、流线型的气流,使这款高密度的多 GPU 系统发挥不间断的顶尖效能。本产品是多重实例的高阶云端游戏和许多其他运算密集型数据中心应用程序的理想选择。系统配备 Supermicro 的进阶 I/O 模块 (AIOM),可实现快速且具有弹性的网络功能,还可处理庞大数据流,应付高需求的 AI/ML 应用、深度学习训练和推论。
 
独特的多 GPU 节点设计,展现出色的可维修性,与市面上其他现有产品截然不同。由于共享电源和散热资源,2U 系统内的两节点抽屉可各自抽出,便于维修。此独特设计和 GPU 的方便检修性,降低了高需求 GPU 加速应用程序 (例如云端游戏) 的维护与升级成本,这些应用程序通常需要保持高效能运作和经常性的维护。
 
 
免责声明:本文为转载文章,转载此文目的在于传递更多信息,版权归原作者所有。本文所用视频、图片、文字如涉及作品版权问题,请电话或者邮箱联系小编进行侵删。

 

为您推荐

芯原股份推出 GLTiny 轻量 GPU 编程模型,面向资源受限可穿戴设备优化 3D 图形开发 新品速递

芯原股份推出 GLTiny 轻量 GPU 编程模型,面向资源受限可穿戴设备优化 3D 图形开发

芯原股份(芯原,股票代码:688521.SH)今日宣布推出创新的3D图形处理(GPU)编程模型GLTiny,其专为功耗和内存资源受限的可穿戴设备而设计。GLTiny提供精简的应用程序编程接口(API),并配备超轻量级驱动,使开发者能够利用芯原Nano OpenGL ES GPU IP系列的3D图形处理能力,为下一代智能手表、智能眼镜及其他资源受限的可穿戴设备带来丰富的视觉体验。

医疗穿戴 电源管理 互联技术 GPU ES(恩盛)

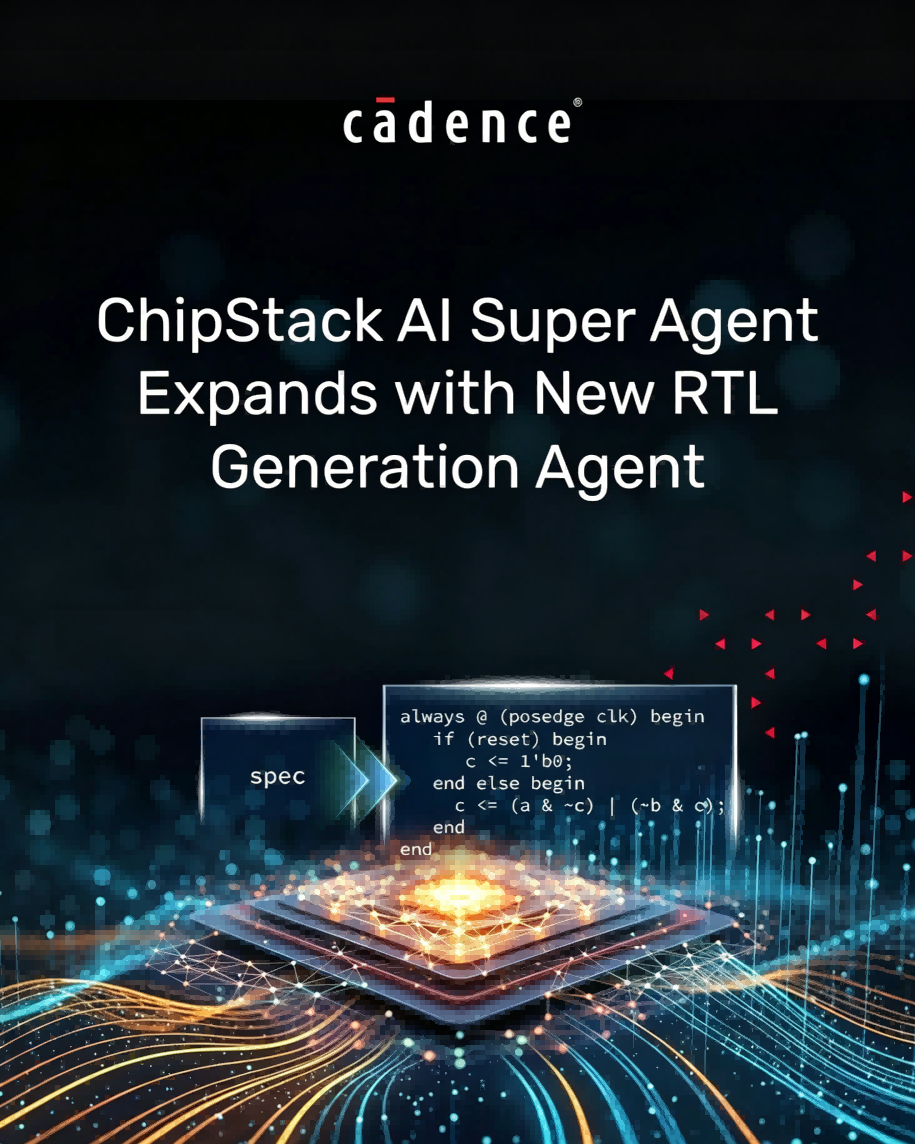
Cadence 拓展ChipStack AI Super Agent,新增面向 RTL 生成与早期 PPA 优化的智能体 业界新闻

Cadence 拓展ChipStack AI Super Agent,新增面向 RTL 生成与早期 PPA 优化的智能体

楷登电子(美国 Cadence 公司,NASDAQ:CDNS)近日宣布为Cadence® ChipStack™ AI Super Agent 新增一款智能体,可实现前端数字设计与验证自动化。该智能体可通过自然语言提示,支持以功耗、性能和面积(PPA)驱动的规格到 RTL 生成、RTL 分析与优化。该 RTL 生成式智能体建立在 2026 年 2 月发布的业界首个面向前端设计与验证的智能体工作流之上,将 ChipStack AI Super Agent 从自主验证与调试扩展至高质量 RTL 创建与优化。在早期评估中,与完全依赖基础模型代码生成相比,该 RTL 生成式智能体平均实现了 24% 的面积缩减和 18% 的功耗降低,同时确保 RTL 功能 100% 准确,进一步彰显了其面向 PPA 优化的高性能数字设计与验证智能体工作流的全面性。

电源管理 SUPER(杰耐特)

性能全面跃升 Imagination E系列GPU落地全能融合架构 夯实GPU-First战略 业界新闻

性能全面跃升 Imagination E系列GPU落地全能融合架构 夯实GPU-First战略

2026年9月21日(北京)——Imagination Technologies(以下简称“Imagination”)今日公布了其E系列GPU IP的首批性能数据和演示结果,并推出全新的Neural Super Resolution(NSR,神经超分辨率)AI加速超分辨率解决方案。这些最新进展进一步体现了Imagination的GPU-first战略:通过一套架构和一套软件栈,让芯片设计厂商能够运行图形、计算和AI等不同类型的工作负载。

GPU SUPER(杰耐特)

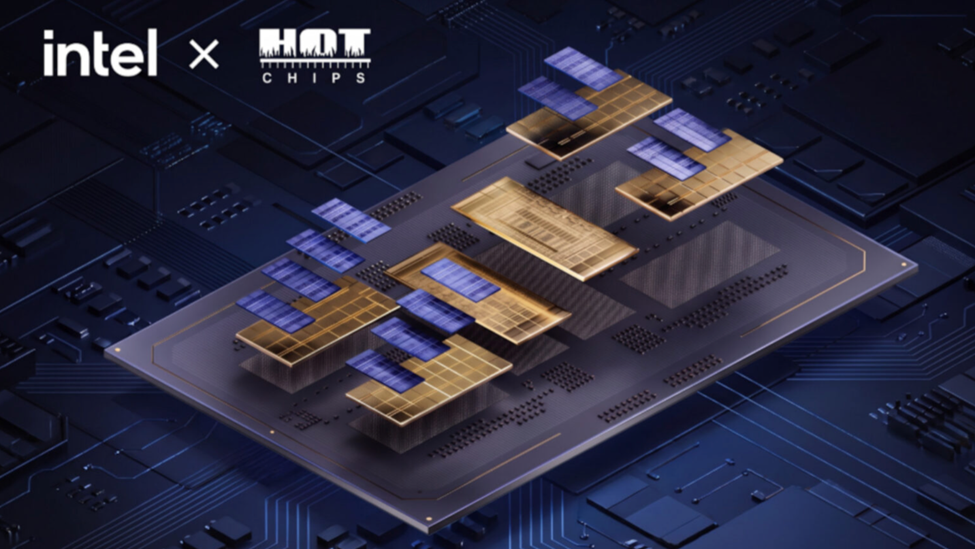
英特尔Hot Chips 2026连发三款架构:256核至强、350W推理GPU、17TOPS NPU 行业活动

英特尔Hot Chips 2026连发三款架构:256核至强、350W推理GPU、17TOPS NPU

Hot Chips 2026上,英特尔一次性端出三款新架构:面向企业级智能体AI的Diamond Rapids处理器、专攻高效推理的Crescent Island GPU,以及针对主流客户端和边缘计算的Wildcat Lake SoC。三者共享Intel 18A制程、Foveros Direct 3D封装和UCIe芯粒互连标准。英特尔CTO Pushkar Ranade表示,智能体AI正重构计算平台的构建方式,通用计算与专用加速必须融合先进封装和开放芯粒,才能在功耗和成本约束下真正落地。

电源管理 GPU DIAMOND(钻石牌)

Imagination E 系列 GPU 斩获架构创新奖 融合算力架构破解物理 AI 系统设计难题 业界新闻

Imagination E 系列 GPU 斩获架构创新奖 融合算力架构破解物理 AI 系统设计难题

8 月 20 日,第六届集成电路设计创新会议暨应用展(ICDIA 2026)在南京顺利举办,Imagination E 系列 GPU IP 凭借领先的端侧 AI 与图形融合架构创新,成功入选 “2026 强芯 TOP100” 并斩获架构创新奖。同期的具身智能生态论坛上,Imagination 进一步分享了面向机器人领域的 GPU 融合计算加速方案。针对当前物理 AI、具身智能设备普遍存在的算法迭代快、数据搬运功耗高、算力调度冲突、硬件空间散热受限等行业难题,Imagination 创新性提出 GPU 融合可编程 AI 架构,打破传统 GPU、NPU 独立异构的设计模式,以统一可编程算力底座,适配新一代机器人、自动驾驶等端侧智能系统的长期迭代需求。

电源管理 GPU

特别推荐

更多

行业动态

更多

技术应用

更多

选型替代

更多

产品信息

更多

热门搜索

更多

欢迎登录

没有账号,

账号注册

注册成功!

3S后自动为你跳转登陆