【导读】单线程性能、核心密度、机架吞吐量这些指标本身没错,但回答不了客户真正的问题:在给定延迟、功耗和成本下,基础设施到底能完成多少有价值的智能体工作?英特尔最近的分析给出了一个务实视角:以739个Claude Code会话为样本的代码智能体工作流显示,单个请求下CPU处理时间占比不到1%,32个请求并发时升至15%——新增延迟大多来自调度排队,而非计算。更快的核心解决不了排队,而排队会让GPU跟着空转。英特尔由此提出用“每机架实际交付的智能体数量”替代理论吞吐量,衡量系统在功耗和成本约束下真正能稳定跑完多少工作流。
并发改变答案
在单智能体循环中,衡量性能是一件很简单的事情:每一步都能完成得更快,那么整个工作流的速度也会变快。然而,系统往往并非单智能体循环,而是同时运行很多的智能体,共同争抢CPU、内存、I/O以及加速器等资源。在这种高负载的情况下,系统的瓶颈也会随之改变。
近期的一项公开分析,以739个匿名Claude Code会话为样本,包含多轮推理、代码生成和工具调用的代码智能体工作流。该分析显示,单个请求下CPU 端的处理和等待时间占总延迟的不到1%,而当32个请求并发时,这一比例最高可提升到15%。新增的延迟大部分源于调度与排队,而非计算。
更快的核心可以提高任务的执行速度,但它无法避免排队的现象。
此类等待,同样会波及系统中最昂贵的组件——GPU。同样在这个分析中,针对代码执行智能体的研究预估,GPU的有效工作时间仅占整体实际运行时长的50%~60%。当智能体等待数据库、检索系统或沙箱返回结果时,GPU也会跟着陷入空转。在这里,阿姆达尔定律依然适用:
“最昂贵的加速器,其实是那些正在等待系统其他组件响应的加速器。”
衡量理论容量,不如衡量实际交付的智能体工作流
英特尔提出了一个更实用的衡量指标,即每机架实际交付的智能体数量,也就是说,在既定功耗和成本范围内,一个机架能够在规定的吞吐量、质量和延迟要求下,稳定完成的智能体工作流数量。
如何理解实际交付容量呢?
每机架实际交付的智能体数量=每机架理论智能体数×路由效率×资源平衡度×卸载效率
理论容量反映机架可用的计算、内存和带宽资源。路由效率反映任务的部署分配效果。资源平衡度体现因瓶颈和排队造成的损失。卸载效率反映将基础设施任务从通用核心移出后,系统所释放出的容量。随附的白皮书对这些因素及具体方法作了更详细的说明。
真正的容量上限,不是理论吞吐量图表的最高点,而是增加智能体数量后,延迟超过客户目标的那个点。图1给出了一个示例说明。
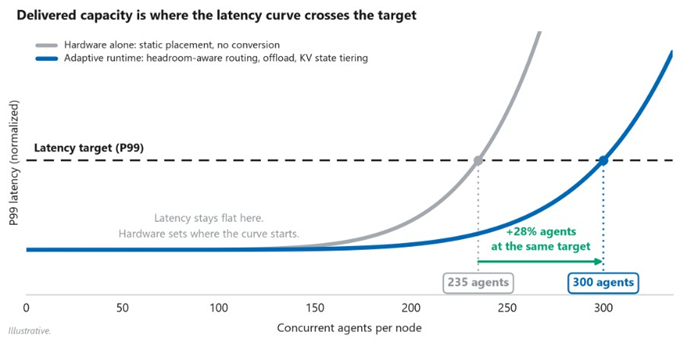
图1:容量指的是延迟曲线与目标阈值的交点。根据系统余量进行路由、任务卸载和状态分层,会将曲线拐点向右移动(示意图)。
英特尔打造完整的工作流解决方案
英特尔不是在“更快的核心”和“更多的核心”之间二选一,而是在构建一个系统,让两者都转化为实际的工作产出。
保持状态可用。带宽让智能体持续运行,容量则防止它重新启动。借助英特尔至强6平面内存模式(Flat Memory Mode),CXL附加内存与原生DDR5可以共享同一个地址空间。根据英特尔与SAP的联合评估,该方案的性能能够达到全DDR5配置的96%,与此同时,内存TCO降低约25%。这为企业以更低成本维持更多活跃会话,提供了一条可行之路。
把容量还给系统。英特尔®数据保护与压缩加速技术(英特尔® QAT)、数据流加速器(英特尔® DSA)和存内分析加速器(英特尔® IAA),可卸载原本会占用通用核心的基础设施任务。公开资料显示,使用英特尔IAA进行快照压缩,快照完成速度可提高约1.2倍。卸载不再只是功能列表上的选项,而是将容量还给客户。
按任务需求匹配算力资源。编排调度、工具执行、数据服务与状态迁移的算力需求各不相同。至强产品系列依托统一架构,既有性能核的高单线程性能,也有能效核的高密度吞吐,这让系统有能力为每一阶段的工作流,匹配最合适的执行配置。
避免加速器陷入闲置。当然,企业既需要CPU,也需要专为智能体优化的GPU,英特尔正在筹备的Crescent Island GPU,正是为满足这一需求而来。然而,如果GPU持续处在等待状态,那它终究就只是一块昂贵的硅片,白白消耗机架电力而已。这就是CPU在当下,依然事关重要的原因。至强承担了智能体系统总调度者的角色,维持会话运行、工具调用、数据流通等,持续为加速器供给任务。
更具价值的评测标准
所有智能体AI的性能声明,也包括英特尔自己所发布的在内,都应标明并发规模、延迟目标,以及理论性能与实际交付之间的损耗。一旦缺少这些,测试数据所代表的,也只是潜在上限,而无法反映实际的生产力。
英特尔将基于真实智能体轨迹,以明确的P99延迟目标为基准,公开单机柜智能体数量、路由效率、固定功能卸载所带来的性能增益、GPU挂载系统的主机侧效率,以及机柜功耗约束下的每瓦智能体数量等。
单线程性能重要,核心密度也重要。但最终胜出的系统,一定能让每个线程都有活干、每个会话都保持活跃、每个加速器都充分运转。
行业花了太多时间盘点机柜的硬件规格。现在,是时候衡量它的实际产出了。
结论
英特尔这套思路,是把智能体AI性能评测从“跑分逻辑”拉到“交付逻辑”。理论容量从来不是瓶颈的终点,延迟曲线与业务目标的交点才是。至强6平面内存模式让CXL附加内存与DDR5共享地址空间,以约25%内存TCO降幅换取96%性能;QAT、DSA、IAA把基础设施任务从通用核心卸下,把容量还给业务;性能核与能效核搭配让不同阶段匹配最合适算力;至强作为总调度者为GPU持续供给任务。

 新品速递