【导读】了解退化分量的绝对影响和相对影响有助于确定限制SuperFlash耐擦写次数的最关键因素,进而对单元工艺和/或工作条件做出相应的优化。故本文提出了一种简单快速的方法来分析SuperFlash分离栅极存储单元中循环擦写引起的退化分量。
SuperFlash®技术基于分离栅极概念,广泛用于独立和嵌入式NOR闪存产品。与其他竞争解决方案相比,SuperFlash的主要优势包括:因采用较厚的隧道电介质层而具有卓越的可靠性、不存在过擦除问题并且设计简洁。与其他基于浮置栅极(FG)的存储器类似,SuperFlash的耐烧写-擦除次数受烧写和擦除期间电介质层中电子俘获引起的工作窗口关闭的限制。在SuperFlash单元中,擦除和烧写期间会在隧道氧化层和FG氧化层这两个不同的物理位置发生电子转移。这两个区域中俘获的电子会使单元工作窗口在烧写-擦除周期后缩短。了解这两个退化分量的相对贡献对于优化单元的技术和工作条件极其重要。我们提出了一种简单快速的方法,能够分离出SuperFlash单元中循环擦写引起的退化分量。
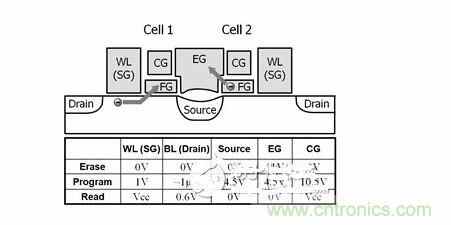
1 第3代SuperFlash存储单元的结构和典型工作条件。图中给出了两个共用源极和擦除栅极的单元。图中用箭头指示烧写(单元1)和擦除(单元2)期间的电子转移情况。WL为字线(选择栅极),CG为耦合栅极,EG为擦除栅极,FG为浮置栅极。
SuperFlash单元中循环擦写引起的退化分量
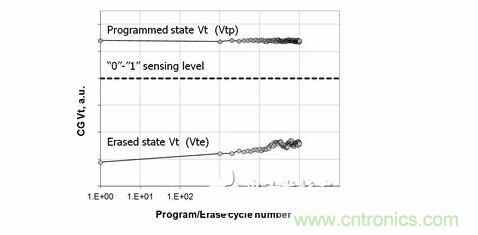
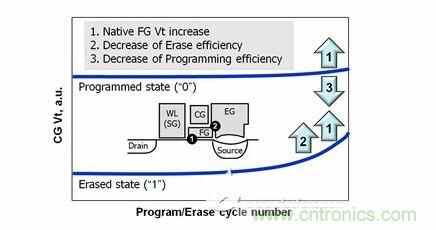
图1给出了第3代SuperFlash单元[3]的结构和典型工作条件。此单元使用源极侧的热电子注入进行烧写,使用针尖增强的多晶硅到多晶硅电子隧穿进行擦除。通常,SuperFlash单元的耐擦写次数受擦除侧工作窗口关闭的限制[4],表现为已擦除状态下单元阈值电压Vte的增大(图2)。本技术中未观察到与单元相关、循环擦写引起的烧写故障:单元在已烧写状态下的Vt(Vtp)保持相对不变,或随循环擦写次数而略微增大。图3给出了主要的循环擦写引发机制,它们负责确定单元“0”-“1”工作窗口的行为。
图2 已擦除状态下单元阈值电压(Vte)和已烧写状态下单元阈值电压(Vtp)的循环擦写过程示例
图3 循环擦写引发机制对单元工作窗口的影响
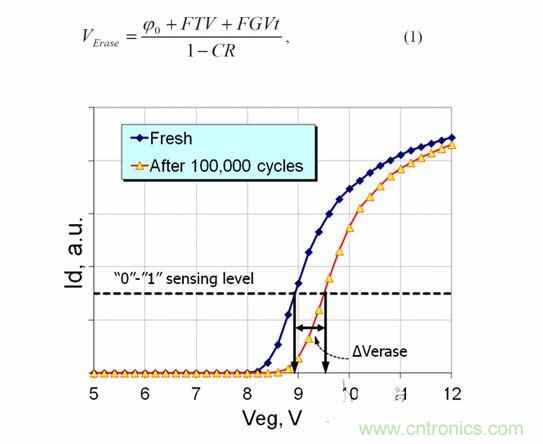
在烧写-擦除循环期间,一些电子被俘获到FG下面的氧化层(FG氧化层)和隧道氧化层中。图3的插图中分别用1和2标出了电子俘获区域的位置。擦除期间隧道氧化层(位置1)中俘获的电子会增加后续隧穿的位垒并降低隧穿效率,这将导致单元的Vte增大[5]。烧写期间FG氧化层(位置2)中俘获的电子对单元的工作窗口具有双重影响。首先,它会使FG“原生Vt”增大,进而使单元的Vte和Vtp都增大。其次,它会降低烧写效率,从而导致Vtp减小。因此,这两种循环擦写引起的电子俘获分量均会导致Vte退化(增大),而Vtp过程则受两个作用相反的机制影响。在擦除电压范围内,烧写-擦除循环导致擦除期间的EG电压(Verase)增大,这是达到特定读取电流值的必要条件,相关示例请参见图4。擦除期间,隧穿电流为常量,Verase等于
图4 循环擦写前和循环擦写后单元的读取电流与擦除电压的关系(累积擦除和固定擦除时间)示例
[page]
其中,FTV为EG-FG电压差,FGVt为原生FG阈值电压,φ0为读取条件下“超出”FG Vt的FG电势(达到特定读取电流的必要条件);CR为EG-FG电容耦合系数。从(1)可以看出,隧穿电压FTV或FGVt的增大对Verase具有类 似的作用。上述两个擦除退化分量的相对贡献取决于许多因素,包括单元的工作和循环擦写条件、单元的几何形状和工艺过程的参数等。了解主要退化机制对于优化 单元工艺和工作条件非常重要,目的是增加SuperFlash的耐擦写次数。
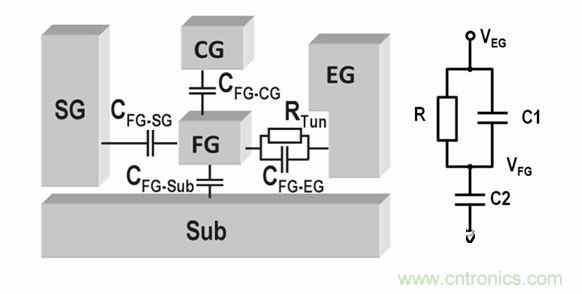
图5 单元的电容-电阻图及其等效电路
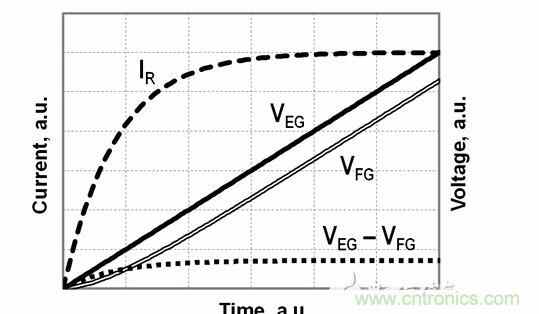
图6 FG电压和EG电压、EG-FG电压差以及流经电阻R的电流的时序图,对应于公式(2)-(4)
方法说明
要分离FG氧化层和隧道氧化层退化对观察到的擦除速度下降情况的影响,需要一个
工具来探测循环擦写引起的原生FG Vt的变化,而不是直接测量浮置栅极。如上所示,Vtp或Vte过程中包含多个分量,无法用于得出关于FG Vt变化的可靠结论。早期提出了一种利用经UV照射后的单元的中性状态来监视FG沟道退化状态的方法[6],但这种方法并非始终适用于采用致密金属布局的现代化大规模FG单元;UV擦除还需要特殊的晶圆生产工艺,并可能导致一些电子逃逸,从而影响测量结果。我们提出一种新的快速、非破坏性的电气方法,这种方法基于隧穿电流稳定性在向擦除栅极施加线性斜坡电压时的作用[7,8]。
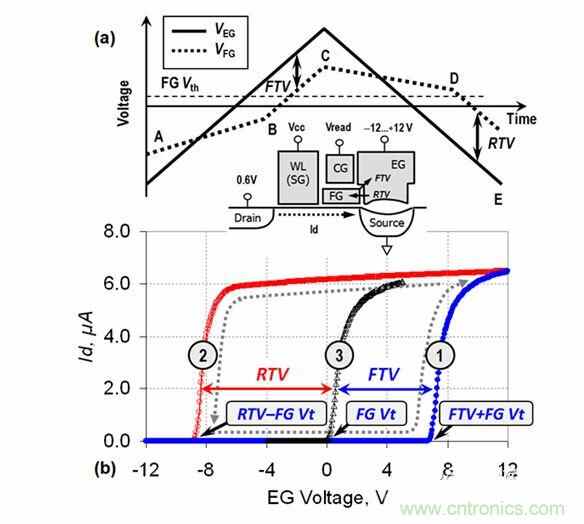
图7 (a) VEG线性斜坡期间的EG电压和FG电压图;(b) VEG正向变化(曲线1)和反向变化(曲线2)期间测量的单元电流。曲线3显示了在直接接触FG的单元上测量的Id-VFG参考特性(来自[3])。在A-B和C-D区域中,EG-FG电压差小于对应的隧穿电压,FG电势由EG-FG静电耦合控制。
[page]
图5显示了SuperFlash单元的简化R-C图及其等效电路。其中,C1为EG-FG电容,C2为总FG电容与CFG-EG的差值,R为有效隧穿电阻。VEG线性斜坡(VEG=αt)和欧姆电阻R组成的等效电路中的瞬变具有简单的闭环解决方案:
隧穿电流IR和EG-FG电压差均达到其稳定值(分别为αC2和αRC2),时间常量为R(C1+C2),请参见图6。对于隧穿I-V特性曲线为任意形状的实际FG单元,稳定后的隧穿电流值相同(αC2),稳定后的VEG-VFG之差对应于隧穿I-V曲线中的某个点。这种情况下的时间常量由隧穿I-V特性的差分电阻定义。
图7(a)显示了使用非欧姆隧道电阻时施加的EG电压和FG电势的时序图。为监视VEG变化期间FG电势的变化情况,WL沟道需保持开路(3V),并向漏极施加一个较小的正向偏置电压(见图7(a)中的插图)。起点为单元的已编程状态(A点,FG负电势)
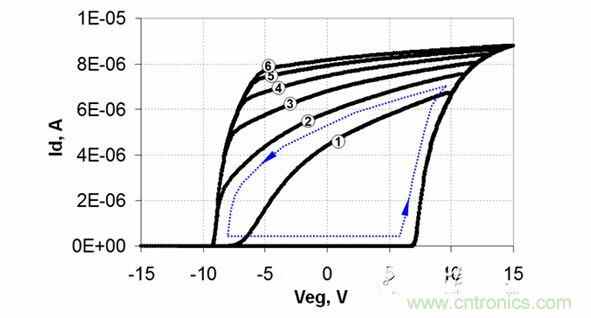
图8 不同VEG摆幅下测量的FTV-RTV迟滞回路。曲线1(±10V),曲线2(±11V)。曲线6(±15V)。箭头指示EG电压斜升的方向。曲线1说明了相对较浅擦除状态作为起点时的情况:隧穿开始前,FG沟道由EG-FG电容耦合关断。
在A-B间隔内,FG电势因EG-FG电容耦合而增加,即,它以低于EG电压的速率增大;这样便产生了EG-FG电压差。一旦此压降增大至足以启动FG至EG(B点)的电子隧穿,EG-FG电压差和隧穿电流都将保持稳定。VEG反向变化期间也会出现类似效果。VEG线性斜坡期间,当隧穿电流保持稳定时,EG-FG电压差也会处于稳定状态,这样,FG电势便会直接跟随施加的EG电压并带有一些偏移量。当VEG为正时,FG电势等于正向隧穿电压(FTV);当VEG为负时,FG电势等于反向隧穿电压(RTV)(图7(b))。在稳定隧穿状态下,由于EG电压的任何增量都会直接传递给FG电势的变化,因此测量的Id-VEG曲线的形状与Id-VFG特性曲线的形状相同,此特性曲线可在直接接触浮置栅极的单元上测量(图7(b)中的曲线3)。
[page]
我们最初使用上述方法来研究SuperFlash 单元中正向和反向EG-FG隧穿的不对称性[3]。FTV-RTV不对称性(FTV 《 RTV)表示擦除期间在FG尖端发生电子隧穿。反向隧穿很可能发生在不同位置,因为FG尖端附近EG处的电场弱于FG-EG侧壁处的电场。由于隧道氧化层中的各区域(正向隧穿和反向隧穿期间会在其中发生电子转移)不同,因此常规烧写-擦除循环后的FTV往往会因隧道氧化层中发生的电子俘获而增大,而RTV则保持相对不变。如果VEG的范围宽到足以确保在VEG三角形范围的极点处进行单元深度擦除和烧写,则Id-VEG迟滞回路正向侧和反向侧的X轴位置对FG上的初始电荷量不敏感(图8),并且仅由FTV/RTV和FG Vt值定义。当因FG氧化层中发生烧写引起的电子俘获而使FG Vt增大时,回路两侧均会右移相同电压。回路右侧(FTV)也会因隧道氧化层中的电子俘获而移向更高的电压。
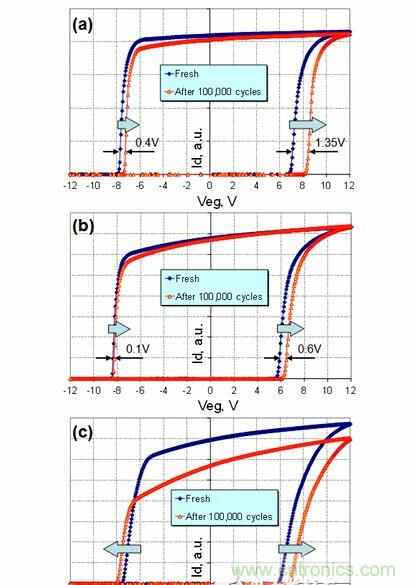
图9 循环擦写后FTV-RTV迟滞回路偏移示例:(a) 未优化的编程条件,FG沟道显著退化;(b) 优化了工艺和工作条件,FG沟道和隧道氧化层略微退化;(c) 以VEG=±12V进行循环擦写,无沟道退化,因此,假设RTV不随循环擦写变化,循环擦写引起的反向特性正移(图7(b)中的曲线2)表示第一个退化分量(FG氧化层Vt增大),而正向侧的偏移(图7(b)中的曲线1)表示FG氧化层和隧道氧化层退化的联合作用。
实验数据和讨论
前几代SuperFlash技术依靠源极-FG电容耦合来提供必要的高FG电势,从而实现高烧写效率[1]。如果烧写期间的SL电压较高(8V-10V),则热电子会引起FG氧化层发生显著退化。在第3代SuperFlash单元中,由于存在额外的耦合栅极(CG),因此可将编程期间的SL电压降至4V-5V,从而明显减少编程引起的FG氧化层退化。通常,我们在隧道氧化层中观察到的电子俘获是循环擦写引起的擦除退化的主要因素,FG氧化层退化只起到很小的作用。如果FG氧化层发生明显退化,则可能表示FG氧化层的质量欠佳或未采用优化的烧写条件。图9给出了循环擦写前和循环擦写后FTV-RTV迟滞回路在不同退化分量比率下的示例。图9(a)显示了采用未优化编程条件(导致FG沟道发生显著退化)时的效果,这一因素占总擦除性能退化的30%。图9(b)给出了FG沟道略微退化的示例,FG Vt的变化约为0.1V。图9(c)说明了使用EG-FG正向和反向隧穿时单元的循环擦写情况。在这种情况下,FG氧化层不退化,迟滞回路偏移的原因是循环擦写引起FTV和RTV值增加。
总结
我们提出了一种简单快速的方法来分析SuperFlash分离栅极存储单元中循环擦写引起的退化分量。本方法基于隧穿电流稳定性在向擦除栅极施加线性斜坡电压时的作用。通过这种方法,可以快速分离FG沟道和隧道氧化层退化对单元擦除性能总体退化的影响。了解退化分量的绝对影响和相对影响有助于确定限制SuperFlash耐擦写次数的最关键因素,进而对单元工艺和/或工作条件做出相应的优化。

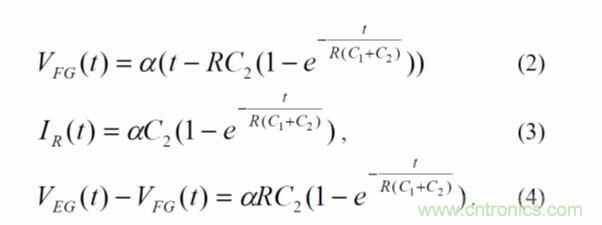
 新品速递