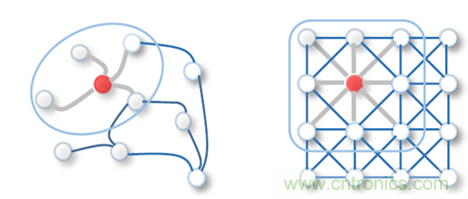
但是, GNN中的Graph数据卷积计算与传统CNN中的2D卷积计算是不同的。以图2为例,针对红色目标节点的卷积计算,其过程如下:
l Graph卷积:以邻居函数采样周边节点特征并计算均值,其邻居节点数量不确定且无序(非欧氏数据)。
l 2D卷积:以卷积核采样周边节点特征并计算加权平均值,其邻居节点数量确定且有序(欧氏数据)。
图 2:Graph卷积和2D卷积(来源:https://arxiv.org/abs/1901.00596)
3. GraphSAGE算法简介
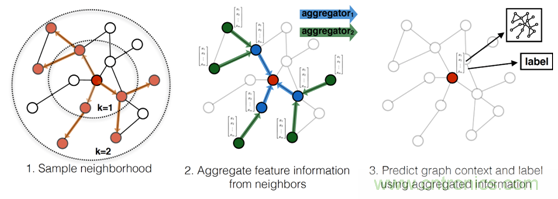
学术界已对GNN算法进行了非常多的研究讨论,并提出了数目可观的创新实现方式。其中,斯坦福大学在2017年提出的GraphSAGE是一种用于预测大型图中动态新增未知节点类型的归纳式表征学习算法,特别针对节点数量巨大、且节点特征丰富的图做了优化。如下图所示,GraphSAGE计算过程可分为三个主要步骤:
图3:GraphSAGE算法的视觉表述(来源:http://snap.stanford.edu/graphsage)
l 邻节点采样:用于降低复杂度,一般采样2层,每一层采样若干节点
l 聚合:用于生成目标节点的embedding,即graph的低维向量表征
l 预测:将embedding作为全连接层的输入,预测目标节点d的标签
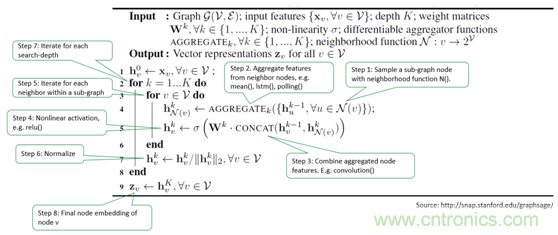
为了在FPGA中实现GraphSAGE算法加速,我们需要知悉其数学模型,以便将算法映射到不同的逻辑模块中。下图所示的代码阐述了本算法的数学过程。
图 4:GraphSAGE算法的数学模型(来源:http://snap.stanford.edu/graphsage)
对于每一个待处理的目标节点xv,GraphSAGE执行下列操作:
1)通过邻居采样函数N(v),采样子图(subgraph)中的节点
2)聚合被采样的邻节点特征,聚合函数可以为mean()、lstm()或者polling()等
3)将聚合结果与上一次迭代的输出表征合并,并以Wk做卷积
4)卷积结果做非线性处理
5)迭代若干次以结束当前第k层所有邻节点的处理
6)将第k层迭代结果做归一化处理
7)迭代若干次以结束所有K层采样深度的处理
8)最终迭代结果zv即为输入节点xv的嵌入(embedding)
4.GNN加速器设计挑战
GNN的算法中涉及到大量的矩阵计算和内存访问操作,在传统的x86架构的服务器上运行此算法是非常低效的,表现在速度慢,能耗高等方面。
新型GPU的应用,可以为GNN的运算速度和能效比带来显著收益。然而GPU内存扩展性的短板,使其无法胜任海量节点Graph的处理;GPU的指令执行方式,也造成了计算延迟过大并且不可确定,无法胜任需要实时计算Graph的场景。
如上所述种种设计挑战的存在,使得业界急需一种可以支持高度并发实时计算、巨大内存容量和带宽、以及在数据中心范围可扩展的GNN加速解决方案。
5.GNN加速器的FPGA设计方案
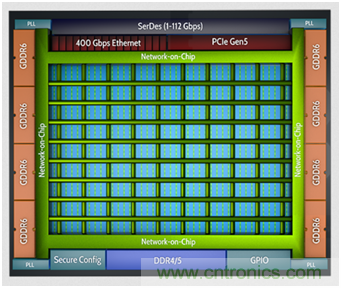
Achronix公司推出的Speedster7t系列高性能FPGA,专门针对数据中心和机器学习工作负载进行了优化,消除了CPU、GPU以及传统 FPGA 存在的若干性能瓶颈。Speedster7t FPGA 基于台积电的 7nm FinFET工艺,其架构采用革命性的新型 2D 片上网络(NoC),独创的机器学习处理器矩阵(MLP),并利用高带宽 GDDR6 控制器、400G 以太网和 PCI Express Gen5 接口,在保障ASIC 级别性能的同时,为用户提供了灵活的硬件可编程能力。下图展示了Speedster7t1500高性能FPGA的架构。
图5: AchronixSpeedster7t1500高性能FPGA架构(来源:http://www.achronix.com)
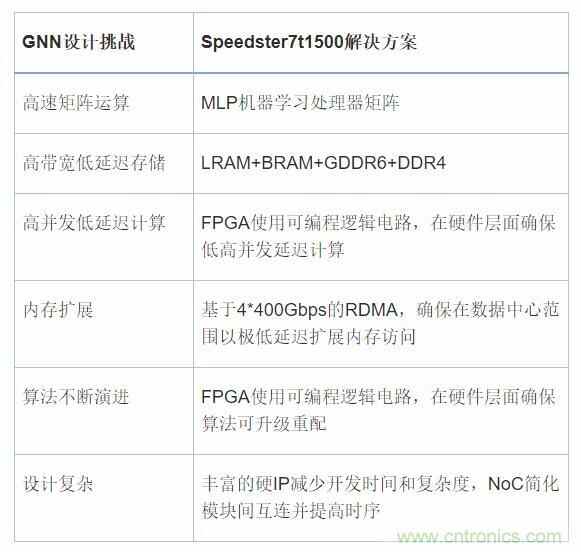
如上所述种种特性,使得AchronixSpeedster7t1500 FPGA器件为GNN加速器设计中所面临的各种挑战,提供了完美的解决方案。
表1:GNN设计挑战与Achronix的Speedster7t1500 FPGA解决方案
5.1GNN加速器顶层架构
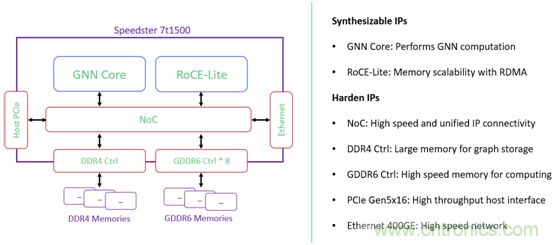
本GNN加速器针对GraphSAGE进行设计,但其架构具有一定的通用性,可以适用于其他类似的GNN算法加速,其顶层架构如下图所示。
图6: GNN加速器顶层架构(来源:Achronix原创)
图中GNNCore为算法实现的核心部分,其设计细节将在下文展开谈论;RoCE-Lite为RDMA协议的轻量级版本,用于通过高速以太网进行远程内存访问,以支持海量节点的Graph计算,其设计细节将在本公众号的后续文章中讨论;400GE以太网控制器用来承载RoCE-Lite协议;GDDR6用于存放GNN处理过程中所需的高速访问数据;DDR4作为备用高容量内存,可以用于存储相对访问频度较低的数据,比如待预处理的Graph;PCIeGen5x16提供高速主机接口,用于与服务器软件交互数据;上述所有模块,皆通过NoC片上网络来实现高速互联。
5.2GNNCore微架构
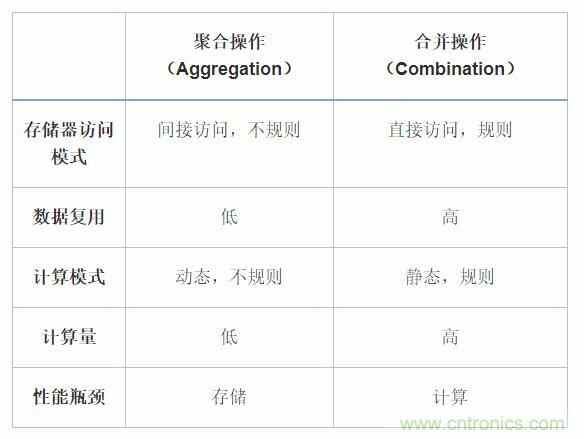
在开始讨论GNNCore微架构之前,我们先回顾一下本文第3节中的GraphSAGE算法,其内层循环的聚合以及合并(包含卷积)等两个操作占据了算法的绝大部分计算和存储器访问。通过研究,我们得到这两个步骤的特征如下:
表2:GNN算法中聚合与合并操作对比(来源:https://arxiv.org/abs/1908.10834)
可以看出,聚合操作与合并操作,其对计算和存储器访问的需求完全不同。聚合操作中涉及到对邻节点的采样,然而Graph属于非欧氏数据类型,其大小维度不确定且无序,矩阵稀疏,节点位置随机,所以存储器访问不规则并难以复用数据;在合并操作中,其输入数据为聚合结果(节点的低维表征)以及权重矩阵,其大小维度固定,存储位置规则线性,对存储器访问不存在挑战,但是矩阵的计算量非常大。
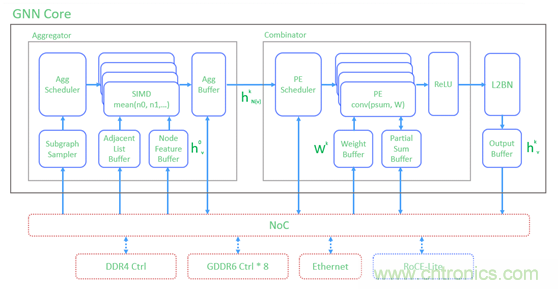
基于以上分析,我们决定在GNNCore加速器设计中用两种不同的硬件结构来处理聚合操作与合并操作,功能框图如下图所示:
图7: GNNCore功能框图(来源:Achronix原创)
聚合器(Aggregator):通过SIMD(单指令多数据处理器)阵列来对Graph进行邻居节点采样并进行聚合操作。其中的“单指令”可以预定义为mean()均值计算,或者其他适用的聚合函数;“多数据”则表示单次mean()均值计算中需要多个邻居节点的特征数据作为输入,而这些数据来自于子图采样器(SubgraphSampler);SIMD阵列通过调度器Agg Scheduler做负载均衡;子图采样器通过NoC从GDDR6或DDR4读回的邻接矩阵和节点特征数据h0v,分别缓存在AdjacentListBuffer和NodeFeature Buffer之中;聚合的结果hkN(v)存储在AggBuffer之中。
合并器(Combinator):通过脉动矩阵PE来执行聚合结果的卷积操作;卷积核为Wk权重矩阵;卷积结果通过ReLU激活函数做非线性处理,同时也存储在PartialSumBuffer中以方便下一轮迭代。
合并的结果通过L2BN归一化处理之后,即为最终的节点表征hkv。
在比较典型的节点分类预测应用中,该节点表征hkv可以通过一个全连接层(FC),以得到该节点的分类标签。此过程属于传统的机器学习处理方法之一,没有在GraphSAGE论文中体现,此设计中也没有包含这个功能。
6.结论
本文深入讨论了GraphSAGEGNN算法的数学原理,并从多个维度分析了GNN加速器设计中的技术挑战。作者通过分解问题并在架构层面逐一解决的方法,综合运用AchronixSpeedster7t1500FPGA所提供的竞争优势,创造了一个性能极佳且高度可扩展的GNN加速解决方案。

 业界新闻



