 业界新闻
加码端侧AI算力!广和通战略投资NPU技术企业烨知心科技
近日,广和通正式完成对端侧AI算力企业烨知心科技的战略投资。烨知心深耕NPU架构与端侧软硬件协同技术,背靠多家头部投资机构与产业资本,具备扎实的底层AI算力研发实力。此次战略合作,让广和通进一步补齐端侧算力底层能力,强化与上游核心算力厂商的产业联动,完善从算力底座、智能终端到场景应用的全链条AI生态布局,助力各类智能终端实现高效、低功耗的端侧AI规模化落地。

技术应用
发布时间:2026-01-09 00:00:00 来源:转载 责任编辑:lily
【导读】端侧AI推理的核心诉求在于高效算力、精准感知与场景适配,瑞芯微RV1126B处理器凭借升级的3TOPS NPU算力给出了优质解决方案。本文聚焦该处理器的核心优势,先明确其NPU在算力提升、模型兼容上的突破,再通过飞凌OK1126B-S开发板的实测数据佐证性能;随后深入解析AI-ISP技术如何打破传统方案瓶颈,为AI推理奠定优质图像基础,全方位呈现RV1126B为端侧AI领域带来的进阶体验。
3TOPS NPU赋能端侧AI推理
瑞芯微RV1126B处理器内置独立的NPU,提供高达3TOPS@INT8的AI算力,较前代RV1126提升了50%,支持INT8/INT16混合精度运算,支持W4A16/W8A16混合精度量化与Transformer模型优化,可流畅运行2B参数级大语言模型和多模态模型。
这意味着,RV1126B可高效运行人脸检测、安全帽识别、烟火告警、区域入侵等多种典型的边缘AI目标识别模型,实现本地实时决策,无需依赖云端。
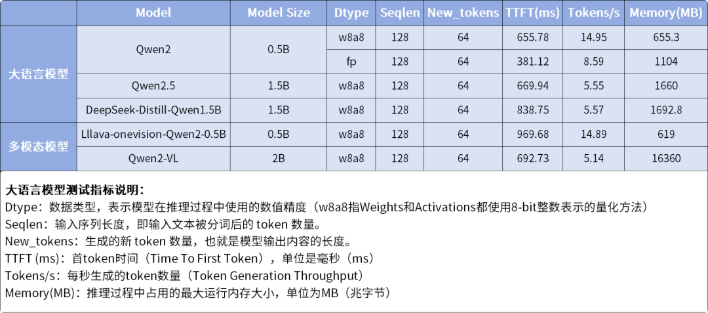
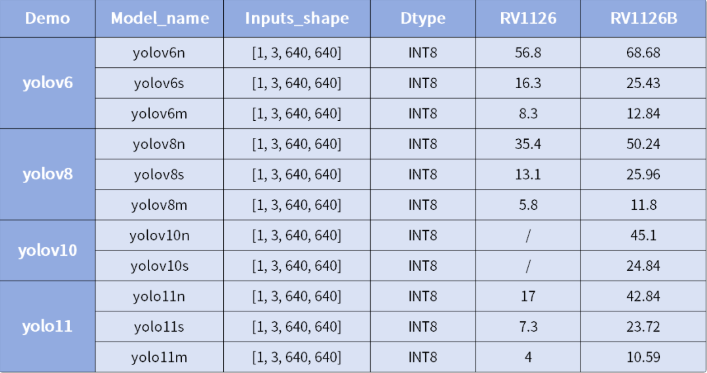
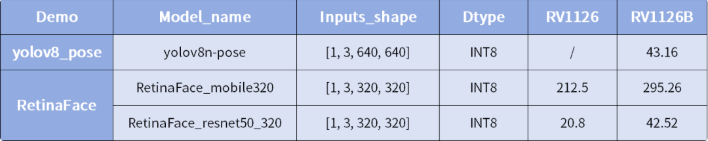
这里我们用飞凌嵌入式OK1126B-S开发板来运行不同的模型,通过实际的运行数据,展示RV1126B处理器的NPU性能表现。
大语言模型和多模态模型
目标检测
图像分割
人体&人脸关键点识别
通过以上实测数据不难看出,搭载RV1126B处理器的飞凌嵌入式OK1126B-S开发板在多种模型的运行方面都有着卓越的表现,尤其是对比前代RV1126,NPU性能提升十分明显。
AI-ISP更高效的视觉智慧引擎
在边缘AI领域,获取高质量的图像输入是提升智能感知能力的基石。传统方案的瓶颈在于,ISP输出的图像已是经过压缩和损失的数字信号,NPU在此基础上的分析犹如“雾里看花”。而RV1126B的专用AI-ISP,将先进的AI算法直接注入ISP的原始数据处理链路中,实现了 “在提升画质的同时,为AI理解预先优化” 的双重目标。
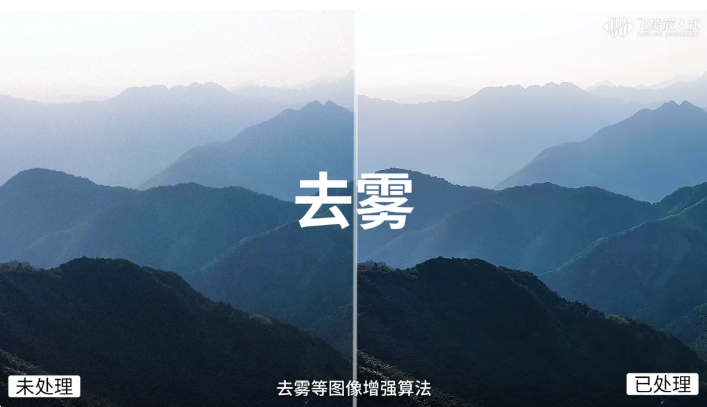
AI模型实时处理3DNR(三维数字降噪)、HDR合成、畸变校正、去雾处理等关键环节,使得最终输出的图像,结合AI Remosaic技术实现 "日夜双模自适应"。不仅是人眼观感更佳的图像,更是“AI友好型”的图像,为后端NPU的精准、高效推理奠定了最优基础。
值得注意的是,RV1126B在运行AI-ISP时无需占用NPU资源,较传统的ISP+NPU共同处理的方案更加节省带宽与功耗。
多场景适用为智能化升级赋能
瑞芯微RV1126B凭借均衡的性能精准适配多元端侧AI场景——智慧工地场景可实现安全帽/反光衣佩戴检测、高空抛物识别、违规动火告警等安全监管功能;智能仓储场景能高效完成货物条码识别、货架盘点、人员轨迹追踪与越界预警;工业视觉场景能高效完成光伏/锂电池缺陷识别;车载场景适配DMS驾驶员监测;轻量级机器人可依托其实现动态避障与路径规划等等。
要将芯片的能力转化为稳定可靠的产品,离不开一套稳定可靠的硬件载体与服务体系——飞凌嵌入式基于RV1126B系列处理器设计开发的FET1126B-S/FET1126BJ-S核心板,正是为此而生。
飞凌嵌入式FET1126BJ-S核心板(工业级)支持-40℃~+85℃环境温度下工作,具备出色的可靠性和环境适应能力;同时,FET1126B-S核心板(宽温级)相较同类产品更具优势,商业级配置即可满足-20℃~+85℃工作环境需求。它搭载高带宽LPDDR4内存,相较于DDR4商业级0℃~+70℃的温宽限制,LPDDR4商业级芯片即可覆盖-20℃~+85℃,实现低成本与宽温性能的兼顾。
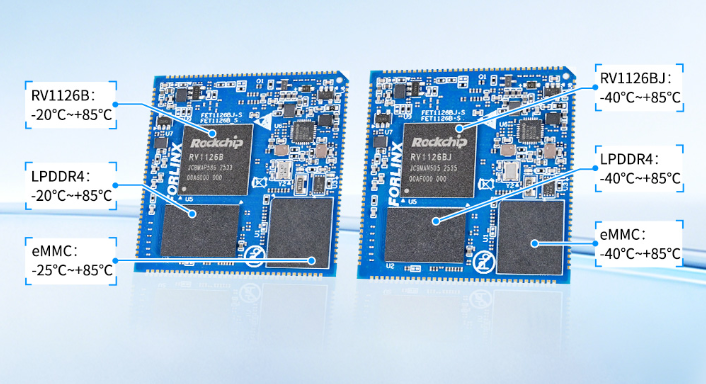
此外,飞凌嵌入式还提供了从硬件设计到软件部署的丰富资料与高效全面的技术支持服务,结合稳定供货体系,大幅缩短项目开发周期,稳定可靠地助力各行业客户的方案快速落地和批量交付。
总结
瑞芯微RV1126B处理器以50%提升的NPU算力、创新的AI-ISP技术以及广泛的场景适配能力,构建了高效、可靠的端侧AI解决方案。从多种模型的流畅运行到图像处理的双重优化,再到多元行业的精准适配,其均衡的性能表现精准契合端侧AI的核心需求。而飞凌嵌入式FET1126B-S/FET1126BJ-S核心板的加持,更以宽温适配、高带宽内存及完善的技术服务,为芯片能力的落地提供了坚实保障。未来,RV1126B必将成为各行业智能化升级的得力助手。
为您推荐
业界新闻
近日,广和通正式完成对端侧AI算力企业烨知心科技的战略投资。烨知心深耕NPU架构与端侧软硬件协同技术,背靠多家头部投资机构与产业资本,具备扎实的底层AI算力研发实力。此次战略合作,让广和通进一步补齐端侧算力底层能力,强化与上游核心算力厂商的产业联动,完善从算力底座、智能终端到场景应用的全链条AI生态布局,助力各类智能终端实现高效、低功耗的端侧AI规模化落地。
 选型指南
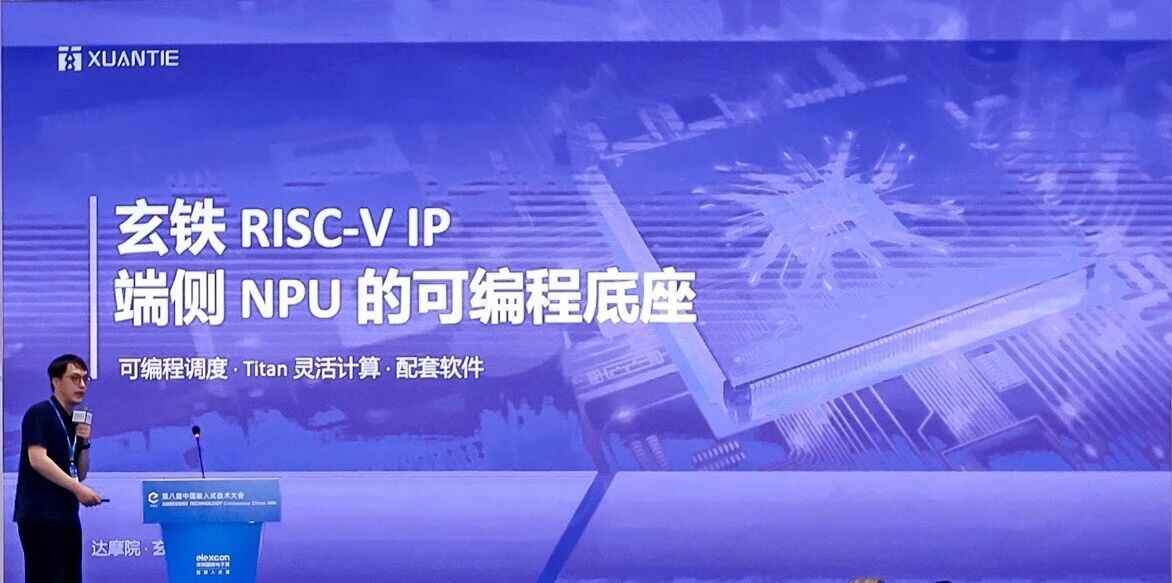
9月9日,阿里巴巴达摩院玄铁正式推出全新端侧AI解决方案,针对当前端侧AI场景多元、算法迭代快、NPU研发门槛高的行业痛点,打造由AI定制调度核、Titan高性能向量引擎、完整算子库与编译工具链组成的一体化可编程底座。该方案适配穿戴设备、智能家居、智能座舱、具身智能、AI PC等全品类端侧场景,能够帮助NPU厂商简化研发流程、缩短落地周期,聚焦核心差异化技术研发,加速端侧AI规模化商用落地。
 行业活动
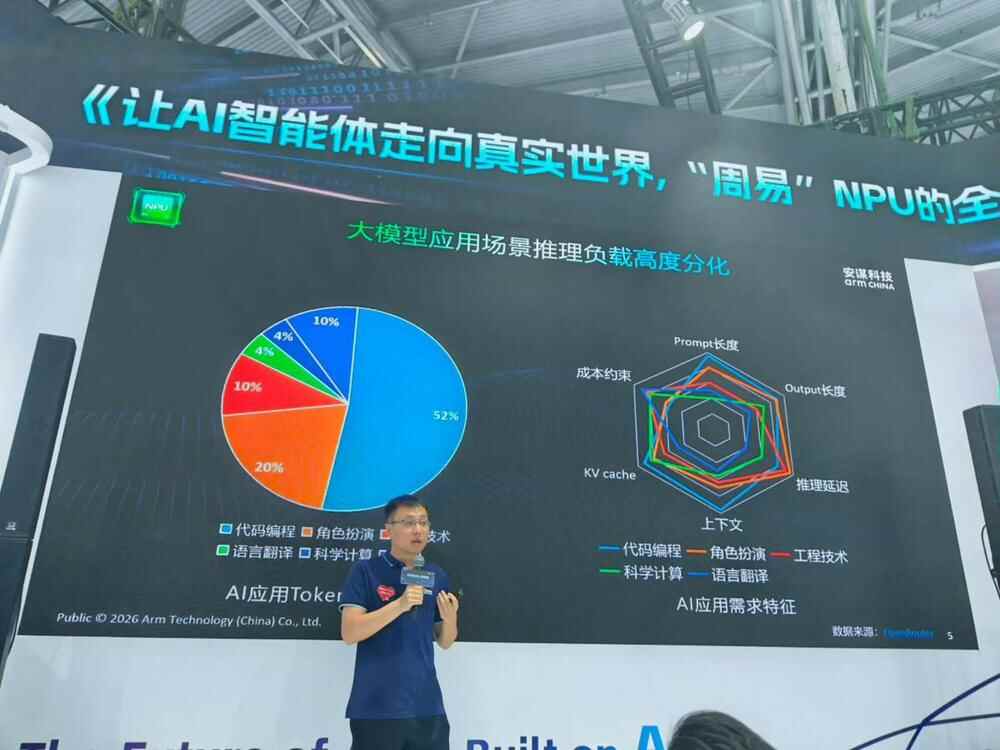
OpenClaw从爆火至今,人们愈加发现Agentic AI(智能体AI)才是AI发展的未来。随着Agentic AI革命渐深,算力与性能突破成为最大的问题。对Agentic AI来说,算力无疑是最重要的。去年11月,安谋科技发布了全新的NPU IP——“周易”X3,作为为端侧大模型量身定制的“性能猛兽”,其采用DSP+DSA异构架构,单Cluster算力达到8~80 TFLOPS。
 技术应用
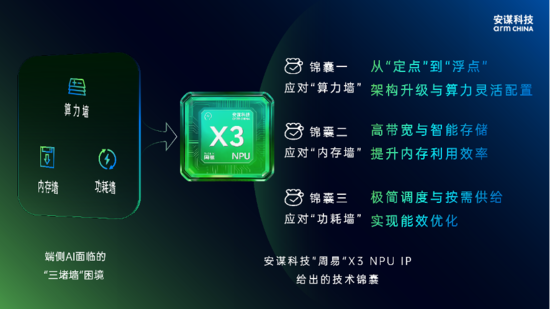
“算力墙”“内存墙”“功耗墙”已成为制约智能终端实现更复杂AI任务与更高计算效率的核心问题。神经网络处理器(NPU)作为支撑AI计算的核心硬件单元,是突破上述技术困局的关键支撑。安谋科技(Arm China)推出的“周易”X3 NPU IP,通过前瞻性的架构创新、深度的软硬件协同优化及开放的生态构建,为破解端侧AI三大技术壁垒提供了系统性的技术支撑方案。该方案从算力供给的灵活适配、内存利用效率的极致提升,到能效平衡的精准调控,以全方位的技术突破,为端侧AI的规模化落地提供了强劲动能。
 业界新闻
随着生成式人工智能(AI)与大模型全面融入移动终端,“AI手机”已从技术概念步入价值深水区。衡量旗舰竞争力的核心,正从单纯的硬件参数转向能否提供高效、个性化且安全可靠的端侧智能体验。联发科最新旗舰平台天玑9500,凭借其开创性的“双NPU”架构与强大的生态协同能力,正携手OPPO、vivo等头部厂商,将端侧AI转化为用户可切实感知的革新性功能,共同推动行业迈入“体验重构”的新阶段。