技术应用

如何使用PCIe交换网结构在多主机系统中优化资源部署

发布时间:2020-10-27 00:00:00 责任编辑:lina

【导读】 越来越多的数据中心和其他高性能计算环境开始使用GPU,因为GPU能够快速处理深度学习和机器学习应用中生成的大量数据。不过,就像许多可提高应用性能的新型数据中心创新一样,这项创新也暴露出新的系统瓶颈。
  
越来越多的数据中心和其他高性能计算环境开始使用GPU,因为GPU能够快速处理深度学习和机器学习应用中生成的大量数据。不过,就像许多可提高应用性能的新型数据中心创新一样,这项创新也暴露出新的系统瓶颈。在这些应用中,用于提高系统性能的新兴架构涉及通过一个PCIe®结构在多个主机之间共享系统资源。
 
PCIe标准(特别是其基于树的传统层级)会限制资源共享的实现方式(和实现程度)。不过,可以实现一种低延时的高速结构方法,这种方法允许在多个主机之间共享大量GPU和NVMe SSD,同时仍支持标准系统驱动程序。
 
PCIe结构方法采用动态分区和多主机单根I/O虚拟化(SR-IOV)共享。各PCIe结构之间可直接路由点对点传输。这样便可为点对点传输提供最佳路由,减少根端口拥塞,并且更有效地平衡CPU资源的负载。
 
传统上,GPU传输必须访问CPU的系统存储器,这会导致端点之间发生存储器共享争用。  当GPU使用其共享的存储器映射资源而不是CPU存储器时,它可以在本地提取数据,无需先通过CPU传递数据。这消除了跳线和链路以及由此产生的延时,从而使GPU能够更高效地处理数据。
 
PCIe的固有限制
 
PCIe主层级是一个树形结构,其中的每个域都有一个根联合体,从该点可扩展到“叶子”,这些“叶子”通过交换网和桥接器到达端点。链路的严格层级和方向性给多主机、多交换网系统带来了成本高昂的设计要求。
 
 
如何使用PCIe交换网结构在多主机系统中优化资源部署
图1——多主机拓扑
 
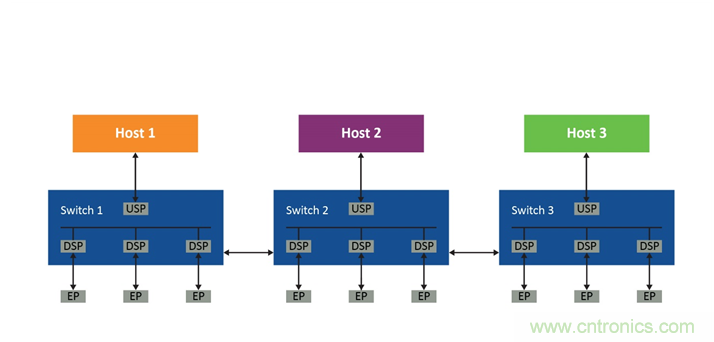
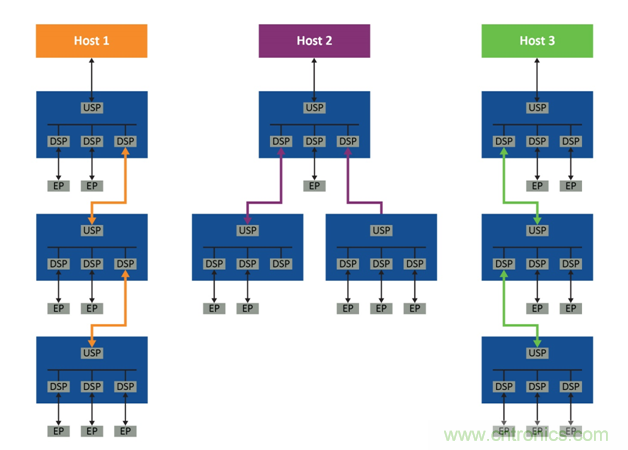
以图1所示的系统为例。要符合PCIe的层级,主机1必须在交换网1中有一个专用的下行端口,该端口连接到交换网2中的专用上行端口。它还需要在交换网2中有一个专用的下行端口,该端口连接到交换网3中的专用上行端口,依此类推。主机2和主机3也有类似的要求,如图2所示。
 
如何使用PCIe交换网结构在多主机系统中优化资源部署
图2——每个主机的层级要求
 
即使是基于PCIe树形结构的最基本系统,也需要各交换网之间有三个链路专用于每个主机的PCIe拓扑。而且,由于主机之间无法共享这些链路,因此系统会很快变得极为低效。
 
此外,符合PCIe的典型层级只有一个根端口,而且尽管“多根I/O虚拟化和共享”规范中支持多个根,但它会使设计更复杂,并且当前不受主流CPU支持。结果会造成未使用的PCIe设备(即端点)滞留在其分配到的主机中。不难想象,这在采用多个GPU、存储设备及其控制器以及交换网的大型系统中会变得多么低效。
 
例如,如果第一个主机(主机1)已经消耗了所有计算资源,而主机2和3未充分利用资源,则显然希望主机1访问这些资源。但主机1无法这样做,因为这些资源在它的层级域之外,因此会发生滞留。非透明桥接(NTB)是这种问题的一个潜在解决方案,但由于每种类型的共享PCIe设备都需要非标准驱动程序和软件,因此这同样会使系统变得复杂。更好的方法是使用PCIe结构,这种结构允许标准PCIe拓扑容纳多个可访问每个端点的主机。
 
实施方法
 
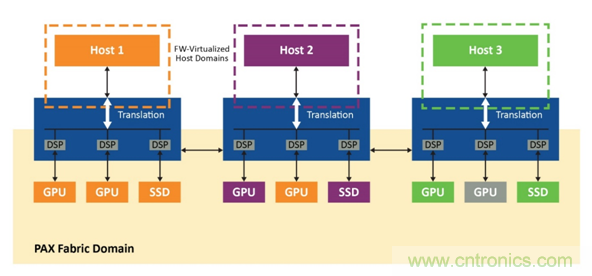
系统使用一个PCIe结构交换网(本例中为Microchip Switchtec® PAX系列的成员)在两个独立但可透明互操作的域中实现:即包含所有端点和结构链路的结构域以及每个主机专用的主机域(图3)。主机通过在嵌入式CPU上运行的PAX交换网固件保留在单独的虚拟域中,因此,交换网将始终显示为具有直连端点的标准单层PCIe设备,而与这些端点出现在结构中的位置无关。
 
如何使用PCIe交换网结构在多主机系统中优化资源部署
图3——每个结构的独立域
 
来自主机域的事务会在结构域中转换为ID和地址,反之,结构域中通信的非分层路由也是如此。这样,系统中的所有主机便可共享连接交换网和端点的结构链路。交换网固件会拦截来自主机的所有配置平面通信(包括PCIe枚举过程),并使用数量可配置的下行端口虚拟化一个符合PCIe规范的简单交换网。
 
当所有控制平面通信都路由到交换网固件进行处理时,数据平面通信直接路由到端点。其他主机域中未使用的GPU不再滞留,因为它们可以根据每个主机的需求动态分配。结构内支持点对点通信,这使其能够适应机器学习应用。当以符合PCIe规范的方式向每个主机提供功能时,可以使用标准驱动程序。
 
操作方法
 
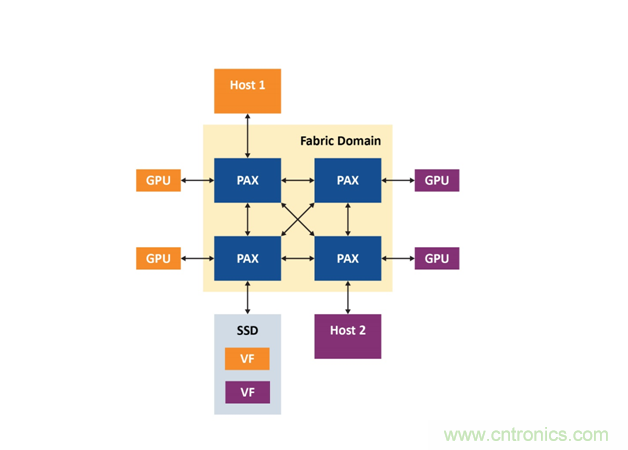
为了解这种方法的工作原理,我们以图4中的系统为例,该系统由两个主机(主机1采用Windows®系统,主机2采用Linux®系统)、四个PAX PCIe结构交换网、四个Nvidia M40 GPGPU和一个支持SR-IOV的Samsung NVMe SSD组成。在本实验中,主机运行代表实际机器学习工作负载的通信,包括Nvidia的CUDA点对点通信基准测试实用程序和训练cifar10图像分类的TensorFlow模型。嵌入式交换网固件处理交换网的低级配置和管理,系统由Microchip的ChipLink调试和诊断实用程序管理。     
 
如何使用PCIe交换网结构在多主机系统中优化资源部署
图4:双主机PCIe结构引擎
 
四个GPU最初分配给主机1,PAX结构管理器显示在结构中发现的所有设备,其中GPU绑定到Windows主机。但是,主机上的结构不再复杂,所有GPU就像直接连接到虚拟交换网一样。随后,结构管理器将绑定所有设备,Windows设备管理器将显示GPU。主机将交换网视为下行端口数量可配置的简单物理PCIe交换网。
 
一旦CUDA发现了四个GPU,点对点带宽测试就会显示单向传输速率为12.8 GBps,双向传输速率为24.9 GBps。这些传输直接跨过PCIe结构,而无需通过主机。如果运行用于训练Cifar10图像分类算法的TensorFlow模型并使工作负载分布在全部四个GPU上,则可以将两个GPU释放回结构池中,将它们与主机解除绑定。这样可以释放其余两个GPU来执行其他工作负载。与Windows主机一样,Linux主机也将交换网视为简单的PCIe交换网,无需自定义驱动程序,而CUDA也可以发现GPU,并在Linux主机上运行P2P传输。性能类似于使用Windows主机实现的性能,如表1所示。
 
表1:GPU点对点传输带宽
 
如何使用PCIe交换网结构在多主机系统中优化资源部署
 
下一步是将SR-IOV虚拟功能连接到Windows主机,PAX将此类功能以标准物理NVM设备的形式提供,以便主机可以使用标准NVMe驱动程序。此后,虚拟功能将与Linux主机结合,并且新的NVMe设备将出现在模块设备列表中。本实验的结果是,两个主机现在都可以独立使用其虚拟功能。
 
务必注意的是,虚拟PCIe交换网和所有动态分配操作都以完全符合PCIe规范的方式呈现给主机,以便主机能够使用标准驱动程序。嵌入式交换网固件提供了一个简单的管理接口,这样便可通过成本低廉的外部处理器来配置和管理PCIe结构。设备点对点事务默认情况下处于使能状态,不需要外部结构管理器进行额外配置或管理。
 
总结
 
PCIe交换网结构是一种能够充分利用CPU巨大性能的绝佳方法,但PCIe标准本身存在一些障碍。不过,可以通过使用动态分区和多主机单根I/O虚拟化共享技术来解决这些难题,以便可以将GPU和NVMe资源实时动态分配给多主机系统中的任何主机,从而满足机器学习工作负载不断变化的需求。
(来源:Microchip Technology Inc.,作者:固件工程技术顾问 Vincent Haché)

 
免责声明:本文为转载文章,转载此文目的在于传递更多信息,版权归原作者所有。本文所用视频、图片、文字如涉及作品版权问题,请电话或者邮箱联系小编进行侵删。
 
 
要采购焊接么,点这里了解一下价格!

为您推荐

新品:闪迪 iNAND CL EM181 e.MMC 闪存,兼顾延续性、耐久度与数据可靠性 新品速递

新品:闪迪 iNAND CL EM181 e.MMC 闪存,兼顾延续性、耐久度与数据可靠性

对于机顶盒、家庭网关、智慧视频等长生命周期 IoT 与物理 AI 设备,存储方案延续性是一大痛点。闪迪在 2026 慕尼黑电子展发布全新 iNAND CL EM181 嵌入式 e.MMC 闪存驱动器,保留成熟 e.MMC 接口,支持客户在大幅减少主机改动的前提下升级新一代 NAND 技术,降低集成与认证成本。产品提供 64GB/128GB/256GB 容量,顺序读写最高 300MB/s、225MB/s,搭载 SmartSLC 与可配置 EUDA 分区,宽温 - 25℃~85℃,搭配 LDPC ECC、电源保护等机制,保障边缘互联设备的数据可靠。

AI&loT 通信广电 电源管理 互联技术 存储器

意法半导体自控式瞬态电压抑制器,以超小占板面积提供卓越保护 业界新闻

意法半导体自控式瞬态电压抑制器,以超小占板面积提供卓越保护

空间受限的消费、工业、医疗、智能家居设备对板级 ESD 与浪涌防护提出严苛要求。意法半导体全新推出自控式 TVS 器件 TVS221SC-1T2,采用 0402(1006)SOD882 封装,相比传统 TVS 面积缩减超 60%;依托内部电压控制环路,在 16A 浪涌、125℃工况下稳定维持 26.2V 钳位电压,±8kV 接触 /±30kV 空气 ESD 满足高等级 EMC 标准。器件具备 25nA 低漏电流、75nF 电容,适合 USB Type‑C VBUS、I/O 口保护,现已量产。

医疗穿戴 智能家居 电路保护 互联技术 电容 ST(意法半导体)

贸泽开售 Ezurio Veda IF912/IF913 模块 Wi‑Fi6/6E+BLE5.4 搭载英飞凌 CYW55912 业界新闻

贸泽开售 Ezurio Veda IF912/IF913 模块 Wi‑Fi6/6E+BLE5.4 搭载英飞凌 CYW55912

专注新品引入的授权代理商贸泽电子宣布,现已上架 Ezurio Veda IF912 与 IF913 无线模块。该系列基于英飞凌 AIROC CYW55912/CYW55913 芯片,集成 Wi‑Fi 6/6E、低功耗蓝牙 5.4 以及 Cortex‑M33 处理器,在 7×11mm 的 SMT 封装内整合无线、算力与存储资源,面向工业物联网、医疗设备、HVAC、安防摄像头、EV 充电设施等嵌入式场景,可简化硬件方案、降低 BOM 成本,同步配套 IF912DVK、IF913DVK 评估开发套件,方便工程师快速验证。

安防监控 医疗穿戴 电源管理 互联技术 通信模块 Infineon(英飞凌)

FPGA AXI 总线开发 12 个实战坑解析 避开握手、突发、反压等隐形陷阱 技术应用

FPGA AXI 总线开发 12 个实战坑解析 避开握手、突发、反压等隐形陷阱

AXI 总线是 FPGA SoC 开发的核心接口,广泛用于 Zynq PS-PL 交互、DDR、DMA、高速数据采集等场景。很多工程师熟练调用 Vivado IP,但自研 AXI Master、Slave 时经常遇到仿真正常、上板卡死、数据错位、总线死锁等问题。本文从工程实战角度,梳理 AXI4 开发里最容易踩的 12 个隐形陷阱,覆盖 VALID/READY 握手、通道独立机制、突发长度、WSTRB 字节使能、反压处理、跨时钟域、并发事务等重难点,帮助 FPGA 工程师规范 RTL 设计、高效调试。

互联技术 时钟

迈来芯发布 MLX90901 触觉指尖模组,为人形机器人提供三维力感知 新品速递

迈来芯发布 MLX90901 触觉指尖模组,为人形机器人提供三维力感知

迈来芯(Melexis)推出首款机电一体化触觉指尖模组 MLX90901,依托 Tactaxis® 磁传感技术实现三维力检测,同步采集法向力与双方向切向力;量程最高 15N 法向力、4N 切向力,典型分辨率 200mN,I²C 接口输出;配套 DVK90901 评估套件,解决当前触觉方案集成复杂、难以量产的痛点,帮助灵巧手、人形机器人厂商快速开发抓取滑移检测、闭环控制与物理 AI 算法。

互联技术 测试测量 Melexis(比利时迈来芯)

特别推荐

更多

行业动态

更多

技术应用

更多

选型替代

更多

产品信息

更多

热门搜索

更多

欢迎登录

没有账号,

账号注册

注册成功!

3S后自动为你跳转登陆