【导读】中国信息通信研究院华东分院与奇异摩尔近日在上海浦东联合主办“聚力向芯 算涌无界 Networking for AI”生态沙龙,围绕高性能互联技术与算力产业链协同展开深度探讨。作为AI网络全栈式互联产品及解决方案提供商,奇异摩尔展示了其在2.5D、3.5D先进互联领域的技术布局,旨在通过芯粒级产品构建更高效的算力基础设施。
2025年9月25日,中国信息通信研究院华东分院与奇异摩尔近日在上海浦东联合主办“聚力向芯 算涌无界 Networking for AI”生态沙龙,围绕高性能互联技术与算力产业链协同展开深度探讨。作为AI网络全栈式互联产品及解决方案提供商,奇异摩尔展示了其在2.5D、3.5D先进互联领域的技术布局,旨在通过芯粒级产品构建更高效的算力基础设施。
活动围绕“国产AI算力产业链实现闭环”这一主题,邀请AI算力产业链上下游企业及技术专家,包括中国移动、财跃星辰、腾讯云、沐曦、新华三、中科创星、无问芯穹、后摩智能、中昊芯英等行业头部及明星企业。内容覆盖从算力芯片到算法模型再到算力服务的全链条环节,展现了国产AI从技术突破到生态构建的整体进展,也标志着中国在科技自主化道路上的坚实脚步。
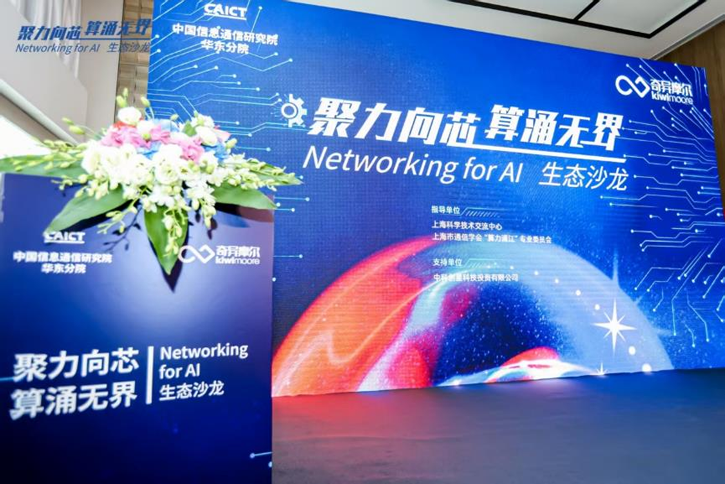
“聚力向芯 算涌无界 Networking for AI”生态沙龙活动
在开场致辞环节,中国信通院华东分院总工程师陈俊琰表示,“在国家战略指引和地方政策推动下,上海智能算力产业已形成‘基础夯实、创新活跃、场景丰富’的良好态势。面向上海要实现智能算力产业高质量发展,他提出了三点建议:一是强化技术创新协同,突破核心瓶颈。二是完善算力调度体系,提升配置效率。三是深化场景融合应用,赋能实体经济。中国信通院华东分院将继续发挥‘国家高端专业智库、产业创新发展平台’的作用,在算力领域的政策研究、标准制定、测试认证、生态建设等方面提供更有力的支撑。”
奇异摩尔联合创始人、产品解决方案副总裁祝俊东表示,“当前智算中心的建设模式已经从过去单纯的硬件采购发展为更深入的生态适配与共建。这一转型高度依赖于产业链各环节的互联互通与开放合作。作为产业链的一环,奇异摩尔具备横跨AI产业链系统级、芯片级与芯粒级的全栈互联产品解决方案及服务能力。依托我们在计算+网络双重维度的深厚技术积累,期待与产业伙伴协同创新,共同突破国产算力瓶颈,构建开放、开源的国产算力新生态”。
互联技术迎来价值跃迁
当前人工智能正引领全球迈入全新发展阶段。在AI Scaling Law的新范式驱动下,大模型技术从基座模型突破到推理模型跃迁的变革中迎来基础设施全面升级的新一轮转型期,算力已成为当下国力角逐的重要维度。超大规模智算集群技术突破和工程落地、智能算力统筹规划,以及数据、算力、电力、网络等多种资源的协同配合,已被国家提升至战略层面。
国务院印发《关于深入实施“人工智能+”行动的意见》,明确提出要强化8项基础支撑能力,包括提升模型基础能力、加强数据供给创新、强化智能算力统筹、优化应用发展环境、促进开源生态繁荣等。工信部也联合多部门发文,强调以新一代通信技术为驱动,构建覆盖感知、传输、存储与计算的基础设施体系,并合理布局区域枢纽节点,逐步提高智能算力占比。
随着AI推理的落地、算力集群建设提速,互联技术作为构建AI基础设施的关键环节正发挥越来越关键的作用。高带宽、低时延的互联能力,已成为提升模型性能、降低成本、实现普惠AI的重要路径。
在Scale-up网络侧,超节点正在发挥算力集群“神经中枢”的核心价值,通过将成百上千张GPU互联,帮助构建内部高速、低延迟的通信网络,提升系统的效率与计算上限,支撑大规模模型的训练和并行推理。
互联技术及相关业务,已经成为英伟达的战略支柱。英伟达专为GPU间通信,设计了点对点的高速互联技术NVLink,最新的NVLink 5.0为每个Blackwell GPU提供高达1.8TB/s的双向带宽。同时,为实现多GPU的全互联,英伟达引入了NVSwitch芯片,在GB200 NVL72系统中,通过18颗NVLink 5 Switch芯片,构建了总带宽高达130TB/s的72 GPU NVLink域。
奇异摩尔作为国内AI网络互联领域极少数可提供全栈式互联产品架构及解决方案的供应商,公司市场定位与方案优势,在算力集群互联发展正当其时的趋势之下,同样值得关注。
依托于高性能RDMA和芯粒技术,构建了一整套覆盖面向北向Scale-out网间互联、面向南向Scale-up超节点GPU片间互联,以及Scale-inside芯片内互联的产品解决方案,为AI高性能计算提供了坚实的支撑。
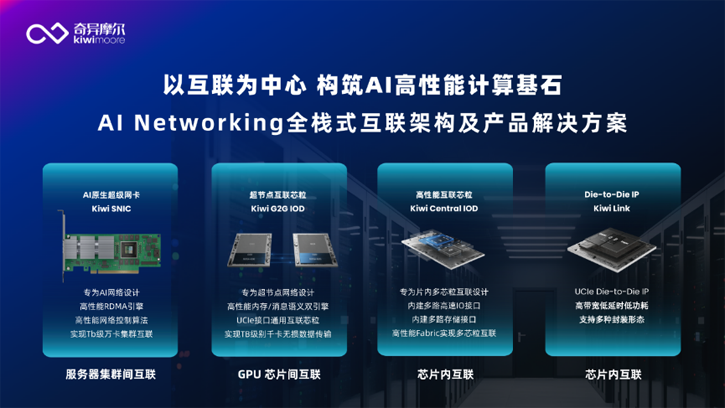
针对构建千卡规模超节点HBD域,奇异摩尔的Kiwi G2G IO Die超节点互联芯粒,是业内少有的基于开源系统的超节点片间互联方案,具有高带宽、低延时的特性,可以实现TB级别的带宽。G2G IOD在支持消息语义的同时,进一步支持内存语义,通过与GPU厂商、云厂商及交换机厂商持续协作适配,全面赋能国产算力的开源闭环。
在Scale-out网络侧,奇异摩尔打造的Kiwi SNIC AI原生超级网卡,性能可对标主流国际高性能ASIC产品,支持高达800Gbps的传输带宽,提供低至μs级的数据传输延时,能够满足当前智算中心对网络传输的升级需求,实现Tb级别万卡集群间的无损数据传输。
奇异摩尔首席网络技术专家叶栋在活动演讲中表示,“奇异摩尔的超节点互联芯粒及AI原生超级网卡均基于Kiwi NDSA统一技术平台,采用HPDE高性能可编程架构设计,该架构下产品具有优秀性能的同时还兼顾灵活性。相比英伟达等互联技术,能更好地支持市面上不同算力服务商的最新技术标准和网络环境,实现高性能,可靠性与灵活性的融合。”
奇异摩尔首席网络技术专家叶栋
在提升行业单芯片算力技术方面,奇异摩尔的片内互联方案,基于UCIe的D2D IP及Central IO Die及3D Base Die系列,可赋能AI芯片/高性能芯片的算力提升,进一步提升AI网络的单卡算力。
以先进互联技术助推产业共建,打造中国自主创新闭环
DeepSeek的出现为AI行业带来算法变革,激发海量且多样化的算力需求。为解决集群运行效率,超节点等互联技术的发展已经势在必行。而这些技术的产业化落地,亟需依托覆盖全方案、全产业链的互联技术标准架构作为牵引,纵向支撑智算集群性能扩展。
在此背景下,中国移动、新华三、沐曦等行业头部企业,正在发挥各自产业优势,推动集群算力与互联技术实现规模化系统级部署。今年8月,中国移动联合国内数十家运营商、互联网企业、芯片厂商、服务器制造商及科研院所,共同启动智算开放互联OISA生态共建战略合作,并发布OISA 2.0协议。OISA 2.0进一步将支持的AI芯片数量提升至1024 张,带宽突破TB/s级别,AI芯片互联时延缩短至数百纳秒,为大模型训练、推理及高性能计算等数据密集型AI应用提供有力支撑。
“OISA致力于打破传统Scale-up协议在带宽与延迟上的固有瓶颈,其核心价值显著且深远,不仅为业界拓展了下一代计算与网络一体化的技术路线选择,更明确了OISA IP、OISA IO芯粒等互联承载物的关键设计方向,为构建开放协同的产业生态、筑牢未来智算中心的发展根基,提供了极具指导意义的关键蓝图。”中国移动研究院技术经理李锴在演讲中特别强调,“作为OISA体系的积极践行者,奇异摩尔深度投身生态建设,在协议及IO芯粒的标准制定与产品研发中全力推进生态适配,为《OISA全向智感互联IO芯粒技术白皮书》的编撰贡献了关键力量。”
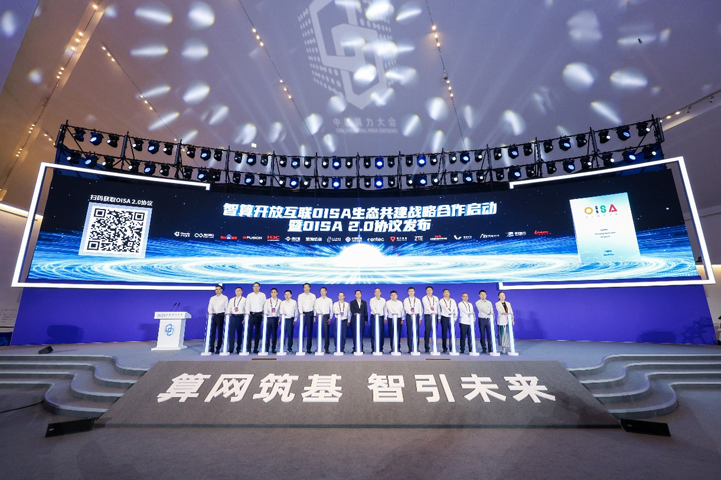
OISA生态共建战略合作启动仪式
沐曦作为国产AI算力芯片的头部企业,已形成以旗舰产品曦云C500为代表的完整产品线,涵盖芯片、板卡、服务器及多形态超节点乃至千卡集群,具备从底层硬件到数据中心部署的全链路解决方案。同时,沐曦还创新多种超节点形态,包括光互连超节点、耀龙3D Mesh超节点、Shanghai Cube国产高密度液冷整机柜等,将为构建安全可控、场景适配的国产算力体系提供有生力量。
沐曦股份研究院院长李兆石在活动上表示,“超节点互联协议设计需要算网融合。当前超节点使用的互联协议虽然能满足基本需求,但还有很大的性能提升空间。国内智算产业需要上下游协同,才能做出媲美国际先进水平的产品。”
新华三发布的全新H3C UniPoD系列超节点基于多元算力生态,开放兼容以太网和PCIe协议双技术路线,实现高性能Scale-up互联。该系列支持整机柜液冷集成交付与节点机柜解耦交付,并通过软硬协同优化实现快速业务构建与全栈能力交付。UniPoD能够实现单机柜最高64卡GPU间的高速互联互通,可为万亿级参数大模型训练及推理提供更强劲、更智能、更绿色的算力供给。
中科创星董事总经理卢小保表示:“算力、存力、互联是AI底层硬件的核心。AI算力需求趋势是由单体智能往群体智能发展,Scaling Law下,互联的作用越来越凸显,片内互联、片间互联、卡间互联、超级点内互联,到集群互联,在不同技术层面上,互联成了延续摩尔定律、不断提升算力密度的核心解决路径。在国内先进工艺受限的情况下,互联更是具备特殊价值,让国内算力产业可以以规模和成本换性能,实现算力自立。”
此外,本次AI生态沙龙还得到了来自阶跃星辰合资企业财跃星辰、腾讯云、中昊芯英、无问芯穹、后摩智能等行业头部企业技术专家的大力支持。
业内投资专家曾指出:“未来三年,谁能把国产算力高效‘连’起来,谁就能赢得AI基础设施的赛点。”互联,这个曾经被忽视的技术角落,正成为国产AI算力能否真正实现闭环的关键一战。
推荐阅读:
压电蜂鸣器技术深度剖析:原理、优势与国内外厂商对比
安森美获Vcore技术授权,强化AI数据中心电源解决方案
如何利用OTT技术实现模拟前端的80V过压保护
贸泽电子新推EIT专题:洞察3D打印如何重塑设计与制造
聚焦能效与性能,Vishay为AI及电动汽车注入“芯”动力

 技术应用