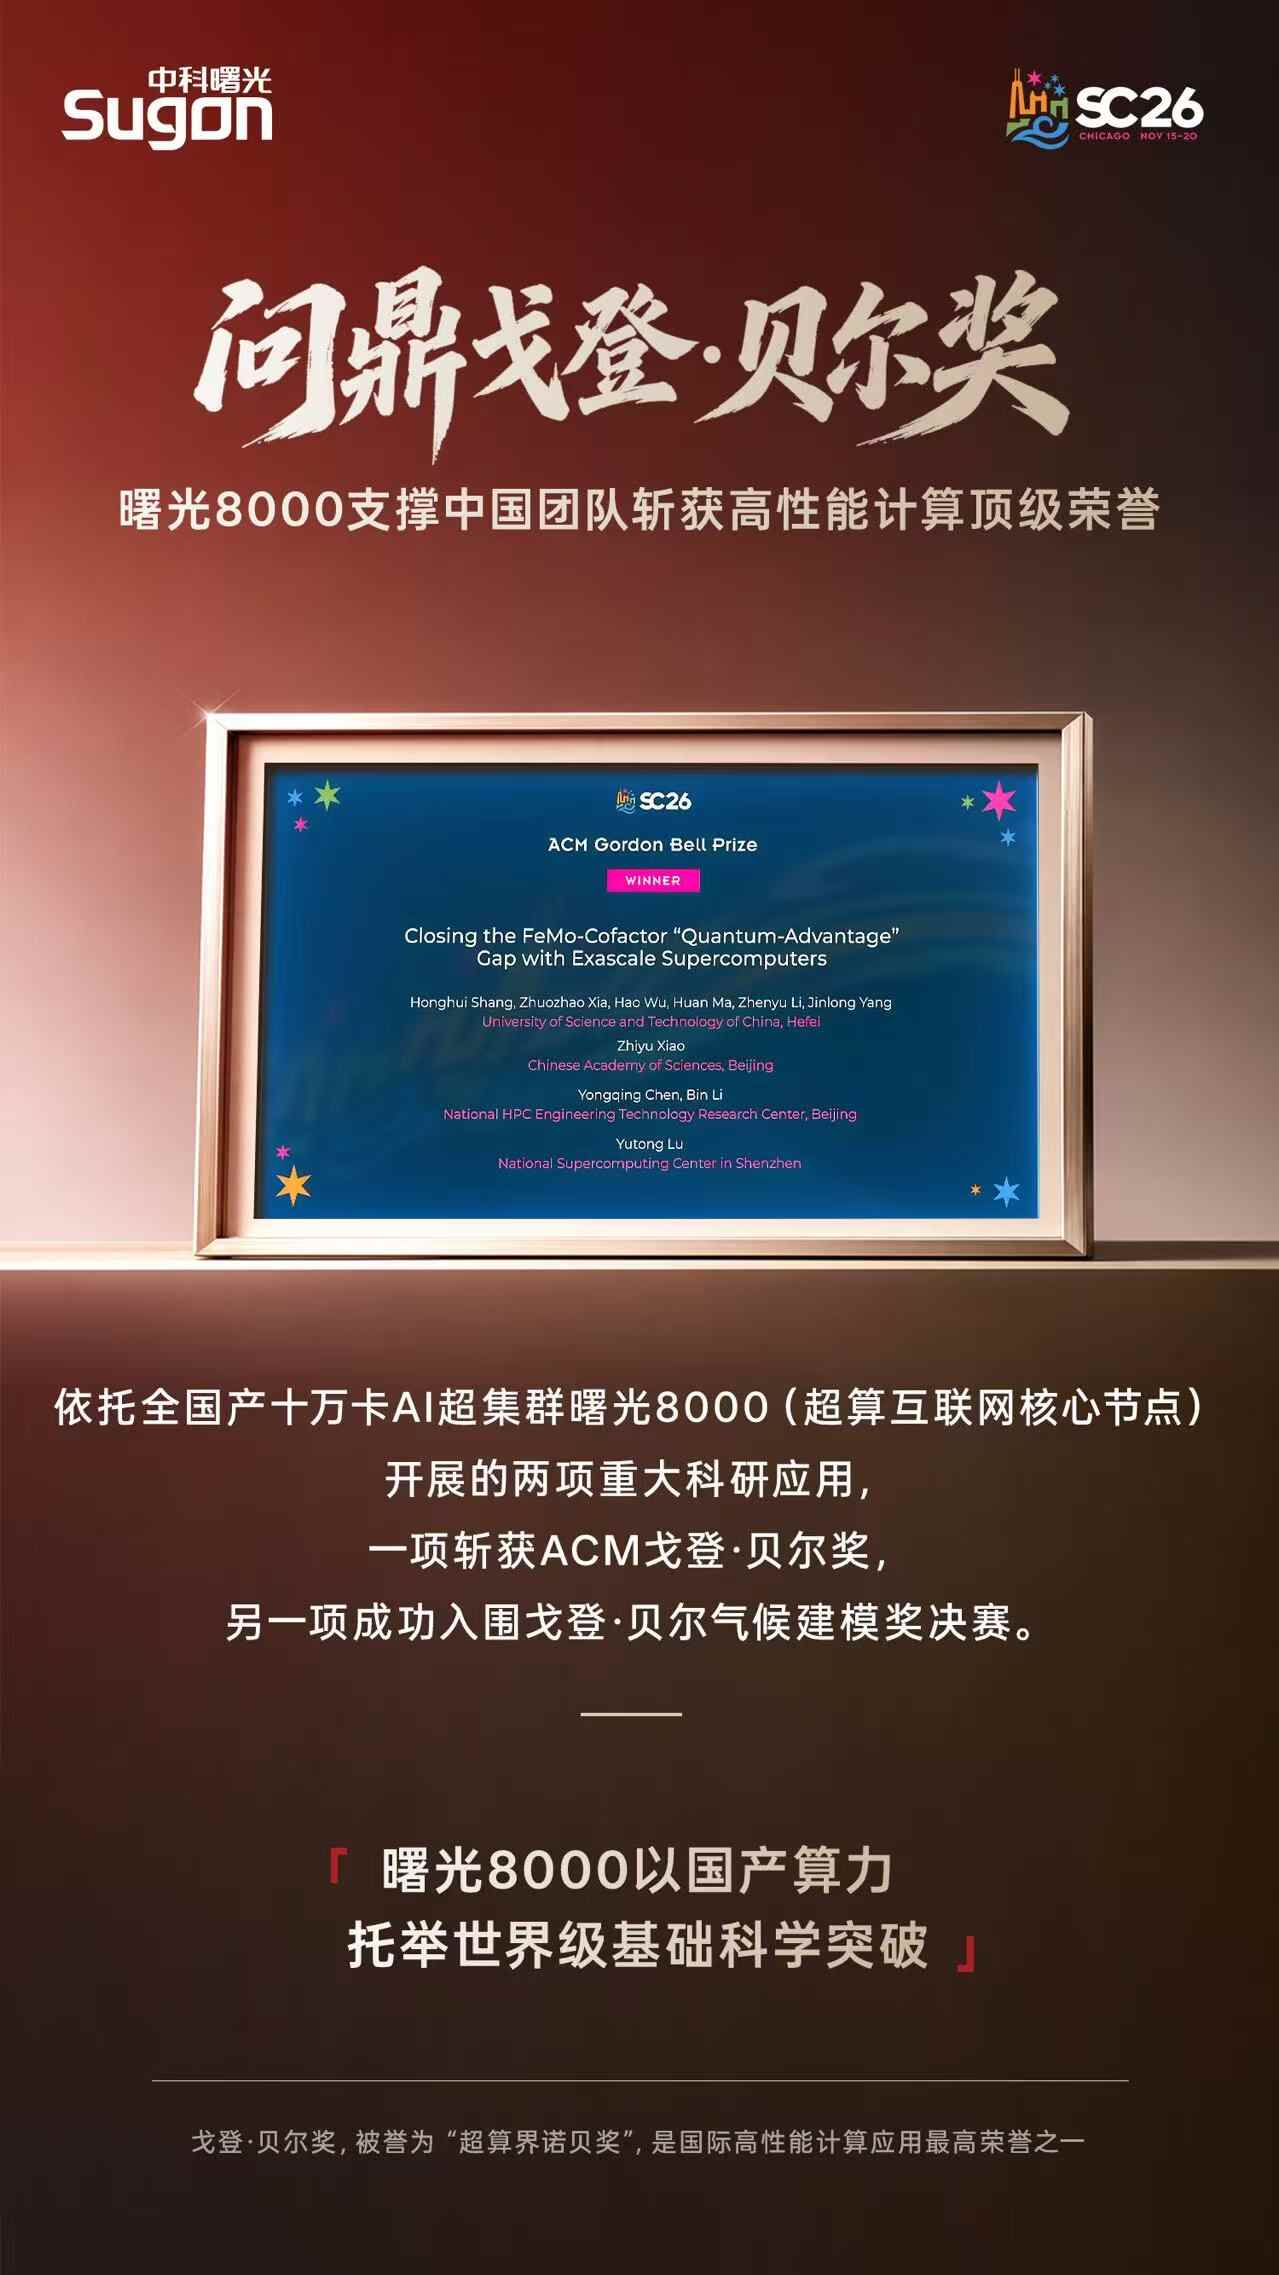
【导读】11 月 19 日 SC26 国际超算大会传来重大喜讯,依托全国产十万卡 AI 超集群曙光 8000(登峰)算力支撑的两项科研成果大放异彩:中科大团队的铁钼辅因子量子化学计算成果斩获戈登・贝尔奖,SD3 全球公里级气象模拟系统入围戈登・贝尔气候建模奖决赛。曙光 8000 于今年 7 月投用,采用原生超智融合架构,统一承载科学计算与 AI 计算,上线后高负载稳定运行。本次获奖标志国产超大规模算力,已经从硬件规模突破,走向支撑世界级原创科学发现。
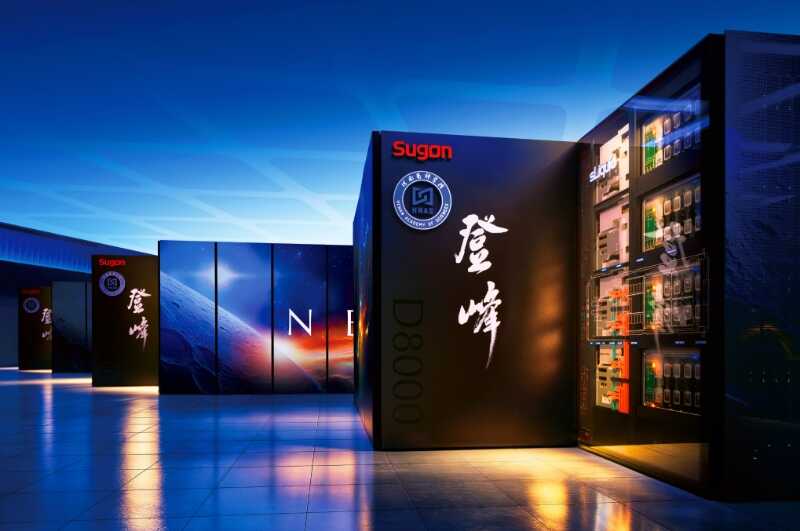
电子元件技术网获悉:从今年7月正式投用至今,短短四个多月,曙光8000再交出两项世界级科研成果的亮眼答卷。这不仅是中国科研团队在国际高性能计算领域取得的重要突破,更标志着国产超大规模计算系统正加速从算力能力突破走向重大科学发现,展现出支撑世界级科研创新的强劲实力。
攻克量子化学难题,中国科研问鼎国际大奖
此次斩获ACM戈登·贝尔奖的成果,由中国科学技术大学联合中国科学院、国家高性能计算机工程技术研究中心等单位共同完成,聚焦铁钼辅因子(FeMo-Cofactor)量子化学计算这一国际前沿难题。
铁钼辅因子是自然界生物固氮过程中的关键物质,其复杂的电子结构和量子行为长期以来是计算化学领域的重要挑战。准确模拟这一体系,不仅有助于理解生物固氮的微观机制,也将为催化化学、能源材料等领域的基础研究提供重要支撑。
面对这一复杂科学问题,科研团队创新计算方法,突破超大规模量子化学计算的关键瓶颈,首次实现铁钼辅因子关键活性空间的经典计算求解,为探索复杂量子体系提供了新的技术路径。
项目研发过程中,曙光8000凭借强大的超智融合计算能力,为相关算法研发、应用优化及大规模科研计算提供支撑,助力前沿计算方法在国产超大规模系统上得到应用验证。
从过去难以求解的复杂科学问题,到如今取得具有国际影响力的研究突破,这项成果充分展现了先进计算与科学研究深度融合的巨大潜力。中国科研团队的此次夺魁,也让国产先进计算系统在世界级科研创新中展现出更为重要的价值。
从微观量子到全球气象,世界级应用再添成果
与量子化学领域的突破相呼应,另一项由中科天机气象科技有限公司自主研发的SD3全球公里级气象数值模拟系统,同样在SC26国际舞台上取得重要进展,成功入围ACM戈登·贝尔气候建模奖决赛。
全球公里级气象模拟是国际气象科学研究的重要前沿。随着模拟分辨率不断提高,科研人员能够更加精细地刻画大气运动过程,但随之而来的计算规模、数据处理和系统性能需求也呈指数级增长,对底层算力基础设施提出极高要求。
SD3系统通过计算架构与数值模拟技术创新,实现高分辨率全球气象模拟的高效运行。根据SC26公布的研究成果,该系统已实现全球1.5公里分辨率下,每天模拟205.7天的计算能力,展现出大规模异构计算支撑高精度气象研究的巨大潜力。
在相关研究与应用实践中,曙光8000为SD3系统提供了重要算力支撑,推动先进计算能力与气象科学应用深度结合。相关技术成果可为全球高分辨率天气预测、极端天气研究及地球系统模拟提供支撑,进一步拓展先进计算服务重大科学问题的应用空间。
从探索微观世界的量子化学,到研究宏观世界的大气运动,两项成果跨越不同科学领域,却共同指向一个重要趋势:超大规模算力正在成为推动前沿科学突破的重要基础设施,而国产计算系统已具备承载世界级复杂科研应用的能力。
投用不到半年,十万卡超集群加速释放科研创新效能
两项世界级成果背后,是曙光8000持续释放的超大规模计算能力。
今年7月,中科曙光正式发布并投用中国首个全国产十万卡AI超集群——曙光8000(登峰),并同步接入国家超算互联网,实现国产超大规模计算基础设施的重要跨越。
与传统单一计算架构不同,曙光8000采用原生超智融合技术路线,将高精度科学计算与智能计算能力统一于同一系统,支持从FP64到INT8的多精度计算,能够满足量子化学、气象模拟、生命科学、工业仿真等复杂场景对计算精度、规模及效率的不同需求。
在系统层面,曙光8000通过国产计算芯片、高速互连网络、大规模分布式存储、液冷基础设施及系统软件的协同创新,构建起支撑十万卡规模高效运行的完整技术体系。这不仅是计算资源规模的突破,更是超大规模并行计算、复杂任务调度和应用性能优化等系统能力的集中体现。
尤其值得关注的是,曙光8000的价值正通过真实科研应用得到持续检验。 自投用以来,集群迅速进入高负载运行状态,上线即需求火爆,日均处理作业数超过15万个。
与此同时,依托强大的超智融合架构和开放计算生态,曙光8000不断深化与科研团队的协同创新,推动多领域应用从适配验证走向规模化运行。在量子化学、气象科学、生命科学、流体力学等领域,国产超大规模计算系统正持续展现出解决复杂科学问题的应用潜力。
此次ACM戈登·贝尔奖夺魁及气候建模奖入围,正是曙光8000应用能力的又一次集中展示。短短四个多月,从十万卡系统建成投用,到世界级科研成果接连涌现,曙光8000正在以实际应用成效,持续验证国产先进计算技术路线的科学价值与工程能力。
从算力突破到科学突破,国产计算走向世界前沿
衡量先进计算系统的价值,不仅在于拥有多大规模的算力,更在于能够支撑多复杂的科研任务、解决多重要的科学问题。
长期以来,超大规模计算能力是突破前沿科学研究瓶颈的重要支撑。随着科学智能与传统科学计算加速融合,科研创新对计算基础设施的需求,正从单纯追求性能规模,转向对计算精度、系统效率、应用适配和持续运行能力的综合考验。
此次两项世界级科研成果,正展现出国产先进计算系统在这一趋势下的应用潜力:不仅能够支撑超大规模计算任务,更能够与科学算法、应用软件及科研需求深度协同,将底层技术能力转化为可验证、可复现的科研成果。
从支撑国际顶尖科研成果,到服务更多重大科学问题,曙光8000正在推动国产算力基础设施实现从“建得成、跑得稳”向“用得好、出成果”的跨越。
面向未来,中科曙光将持续深化超智融合技术创新与开放计算生态建设,推动先进计算技术与重大科研应用协同发展,加快国产超大规模计算能力向科学创新能力转化。
从十万卡集群的工程突破,到世界级科研成果的创新突破,曙光8000正在以实际成果证明:国产先进计算不仅能够支撑世界级应用,更能够成为中国科研走向世界前沿的重要力量。
结论
本次戈登・贝尔奖获奖,是曙光 8000 国产十万卡超集群落地应用的标志性成果。区别于单纯比拼算力参数,它证明国产超智融合算力平台,可以支撑量子化学、高分辨率气象模拟这类难度极高的前沿科研任务。依托国产芯片、高速互联、液冷与整套系统栈协同,曙光 8000 打通了底层算力到上层科学应用的链路,实现从 “能跑大规模任务” 到 “产出世界级科研成果” 的跨越。随着算力生态持续完善,国产超算将持续赋能催化材料、气象预测、生命科学、工业仿真等方向,助力更多前沿科学难题攻关。

 业界新闻