业界新闻

爆料称英伟达下一代GPU基于三星10nm制程 光线追踪性能提升40%

发布时间:2020-03-13 00:00:00 责任编辑:lina

【导读】3 月 13 日讯,昨日,有爆料消息称英伟达的下一代 GPU 架构将基于三星 10nm 制程,而不是之前报道的台积电 7nm 工艺,据称使用的 10nm 制程更接近于三星提供的 8LPP 技术,另外新的 Tegra 芯片也将使用相同的制程。
  
3 月 13 日讯,昨日,有爆料消息称英伟达的下一代 GPU 架构将基于三星 10nm 制程,而不是之前报道的台积电 7nm 工艺,据称使用的 10nm 制程更接近于三星提供的 8LPP 技术,另外新的 Tegra 芯片也将使用相同的制程。
 
之前放出两张疑似是 Ampere GPU 核心架构图的 Twitter 帐号@CorgiKitty 在昨天也发布了新的传言,称新一代芯片将会使用三星的 10nm 节点工艺,而不是此前坊间传闻中的 7nm EUV 工艺。
 
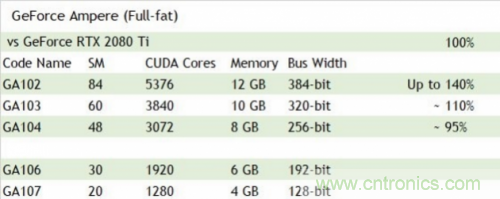
外媒表示,英伟达安培架构曝光的 GPU 有 GA102、GA103、GA104、GA106 和 GA1075 款,配置最高的是 GA102。报道还称英伟达新款 GPU 将全部支持 RTX(实时光线跟踪),这意味着英伟达在安培架构上对 RT 核心设计进行升级,使其在性能较弱的显卡中也能实现光线追踪的效果。

爆料称英伟达下一代GPU基于三星10nm制程 光线追踪性能提升40%
 
一、实时光线跟踪
 
英伟达新款 GPU 将全部支持 RTX(实时光线跟踪),这意味着英伟达在安培架构上对 RT 核心设计进行升级,使其在性能较弱的显卡中也能实现光线追踪的效果。
 
使用基于光线追踪的算法(包括 ray tracing, path tracing, photon mapping, beam tracing, cone tracing 等等 )进行图形渲染。渲染对象是包含真实刚体及柔体物理模拟的动态场景。场景分辨率需达到 720P,并需要允许动态摄像机以及多光源(点 / 面光源)。渲染帧率需不低于 30 并以 60 为目标,渲染结果应该有较小的(肉眼难于分辨的)噪点。如果是 path tracing 等蒙特卡洛方法,则还需要无偏的结果(不然会出现局部模糊等 artifacts)。
 
目前的应用包括各类照片级渲染应用中场景设计的快速原型生成,视频游戏中的部分场景渲染。未来的应用领域会更加广阔。但实时的光线追踪的难点在于场景复杂度和需要的真实感渲染效果决定了遍历和相交检测的巨大计算量(场景分割数据结构的重构和光线与场景的相交测试是两项主要计算)。这是渲染领域以及任何模拟计算领域里终极的矛盾:效率和质量的矛盾。
 
目前的解决方案有两个方向的努力:软件角度和硬件角度,软件角度又可以分为自低向上和自顶向下的优化:BVH 和其他层级结构的场景分割(kd-tree, oc-tree, BSP-tree 等)是自顶向下的方法,在对场景进行分割时还有一项十分常用的优化算法:Surface Area Heuristic (SAH)。硬件角度的优化又可以分为采用 GPU 和 SIMD 的优化以及专门的 ray tracing 硬件。前者就是对上述软件优化的算法进行针对 GPU 或 SIMD 的优化,同时一些并行环境下的数学库函数和其他基本算法如排序等也间接起到了加速的作用。后者就是指将 ray tracing 中独有的相交检测,场景分割等部分采用专门的硬件来优化。此次英伟达新款 GPU 将全部支持 RTX(实时光线跟踪),RT 核心方面的设计已逐步完善。
 
二、NVIDIA 的新核心比上代性能提升了 40%
在 GeekBench 5 测试数据库里面,曝光了两组 NVIDIA 的新核心,参数暴涨,规格相当的强大,但都达不到 8192 个 CUDA 核心。其中一块核心拥有 118 组计算单元,假如每组继续延续 64 个流处理器的规格,那么 CUDA 核心数量就是 7552 个,低于在此之前爆料的 8192 个 CUDA 核心。
 
另一块核心削减了 108 组计算单元,于是 CUDA 核心就只有 6912 个,至于频率在 1.01GHz 左右。这样的参数远于 8912 个 CUDA 核心。
 
但我们可不可以这么认为,128 组计算单元对应 8192 个 CUDA 核心数是这块核心的最大规格,至于 118 组计算单元和 108 组计算单元,是阉割后的版本,分别适用于不同的领域。
 
配置最低的 GA107 为 1280 流处理器,4GB 显存,最高的 GA102 GPU 为 5376 流处理器,12GB 显存,其中 GA102 比上代的 RTX 2080Ti 性能提升了 40%。
 
爆料称英伟达下一代GPU基于三星10nm制程 光线追踪性能提升40%
图片来源:GeekBench 5 测试数据库
 
免责声明:本文为转载文章,转载此文目的在于传递更多信息,版权归原作者所有。本文所用视频、图片、文字如涉及作品版权问题,请联系小编进行处理。
 
 
推荐阅读:
博通反悔出售无线芯片业务,将继续投资和运营
风华高科斥巨资建高端MLCC工厂,能成为本土电容转折点吗?
TWS火热,2019年全球可穿戴设备市场大增89%
最新消息!三星通知:存储芯片调涨两位数!
传台积电将于4月量产5nm芯片,产能已爆满

为您推荐

亚马逊云科技与NVIDIA宣布大幅扩展战略合作,将新增部署200万GPU 业界新闻

亚马逊云科技与NVIDIA宣布大幅扩展战略合作,将新增部署200万GPU

2026年——当AI工作负载从试点走向规模化生产,从代理式AI延伸到物理AI,算力基础设施的“天花板”正以前所未有的速度被逼近。今天,亚马逊云科技与NVIDIA宣布大幅扩展战略合作,计划于2027-2028年间在全球基础设施中新增部署200万个NVIDIA GPU,并将合作从GPU延伸至Vera CPU、NVHBM定制内存、Spectrum-X网络、Nemotron开放模型乃至机器人物理AI平台。
GPU Nvidia(英伟达)

SuperX 获日本客户 3,880 万美元 B300 GPU 服务器订单,拓展横滨 AI 基础设施项目 市场分析

SuperX 获日本客户 3,880 万美元 B300 GPU 服务器订单,拓展横滨 AI 基础设施项目

AI算力市场的竞争早已不限于芯片本身,服务器集群的交付速度、液冷方案和本地化服务能力正成为客户选择供应商的关键考量。8月25日,纳斯达克上市的SuperX AI Technology宣布,其日本子公司与当地客户Woodman签署了约3880万美元的采购订单,为其横滨AI基础设施项目提供基于NVIDIA B300 GPU的服务器集群,计划11月中旬交付。这是SuperX在日本市场的首笔商业合作,也是公司继RTX Pro 6000产品线布局后,在新一代高密度GPU算力平台上的又一次项目落地。
GPU Nvidia(英伟达)

推理性能飙升 7 倍:NVIDIA Dynamo 1.0 重塑 Blackwell GPU 生产力 选型指南

推理性能飙升 7 倍:NVIDIA Dynamo 1.0 重塑 Blackwell GPU 生产力

在数据中心推理需求呈爆发式增长的背景下,NVIDIA 于 GTC 2026 大会上正式推出了开源软件 NVIDIA Dynamo 1.0,旨在为大规模分布式推理构建生产级的基础架构。作为专为“AI 工厂”打造的分布式“操作系统”,Dynamo 1.0 通过与 NVIDIA Blackwell GPU 平台的深度协同,不仅将推理性能最高提升了 7 倍,更通过智能的资源编排与流量控制技术,有效解决了显存限制与资源浪费难题。
GPU Nvidia(英伟达)

单机架144个GPU!Supermicro全新液冷B300方案实现超大规模无缝扩展 选型指南

单机架144个GPU!Supermicro全新液冷B300方案实现超大规模无缝扩展

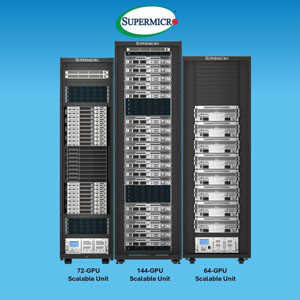
Supermicro(超微) 近日宣布其基于 NVIDIA Blackwell架构 的产品线实现重大扩展,正式推出并开始批量供货全新的 4U及2-OU(OCP)液冷式NVIDIA HGX B300系统。这不仅是硬件的迭代,更是其 “数据中心建构组件解决方案” 理念的深化实践,旨在为超大规模数据中心和AI工厂提供前所未有的 GPU计算密度 与 能源效率,直接回应了市场对更高性能、更低总拥有成本的迫切需求。

能源电路 GPU Nvidia(英伟达)

特别推荐

更多

行业动态

更多

技术应用

更多

选型替代

更多

产品信息

更多

热门搜索

更多

欢迎登录

没有账号,

账号注册

注册成功!

3S后自动为你跳转登陆