GPU

芯原股份推出 GLTiny 轻量 GPU 编程模型,面向资源受限可穿戴设备优化 3D 图形开发 业界新闻

芯原股份推出 GLTiny 轻量 GPU 编程模型,面向资源受限可穿戴设备优化 3D 图形开发

芯原股份(芯原,股票代码:688521.SH)今日宣布推出创新的3D图形处理(GPU)编程模型GLTiny,其专为功耗和内存资源受限的可穿戴设备而设计。GLTiny提供精简的应用程序编程接口(API),并配备超轻量级驱动,使开发者能够利用芯原Nano OpenGL ES GPU IP系列的3D图形处理能力,为下一代智能手表、智能眼镜及其他资源受限的可穿戴设备带来丰富的视觉体验。
医疗穿戴 电源管理 互联技术 GPU ES(恩盛)

性能全面跃升 Imagination E系列GPU落地全能融合架构 夯实GPU-First战略 新品速递

性能全面跃升 Imagination E系列GPU落地全能融合架构 夯实GPU-First战略

2026年9月21日(北京)——Imagination Technologies(以下简称“Imagination”)今日公布了其E系列GPU IP的首批性能数据和演示结果,并推出全新的Neural Super Resolution(NSR,神经超分辨率)AI加速超分辨率解决方案。这些最新进展进一步体现了Imagination的GPU-first战略:通过一套架构和一套软件栈,让芯片设计厂商能够运行图形、计算和AI等不同类型的工作负载。

GPU SUPER(杰耐特)

MLPerf Inference v6.1成绩出炉 英特尔纯软件优化大幅释放至强、锐炫Pro GPU算力价值 业界新闻

MLPerf Inference v6.1成绩出炉 英特尔纯软件优化大幅释放至强、锐炫Pro GPU算力价值

MLCommons最新发布的MLPerf Inference v6.1基准测试结果显示,英特尔依托持续的全栈软件优化,在硬件配置不变的前提下,显著提升至强6处理器与锐炫Pro B系列GPU的AI推理性能。本次测试不仅实现多款主流大模型推理效率的大幅跃升,测试覆盖场景、产品型号与生态参与度也同步扩容。这些成绩的背后,同样体现了客户和生态伙伴日益深入的参与,越来越多的系统选择在英特尔平台上完成验证,覆盖更多模型、更多工作负载以及更丰富的部署场景。

测试测量 GPU

亚马逊云科技与NVIDIA宣布大幅扩展战略合作,将新增部署200万GPU 业界新闻

亚马逊云科技与NVIDIA宣布大幅扩展战略合作,将新增部署200万GPU

2026年——当AI工作负载从试点走向规模化生产,从代理式AI延伸到物理AI,算力基础设施的“天花板”正以前所未有的速度被逼近。今天,亚马逊云科技与NVIDIA宣布大幅扩展战略合作,计划于2027-2028年间在全球基础设施中新增部署200万个NVIDIA GPU,并将合作从GPU延伸至Vera CPU、NVHBM定制内存、Spectrum-X网络、Nemotron开放模型乃至机器人物理AI平台。

GPU Nvidia(英伟达)

SuperX 获日本客户 3,880 万美元 B300 GPU 服务器订单,拓展横滨 AI 基础设施项目 业界新闻

SuperX 获日本客户 3,880 万美元 B300 GPU 服务器订单,拓展横滨 AI 基础设施项目

AI算力市场的竞争早已不限于芯片本身,服务器集群的交付速度、液冷方案和本地化服务能力正成为客户选择供应商的关键考量。8月25日,纳斯达克上市的SuperX AI Technology宣布,其日本子公司与当地客户Woodman签署了约3880万美元的采购订单,为其横滨AI基础设施项目提供基于NVIDIA B300 GPU的服务器集群,计划11月中旬交付。这是SuperX在日本市场的首笔商业合作,也是公司继RTX Pro 6000产品线布局后,在新一代高密度GPU算力平台上的又一次项目落地。

GPU Nvidia(英伟达)

英特尔Hot Chips 2026连发三款架构:256核至强、350W推理GPU、17TOPS NPU 新品速递

英特尔Hot Chips 2026连发三款架构:256核至强、350W推理GPU、17TOPS NPU

Hot Chips 2026上,英特尔一次性端出三款新架构:面向企业级智能体AI的Diamond Rapids处理器、专攻高效推理的Crescent Island GPU,以及针对主流客户端和边缘计算的Wildcat Lake SoC。三者共享Intel 18A制程、Foveros Direct 3D封装和UCIe芯粒互连标准。英特尔CTO Pushkar Ranade表示,智能体AI正重构计算平台的构建方式,通用计算与专用加速必须融合先进封装和开放芯粒,才能在功耗和成本约束下真正落地。

电源管理 GPU DIAMOND(钻石牌)

Imagination E 系列 GPU 斩获架构创新奖 融合算力架构破解物理 AI 系统设计难题 业界新闻

Imagination E 系列 GPU 斩获架构创新奖 融合算力架构破解物理 AI 系统设计难题

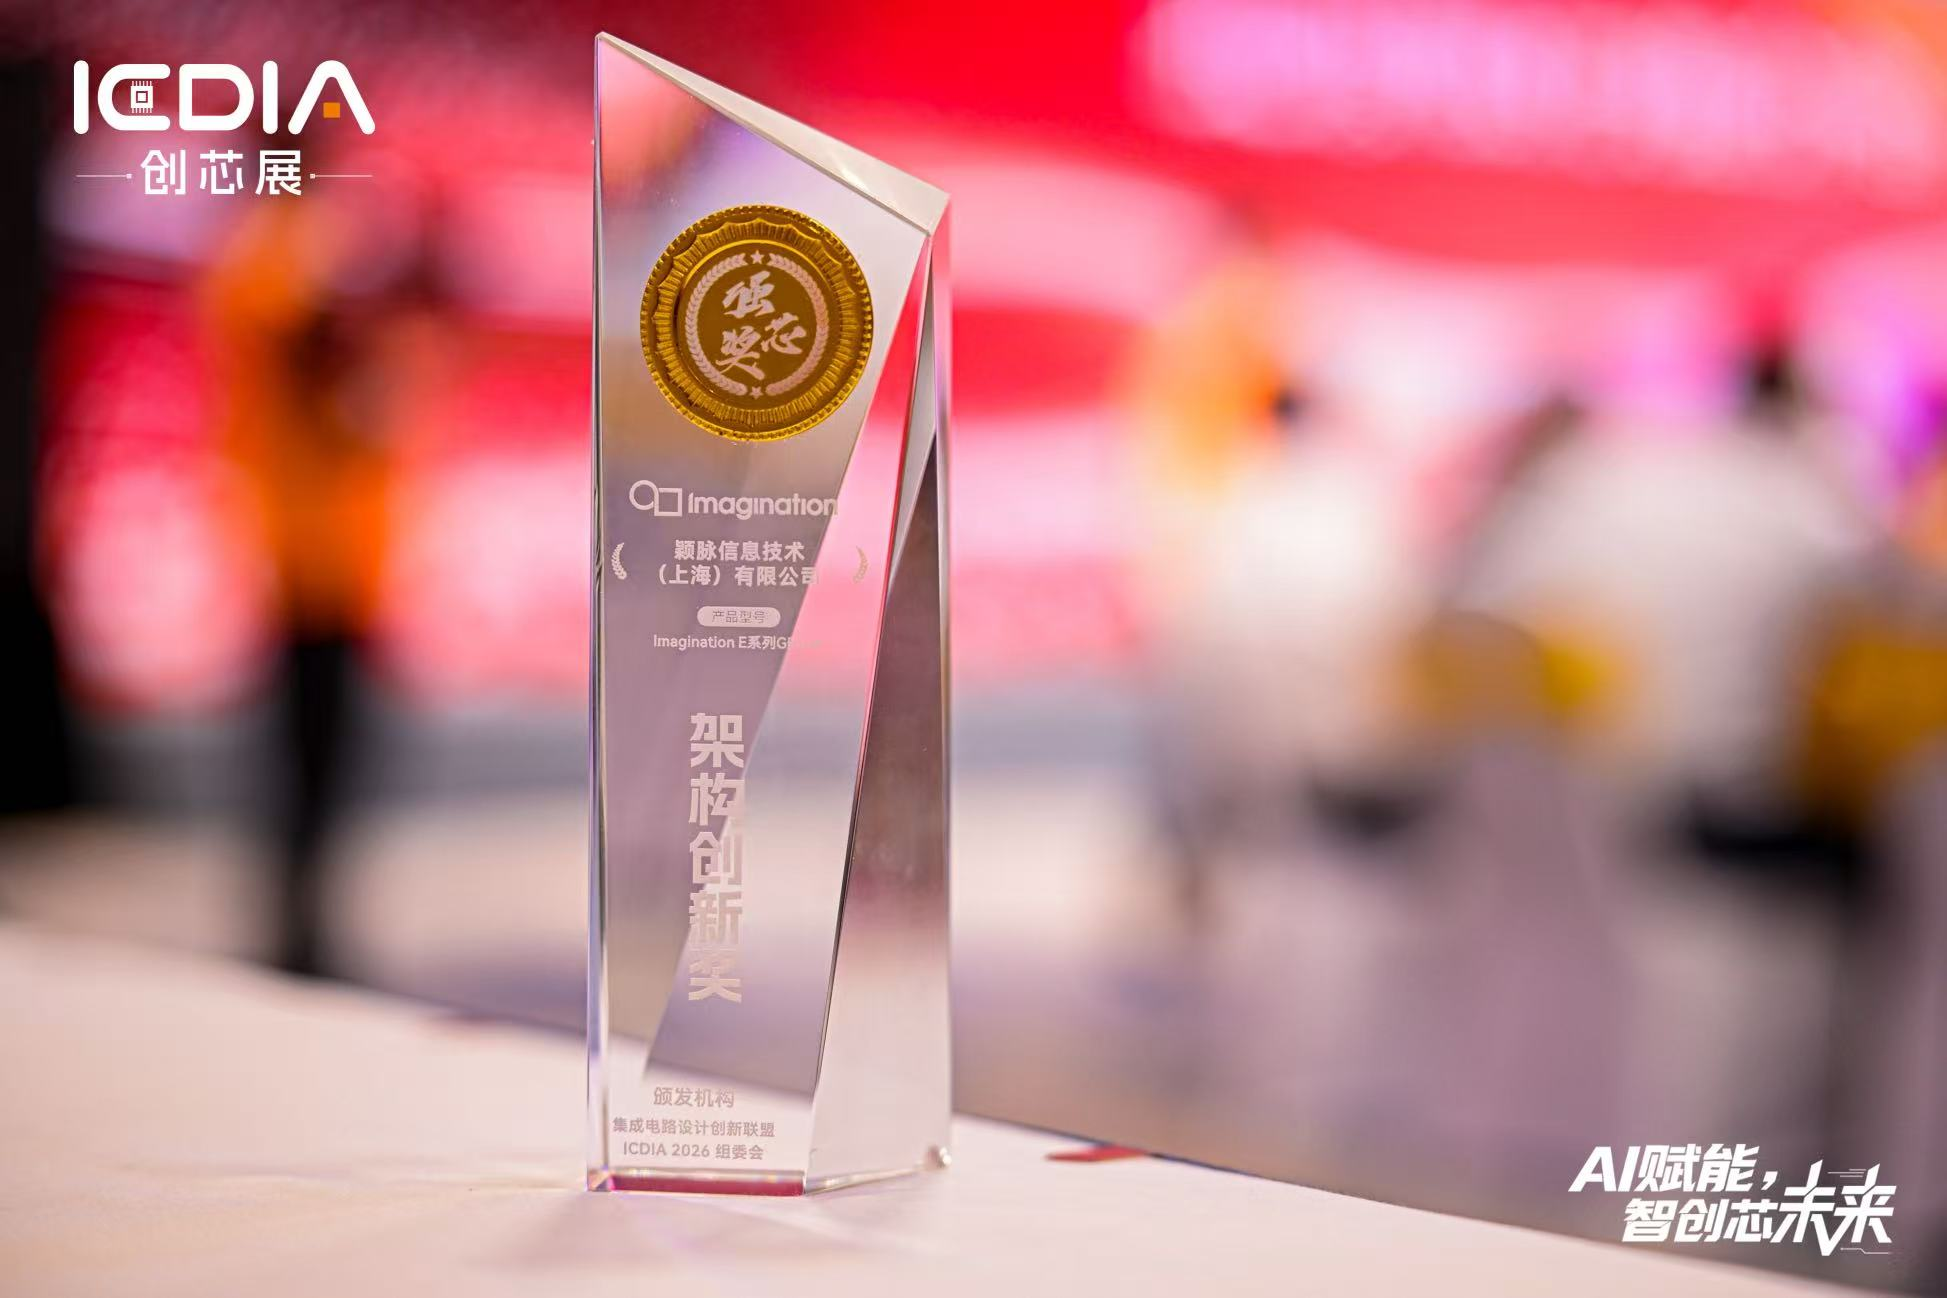
8 月 20 日,第六届集成电路设计创新会议暨应用展(ICDIA 2026)在南京顺利举办,Imagination E 系列 GPU IP 凭借领先的端侧 AI 与图形融合架构创新,成功入选 “2026 强芯 TOP100” 并斩获架构创新奖。同期的具身智能生态论坛上,Imagination 进一步分享了面向机器人领域的 GPU 融合计算加速方案。针对当前物理 AI、具身智能设备普遍存在的算法迭代快、数据搬运功耗高、算力调度冲突、硬件空间散热受限等行业难题,Imagination 创新性提出 GPU 融合可编程 AI 架构,打破传统 GPU、NPU 独立异构的设计模式,以统一可编程算力底座,适配新一代机器人、自动驾驶等端侧智能系统的长期迭代需求。

电源管理 GPU

摩尔线程MusaCoder开源:首个基于国产全功能GPU全栈训练的代码大模型 业界新闻

摩尔线程MusaCoder开源:首个基于国产全功能GPU全栈训练的代码大模型

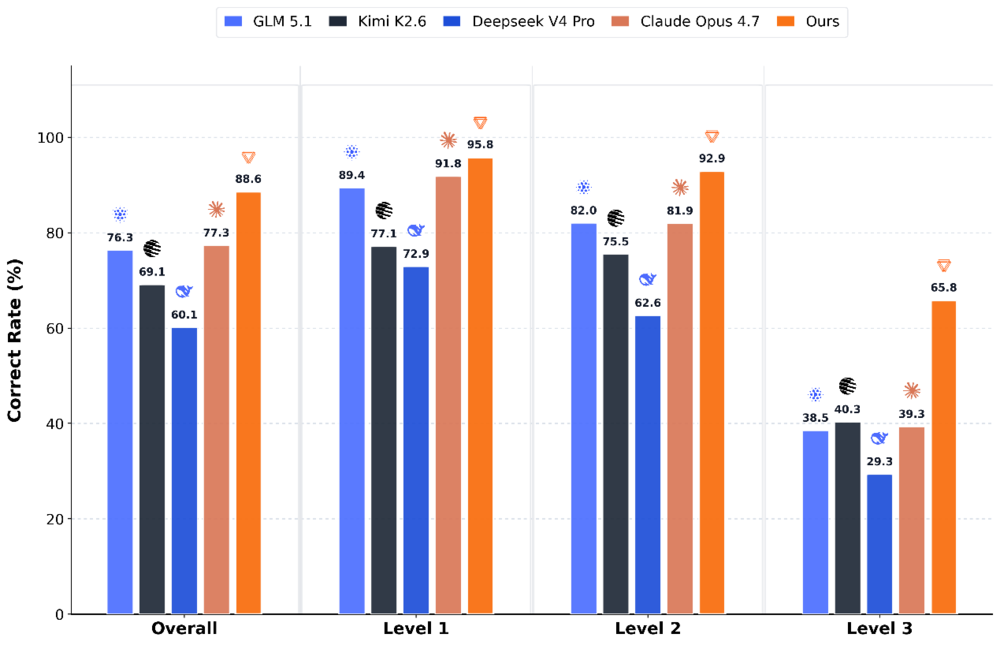
近日,摩尔线程正式发布并开源面向GPU底层算子生成的专用代码大模型MusaCoder。这是业内首个基于国产GPU算力底座完成全链路训练与验证的开源代码大模型,其完整后训练流程均在基于MTT S5000构建的夸娥智算集群上完成。在KernelBench严格评测中,MusaCoder-27B-RL以Overall Pass@8 93.2%、Avg.@8 88.60%的成绩,超越Claude Opus 4.7、GLM-5.1、DeepSeek-V4 Pro、Kimi K2.6等主流SOTA代码模型,展现出在GP

GPU GP(超霸)

摩尔线程实现DeepSeek-V4“Day-0”支持,国产GPU适配再提速 业界新闻

摩尔线程实现DeepSeek-V4“Day-0”支持,国产GPU适配再提速

在国产AI算力加速发展的关键节点,摩尔线程再次取得重要突破。4月24日,该公司宣布其TileLang-MUSA项目实现了对前沿大模型DeepSeek-V4核心算子库的“Day-0”级别支持。这一里程碑式的进展,不仅标志着国产全功能GPU在软件生态兼容性上迈出了坚实一步,也为国产大模型的快速迭代与高效部署奠定了强大的技术基础。

GPU

取消中间转换级:意法半导体800V直转12V/6V方案优化GPU供电拓扑 解决方案

取消中间转换级:意法半导体800V直转12V/6V方案优化GPU供电拓扑

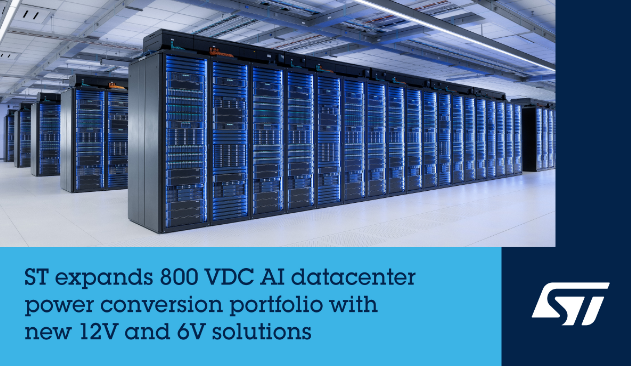
传统的供电方案已难以满足兆瓦级AI机架对能效、功率密度和可扩展性的严苛要求,行业正加速向800V高压直流(800VDC)配电架构演进。为应对这一趋势,意法半导体(STMicroelectronics)近日宣布,基于英伟达(NVIDIA)的800V直流参考设计,正式扩展其电源转换解决方案组合,推出全新的800VDC直转12V和800VDC直转6V两种先进架构。此举不仅是对现有800VDC至50V方案的有力补充,更标志着意法半导体为应对未来AI基础设施的多样化需求,提供了一套覆盖多电压等级的完整生态系统,旨在

电源管理 GPU ST(意法半导体)

推理性能飙升 7 倍:NVIDIA Dynamo 1.0 重塑 Blackwell GPU 生产力 业界新闻

推理性能飙升 7 倍:NVIDIA Dynamo 1.0 重塑 Blackwell GPU 生产力

在数据中心推理需求呈爆发式增长的背景下,NVIDIA 于 GTC 2026 大会上正式推出了开源软件 NVIDIA Dynamo 1.0,旨在为大规模分布式推理构建生产级的基础架构。作为专为“AI 工厂”打造的分布式“操作系统”,Dynamo 1.0 通过与 NVIDIA Blackwell GPU 平台的深度协同,不仅将推理性能最高提升了 7 倍,更通过智能的资源编排与流量控制技术,有效解决了显存限制与资源浪费难题。

GPU Nvidia(英伟达)

欢迎登录

没有账号,

账号注册

注册成功!

3S后自动为你跳转登陆