【导读】端侧 AI 普及之后,平板、IoT 设备多任务越来越多,厂商普遍面临两难:加大 DRAM 会拉高整机 BOM,小内存又容易出现 App 后台被杀、切换卡顿。江波龙自研 HLCache™高级缓存技术,把 DRAM 里的冷数据分流到 UFS 闪存,用存储硬件分担内存压力,不用扩容物理内存就能改善流畅度。近期江波龙与全志科技达成联合测试,在全志 A 系列 AI 芯片平台上,对搭载慧忆微自研主控的 HLCache UFS 完成整机调优。实测结果显示,仅配备 4GB DDR 的设备,开启这项技术后,App 保活率实现翻倍,应用启动速度已经追上常规 6GB 内存机型,为 IoT 与平板厂商提供了低成本优化方案。该方案还支持手机、AI PC 等多类终端,即将在慕尼黑电子展现场演示。
近日,江波龙与全志科技围绕IoT、平板电脑等终端领域的存储技术开展合作。双方基于全志科技A系列高性能AI平台型芯片,完成了搭载HLCache™(High Level Cache)技术的UFS联合测试调优。测试数据表明,该技术方案能够在严格控制DRAM硬件成本的前提下,显著提升IoT及平板电脑等终端设备的系统流畅度与多任务处理能力。
随着端侧AI应用终端加速落地,系统对内存容量与多任务调度的要求持续提升。如何在控制物料清单(BOM)成本的同时保障用户体验,成为终端厂商面临的核心挑战。HLCache™技术旨在通过系统底层优化与高性能闪存的协同,缓解移动端DRAM的容量压力。
在此次联合调优中,江波龙搭载慧忆微自研主控的HLCache™ UFS在全志A系列高性能AI平台型芯片上进行了严苛的实测验证。依托主控芯片的高性能支撑,结果显示,在搭载4GB DDR硬件的条件下,开启HLCache™技术能够带来应用保活率与启动速度的显著提升,整体表现已接近甚至部分超越常规6GB内存机型。
HLCache™技术实测数据与性能表现
应用保活率大幅提升(测试环境:30个国内主流应用)
4GB DDR(未搭载HLCache™):系统保活应用数量为 7个(保活率 23%)。
4GB DDR(搭载HLCache™):系统保活应用数量跃升至 15个(保活率 50%)。
对比验证:常规 6GB DDR(未搭载HLCache™) 的保活应用数量为 11个。
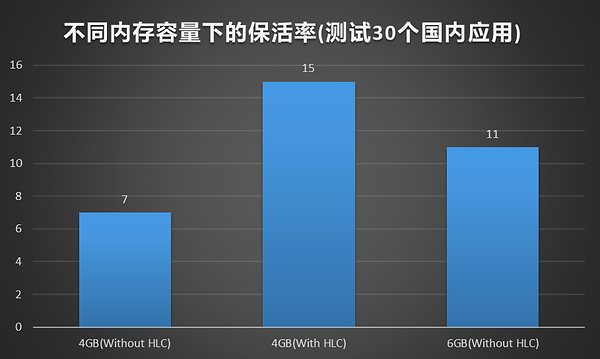
数据表明,在HLCache™技术的加持下,4GB DDR机型的后台保活能力实现了翻倍增长,并超越了未搭载该技术的6GB DDR机型。
应用启动速度接近6GB机型(20个App平均启动时间)
4GB (Host Base):1140 ms
4GB (Host swap):930 ms
4GB (Host swap+UFS优化):850 ms
6GB (Host Base):810 ms
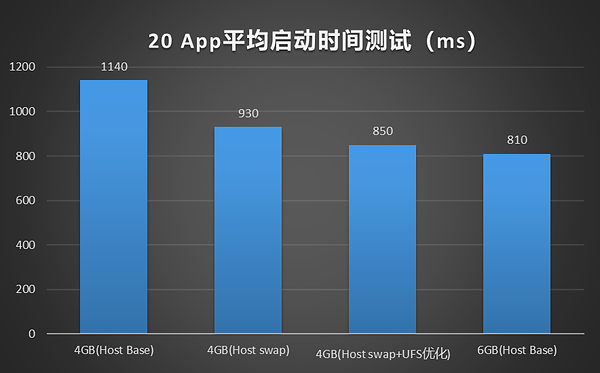
数据表明,经过江波龙HLCache™ UFS与全志平台端联合优化后,4GB DDR机型的平均启动时间(850ms)较基础版本大幅缩短,已高度接近6GB DDR基础机型(810ms)的启动水平。
跨终端布局完善,HLCache™技术展现广泛适用性
HLCache™技术并非仅适用于单一特定场景。目前,该技术方案已经基于UFS、AISSD等高性能存储介质,完成了在智能手机端、PC端、平板电脑及IoT等多类端侧AI设备上的布局。
在与各大主流AI芯片平台侧的联合调优过程中,HLCache™技术均取得了良好的研发进展与优异的测试结果。此次与全志科技在A系列高性能AI平台型芯片上的测试验证,不仅进一步丰富了HLCache™在IoT与平板电脑领域的生态布局,也印证了该技术跨平台、跨介质的适配性与成熟度。
基于这一技术路径,江波龙为行业客户提供了一套具备高效益的端侧AI存储解决方案。通过软件与存储硬件的协同优化,终端厂商能够在不增加物理内存物料成本的前提下,有效减少后台应用进程被强制回收的现象,提升产品生命周期内的操作流畅度,保障用户体验。该技术方案将于11月10日至13日在德国慕尼黑电子展(electronica)期间进行现场演示。
未来,江波龙与平台侧合作伙伴将继续深化在底层存储技术与芯片平台算力方面的联合创新,为全球端侧AI产业提供更具竞争力的软硬件协同存储解决方案。
结论
本次江波龙与全志科技的联合验证,充分印证了 HLCache™技术的实用价值。通过存储与平台软硬件协同,把 UFS 闪存变成 DRAM 的延伸缓存,直接缓解中端设备内存不足的痛点。在 4GB 硬件内存不变的前提下,后台应用保活数量从 7 个提升至 15 个,App 启动耗时大幅缩短,整机体验超越同内存配置机型,甚至优于未优化的 6GB 版本,实实在在帮厂商控制 DRAM 采购成本。目前这项技术已经完成多平台、多存储介质适配,覆盖手机、平板、IoT 等全线端侧 AI 场景。接下来江波龙还会持续和各大芯片平台深化联合研发,持续打磨存算协同方案,为端侧 AI 产业化提供高性价比的存储优化路径。