
【导读】第四届链博会,云尖信息在 NVIDIA 展区发布 R8260 N8 AI Agent 服务器。这款 iPRO 系列 2U 机型搭载 NVIDIA Vera CPU,依托 PCIe 6.0、C2C 一致性互联,主打强单核、高带宽、低功耗,针对性解决 AI Agent 场景 CPU 拖累 GPU、KV Cache 受限等痛点,适配 AI 推理、企业级 Agent、HPC 等业务,兼顾性能与 TCO。
随着大模型、AI Agent业务快速落地,算力行业需求迎来结构性变革。云尖信息iPRO系列服务器搭载超高单线程性能、低延迟超大内存带宽、空间多线程与高能效算力表现的NVIDIA Vera CPU,推出全新2U AI Agent服务器——R8260 N8。该机型通过PCIe 6.0和C2C高速互联技术,实现CPU之间1.8TB/s一致性高速互联与全链路带宽跃升,充分释放NVIDIA Vera CPU算力潜能,可精准适配云原生部署、企业级应用、高性能计算(HPC)、AI推理、AI Agent等核心业务。
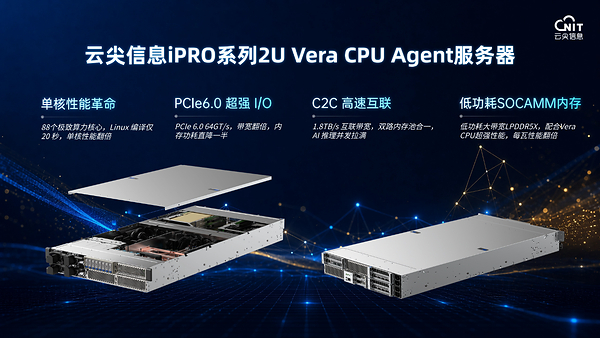
全新架构:重塑Agentic AI算力底座
01更强单核,跑通Agentic AI关键路径
R8260 N8凭借NVIDIA Vera CPU的优势,让每一份机柜空间与功耗预算都产出更高的业务价值,打破了传统服务器一味堆核的思维定式。Vera CPU今年5月首轮实测结果显示:Linux内核编译仅需20秒,创下单路处理器行业纪录;在数据库、视频编码等多项测试场景中,是本次测试CPU中最快成绩。
02更高带宽,多路并行不拥堵、AI推理不降速
R8260 N8拥有88条PCIe 6.0通道,可支撑多GPU、多NVMe SSD、多高速网卡满载并行,支持CXL 3.1跨节点内存池化;搭配低功耗(仅50W)高带宽LPDDR5X内存子系统以及双路800GNVIDIA ConnectX-8 SuperNIC智能网卡,大幅提升整机数据吞吐能力。同时通过C2C一致性互联整合两颗Vera处理器的内存资源,构建176核+3TB大容量内存 AI推理引擎,实现KV Cache容量有效扩容,降低跨槽调度损耗,大幅提升AI Agent端到端响应效率。
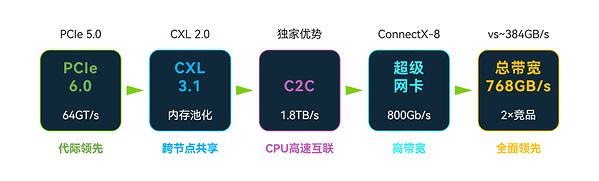
03超低功耗:有效控制TCO
电力是数据中心长期运营的核心支出,直接决定企业AI业务规模化落地的成本门槛。R8260 N8通过芯片、内存、系统三重架构革新,将各CPU及其配套内存系统的功耗控制在高度优化的水平,实现单机每瓦性能翻倍,让同等电力资源可承载双倍算力输出,大幅降低企业电费开销,有效缩减数据中心整体TCO。
整机设计:让芯片能力真正落地
R8260 N8在标准2U空间内完成模块化重构,从散热、供电到运维管理全链路优化,确保Vera CPU的原生能力在大规模集群中持续、稳定地转化为业务生产力。
强悍性能匹配Agent负载:整机可配置1张BF3高性能智能网卡承担数据卸载功能,同时支持选配2张600W GPU、1至2张NVIDIA ConnectX-8 SuperNIC高速网卡,以及E1.S/M.2多形态NVMe高速存储,充分匹配Agent业务中KV Cache、高频I/O访问的负载特征。
智能化分布式运维:创新SMA分布式管理架构,打破传统I2C管理总线速率低、易冲突、单点故障整机失联的短板,固件更新速度实现百倍提升。
7×24稳定运行基础:极致散热风道调优、结构布局优化与冗余电源设计,保障大规模智能体集群不间断业务运行。标准2U机身可直接利旧客户现有机房快速部署,无需改造基础设施。
从芯片架构到整机设计,R8260 N8做的不是简单堆砌参数,而是把新一代处理器的算力,真正转化为AI Agent业务可稳定获取的实际生产力。
业务价值:面向Agentic AI的端到端收益
R8260 N8是面向Agentic AI时代的专用算力产品。它精准抓住了Agent流水线中"CPU进入关键路径、GPU算力被CPU拖慢"的核心矛盾,通过超高内存带宽、空间多线程、高性能单线程三大核心能力,从系统层面优化CPU与GPU的协同效率。
对于Agentic AI业务,R8260 N8的核心价值不在于单纯的CPU跑分,而在于任务级的端到端收益:更低的任务延迟、更高的GPU利用率以及更低的单任务总成本。随着Agent应用从原型验证走向规模化生产部署,这类面向Agent优化的服务器将成为AI算力基础设施的关键组成部分。
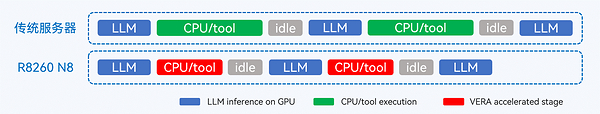
结论
总的来说,云尖信息 R8260 N8 不是一款简单堆料的通用服务器,而是面向 Agentic AI 时代量身打造的专用算力硬件。它抓住 AI Agent 业务里 “CPU 进入关键路径、GPU 算力被 CPU 拖累” 的行业痛点,依托 NVIDIA Vera CPU 的强单核、高带宽、高能效特性,搭配 C2C 一致性互联、PCIe 6.0 高速通道、LPDDR5X 内存子系统,扩容 KV Cache、减少跨槽调度损耗,实现 CPU 与 GPU 协同效率的系统性优化。